
MCP サーバー
AI エージェント向け transcript.im MCP サーバー
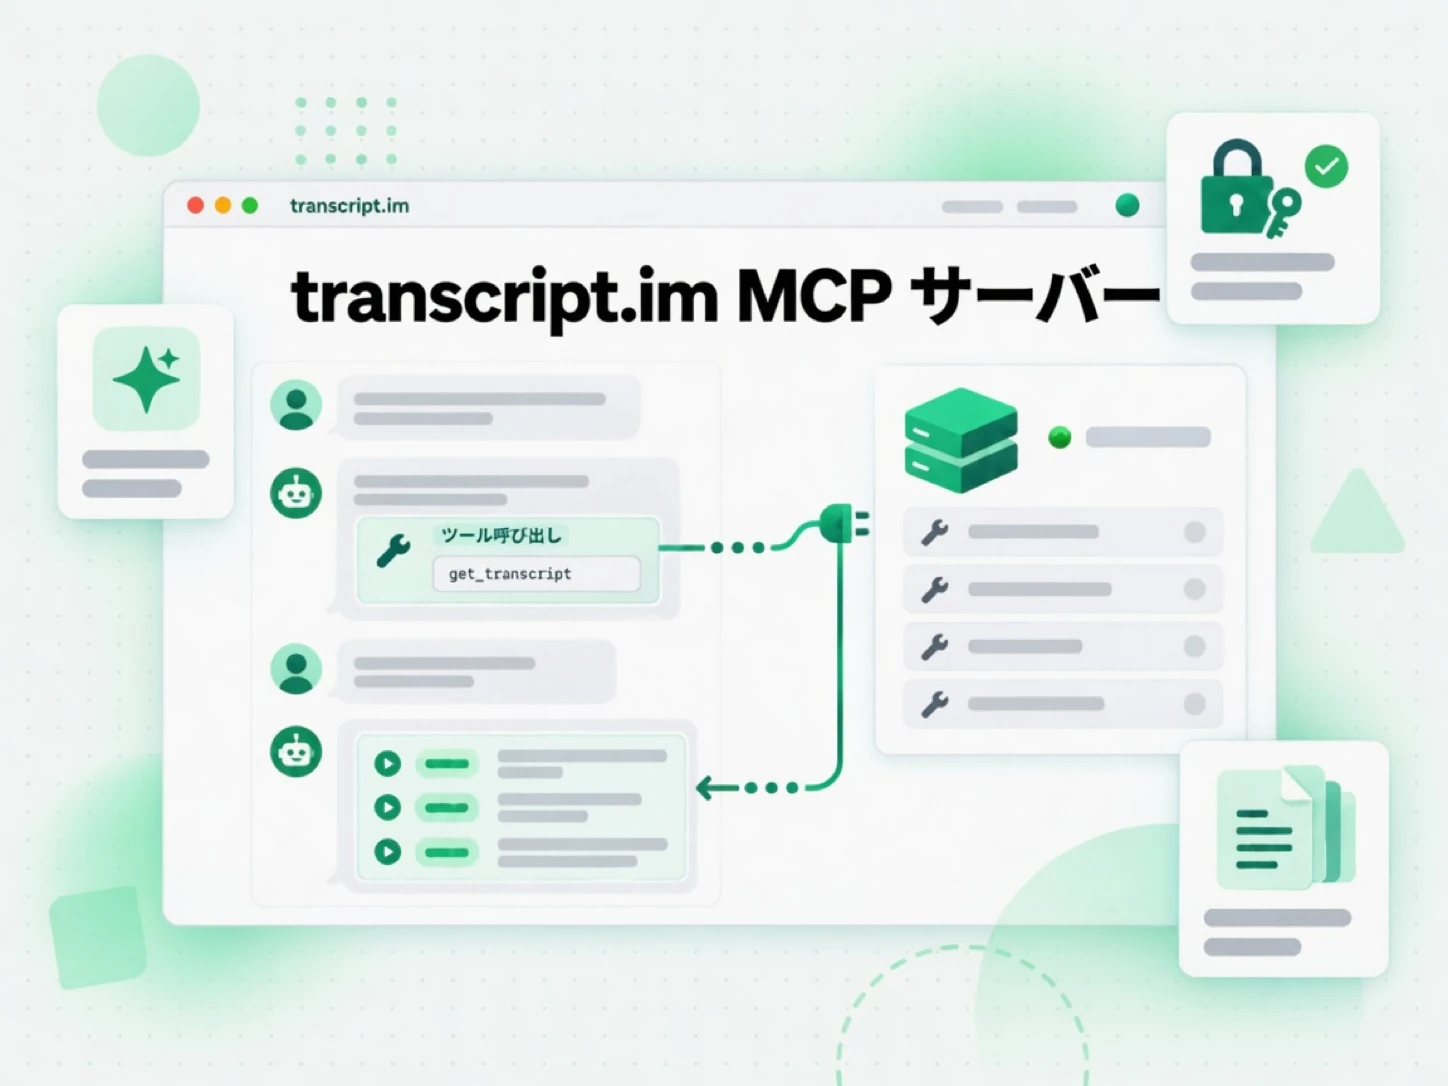
transcript.im MCP サーバーは、AI クライアントが直接呼び出せる文字起こしツールを提供します。Claude、ChatGPT、Cursor、OpenAI Agent Builder をサーバーに向け、API キーを渡すだけで、モデルは公開リンクから文字起こしを取得し、バッチを開始し、字幕を書き出し、YouTube を検索できます。ブラウザも独自の連携も不要です。リモート HTTP エンドポイントなので、ホスト型クライアントに必要なのは URL とキーだけであり、ローカルへのインストールは不要です。
https://mcp.transcript.im/mcpのリモートエンドポイント 1 つ。API キーで認証し、インストールするものはありません。- 文字起こし、バッチ、書き出し、YouTube 検索、利用状況のための 11 のツール。
- AI ツールは含みません。モデルはすでにクライアント側で動いており、サーバーは文字起こしとプラットフォームのデータを提供します。
- REST API ですでに使っているのと同じアカウント、同じ抽出パイプライン。
- 長い文字起こしはページトークンで分割され、1 つの結果がコンテキストウィンドウをあふれさせません。
transcript.im MCP サーバーが行うこと
Model Context Protocol を使うと、クライアントはサーバーが公開したツールを検出して呼び出せます。transcript.im MCP サーバーはその面を 1 つの仕事に使います。公開された動画や音声のリンクを文字起こしに変え、その周辺のプラットフォームの問いに答えることです。クライアントは URL を添えて get_transcript を呼び出します。サーバーは transcript.im の抽出パイプラインに到達し、作成者の字幕があれば使い、なければ AI 文字起こしに切り替えます。
- ツールとしての文字起こし抽出:1 回の呼び出しでリンクがタイムスタンプ付きテキストになります。
- YouTube 検索も:動画やチャンネルを検索し、チャンネルを解決し、アップロードとプレイリスト項目を一覧し、字幕メタデータを読み取ります。
- バッチと書き出し:多数のリンクをキューに入れ、完成したセットを書き出します。
- 中にモデルはなし:サーバーはデータを返し、クライアントがその扱いを決めます。
エージェントが呼び出せるツール
文字起こし
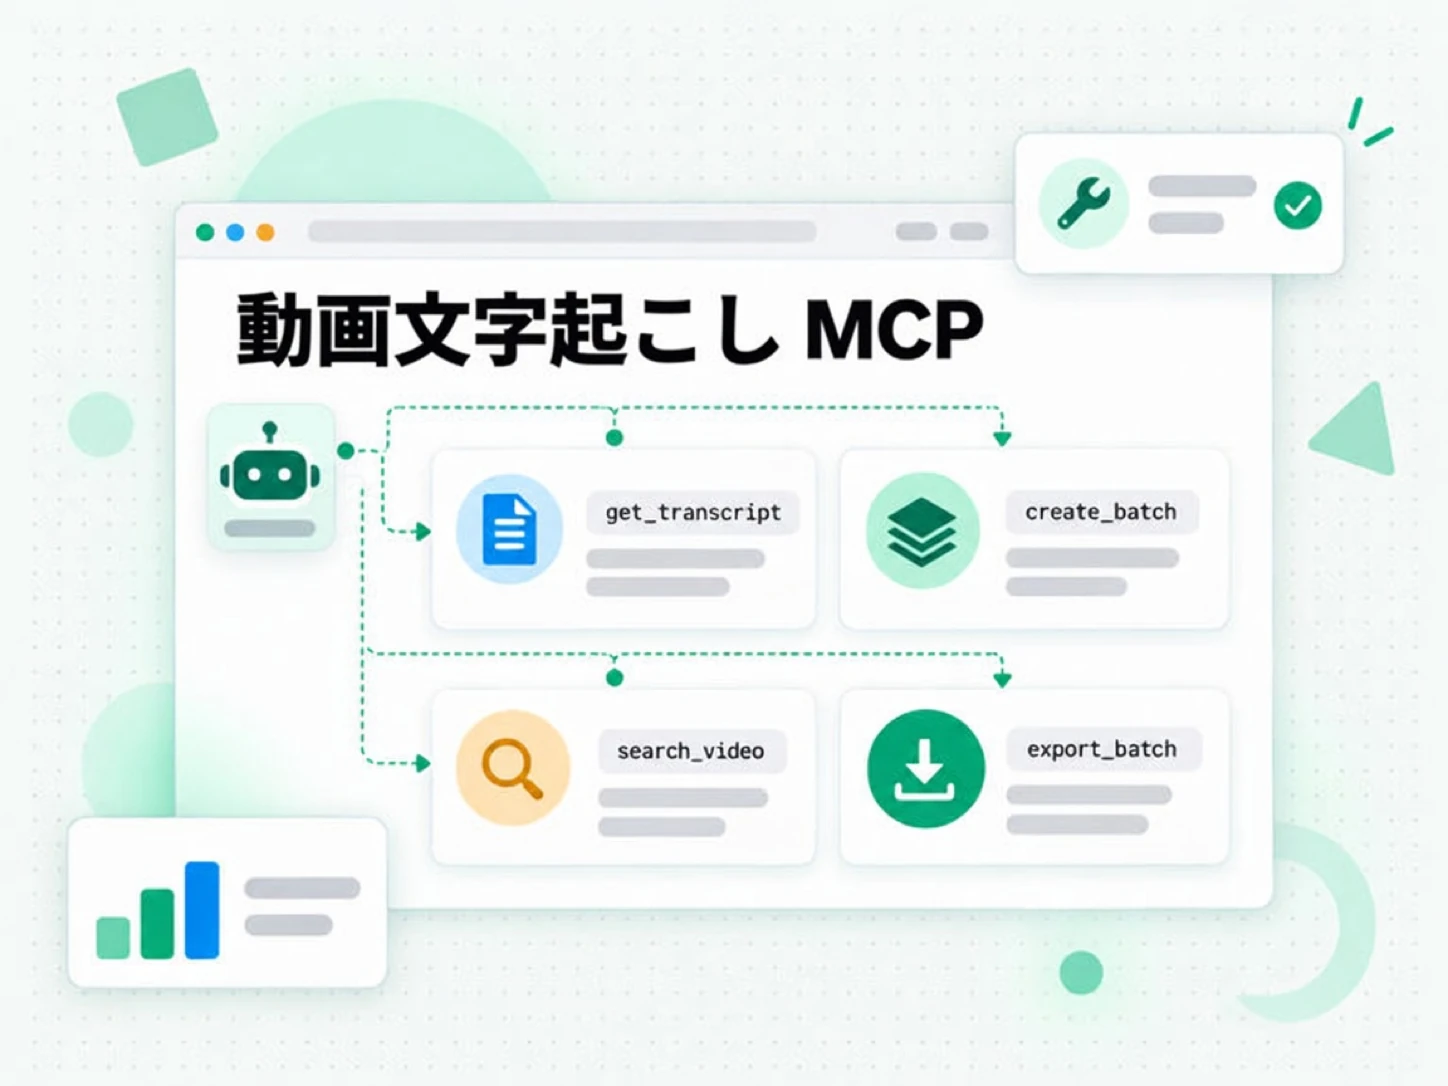
get_transcript は URL から文字起こしを抽出し、長いものでは次のブロックを読み取ります。get_transcript_info は、抽出を決める前に動画のメタデータと API が解決できる字幕トラックを返します。2 つを組み合わせることで、エージェントは動画を文字起こしする価値があるか判断し、本当に必要な言語の優先順位を指定し、タイムスタンプ付きまたはなしでテキストを取得できます。
バッチと書き出し
create_batch は URL リスト、プレイリスト、チャンネルから実行を開始し、get_batch はステータス、件数、次の項目ページを報告し、export_batch は完了したバッチをテキストまたは字幕に変換します。エージェントが 1 本ずつではなく作成者のバックログ全体を処理する方法であり、失敗したリンクは残りを捨てずに個別に報告されます。
YouTube 検索
search_video はトピックで動画やチャンネルを探し、get_channel はハンドルや URL を解決し、list_channel_video はチャンネルのアップロードを一覧し、list_playlist_item はプレイリストをたどり、list_caption は動画の字幕メタデータと文字起こし本文を読み取ります。エージェントがニッチを調べ、作成者が何を公開しているか確認し、文字起こしする前に適切なソースを選ぶためのツールです。
アカウント
get_usage はアカウントの利用状況の概要を返すので、エージェントは大きなバッチや長いチャンネルに踏み込む前に、すでに何を使ったかを確認でき、実行の途中で上限に気づく事態を避けられます。
すでに使っているクライアントを接続する
Claude
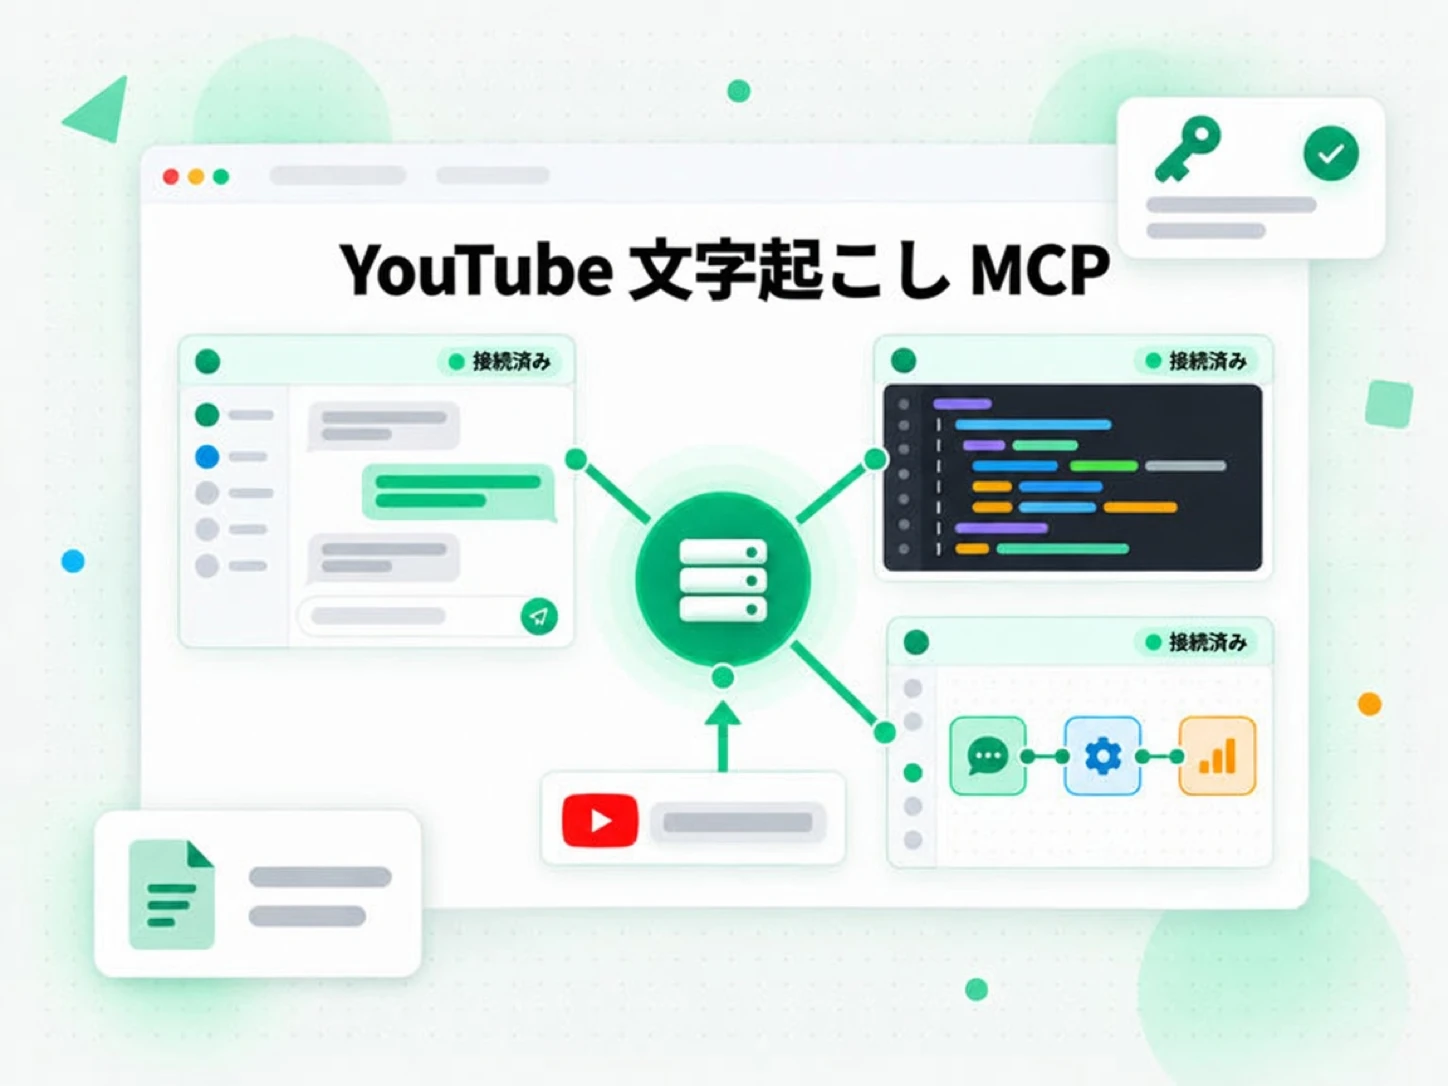
リモートサーバーをカスタムコネクタとして追加するか、コマンドラインから登録します。Claude は MCP サーバーとネゴシエートし、そのツールを会話に公開してターンをまたいで利用可能に保つので、自然な言葉で文字起こしを頼み、リンクを繰り返さずに続けて要約を頼めます。
ChatGPT
MCP コネクタを追加し、API キー認証を選びます。すると ChatGPT は他の接続アプリと同じように文字起こしツールを呼び出すため、チャットに貼った動画リンクが、モデルが引用・翻訳・分析できる読めるテキストになります。
Cursor とその他のエディタ
エディタの mcpServers 設定を API キーとともにリモート URL に向けます。エディタのエージェントはリンクを文字起こしし、結果をプロジェクトやノートに直接書き込めます。
OpenAI Agent Builder
サーバー URL と Bearer 資格情報を指定して MCP ツールを追加すると、エージェントは文字起こしをより大きなワークフローの 1 ステップとして使い、独自コネクタなしで次の処理へテキストを渡せます。
接続と認証
サーバーはリモート HTTP エンドポイントなので、クライアントの接続はインストールではなく URL とキーです。
- リモート HTTP:MCP クライアントに
https://mcp.transcript.im/mcpを追加します。自分のマシンで動かすものはありません。 - API キー:キーを
Authorization: Bearer <key>またはx-api-keyとして送ります。サーバーがそれを REST API に転送するため、同じアカウントと権限が適用されます。 - ツール検出:エンドポイントは MCP の検出リクエストに応答するので、クライアントは呼び出す前に公開されたツールを列挙できます。
- 同じ結果:ツール、分割、エラーは同じアカウントが REST API から受け取るものと一致するため、動作はクライアントに依存しません。
長い文字起こしを扱いやすく
2 時間の録音は、モデルが 1 つのツール結果として受け取るには多すぎるテキストを生みます。そこでサーバーは長い文字起こしを区切ったブロックで返します。各ブロックは truncated: true と不透明な nextPageToken を報告し、そのトークンだけで get_transcript を再度呼ぶと次のブロックが返り、エージェントは文字起こしを使い切るまで繰り返します。
- 区切られた結果:各ブロックに上限があるため、1 つの結果がコンテキストウィンドウをあふれさせたり、以前の推論を押し出したりしません。
- ステートレスなページング:トークンが位置を運び、呼び出しの間にサーバーセッションを保持しないので、どのレプリカでも次のブロックを返せます。
- JSON ページング:JSON の文字起こしはセグメント単位でページングするため、構造化された利用側は期待するスキーマを保ったままテキストをたどれます。
- ジョブのポーリング:字幕のない動画はジョブ ID を返し、エージェントは文字起こしが準備できるまでポーリングします。
- 読める冒頭:最初のブロックだけで冒頭に関する問いに答えられるので、短い追問が文字起こし全体を取得する必要はありません。
エージェントが対応できるエラー
ツール呼び出しが失敗すると、サーバーはスタックトレースではなく読めるテキストの MCP エラーを返します。構造化された詳細が結果とともに運ばれるので、エージェントは推測せずに復帰できます。code、HTTP status、上限に達したときの upgradeUrl、要求した言語がないときの availableLanguages です。これにより行き止まりが次の行動に変わります。別の言語を試す、別のリンクを選ぶ、会話中の人に上限を伝える。失敗の理由を読めるモデルは次の試行を自分で修正でき、これが有益に再試行するエージェントと、壊れた同じ呼び出しをループするエージェントの違いです。
関連
MCP サーバー FAQ
transcript.im MCP サーバーとは何ですか?
transcript.im MCP サーバーは、文字起こしの抽出、バッチジョブ、書き出し、YouTube 検索を、AI クライアントが呼び出せるツールとして公開する Model Context Protocol の面です。
transcript.im MCP サーバーに接続できるクライアントは?
Claude、ChatGPT、Cursor、OpenAI Agent Builder、その他の MCP クライアントが、API キーを使ってリモート HTTP エンドポイントに接続できます。
transcript.im MCP サーバーには AI ツールが含まれますか?
いいえ。サーバーは意図的にデータと抽出ツールだけを公開します。結果を要約したり書き直したりするモデルは、すでにクライアント側で動いているためです。
エージェントは動画リンクからどうやって文字起こしを取得しますか?
リンクを添えて文字起こしツールを呼び出します。サーバーは既存の字幕を先に使い、なければ AI 文字起こしに切り替え、タイムスタンプ付きのテキストを返します。
MCP サーバーは長い文字起こしをどう扱いますか?
区切ったブロックで返します。各結果に切り捨てのフラグとページトークンが付き、エージェントはそのトークンでツールを再度呼び出して次のブロックを読みます。
エージェントは transcript.im MCP サーバーでバッチを実行できますか?
はい。バッチツールは URL リスト、プレイリスト、チャンネルを受け取り、ステータスと件数を報告し、完成したセットをテキストまたは字幕として書き出します。
transcript.im MCP サーバーは YouTube 検索とチャンネルに対応しますか?
はい。専用ツールが動画とチャンネルの検索、チャンネルの解決、チャンネルのアップロード、プレイリスト項目、字幕メタデータを扱います。
MCP サーバーはクライアントをどう認証しますか?
API キーを Bearer トークンまたは x-api-key ヘッダーとして受け取り、REST API に転送します。そのため呼び出しは直接の API リクエストと同じアカウントに届きます。