
REST API
動画と音声のための文字起こし API
transcript.im は、製品を支えるのと同じ抽出パイプラインをバージョン付きの文字起こし API として公開しています。動画または音声の URL を送ると、JSON またはプレーンテキストでタイムスタンプ付きのテキストが返り、プラットフォームは自動で判定されます。既存の字幕があればそれを優先し、動画に字幕がなければ AI が音声を文字起こしし、結果は非同期で届きます。
- 1 つの
urlが完全なリンクでも短縮リンクでも受け取り、YouTube、TikTok、Instagram、LinkedIn、Twitter/X を判定します。YouTube は動画 id だけでも認識し、すでに把握しているソースならplatformとexternalIdで指定できます。 - 字幕を優先して使い、動画に字幕がなければ AI が話し声を文字起こしします。ローカルファイルのアップロードは常に音声認識を通ります。
format=jsonはタイムスタンプ付きのセグメントを返し、format=textは貼り付けるだけで使えるプレーンテキストを返します。- バッチ抽出は URL リスト、再生リスト、チャンネルに対応します。
- バッチのエクスポートは txt、csv、json、srt、vtt、zip に対応し、保存した文字起こしは txt、srt、vtt、json、md でダウンロードできます。
- 保存した文字起こしはアカウントのライブラリに置かれ、YouTube の探索は検索、動画、チャンネル、アップロード、再生リスト、字幕に対応します。
- 完全なコントラクトは OpenAPI ドキュメントとして公開されています。
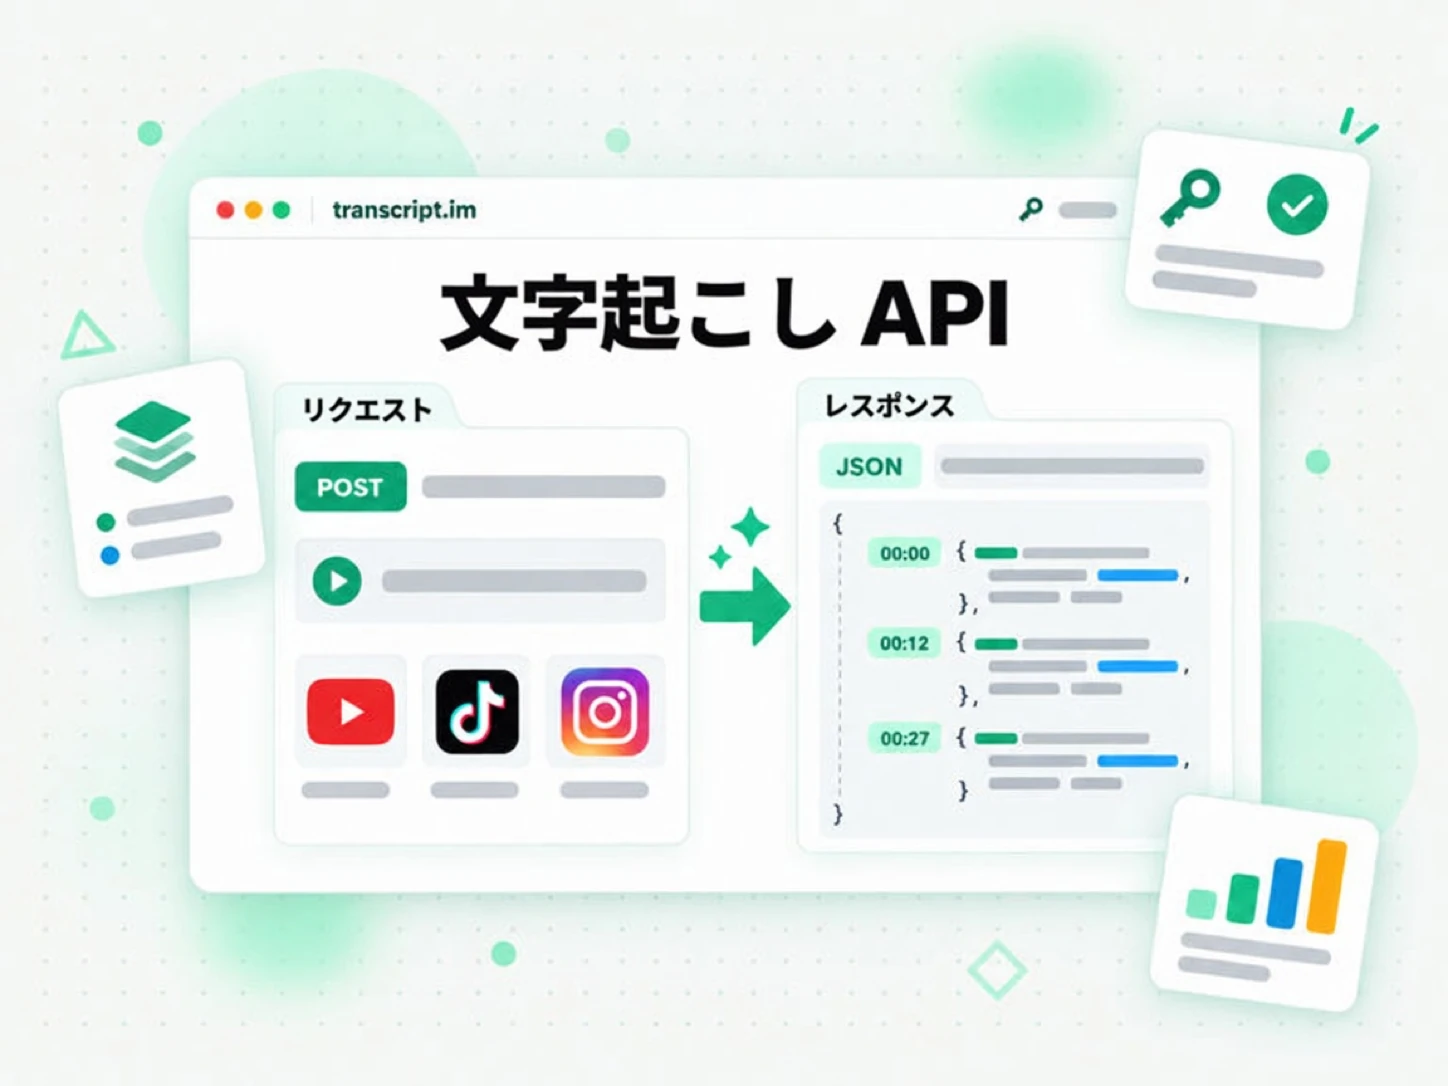
transcript.im API でできること
transcript.im API は、公開された動画または音声のリンクを、あなたの製品が読み、保存し、検索し、モデルに渡せるタイムスタンプ付きの文字起こしに変換します。URL を送ると、API がプラットフォームを判定し、クリエイターがすでに持つ字幕トラックを探して、すべての行にタイムスタンプが付いた文章を返します。動画に字幕がまったくなくても、API はエラーで止まらず、話し声の AI 文字起こしに切り替えるので、同じリクエストがそのままテキストを生み出します。
- 1 回のリクエストで本物のテキスト — リンクを解決し、タイムスタンプ付きの文字起こしセグメントまたはプレーンテキストを返します。
- 字幕が先、AI が次 — クリエイターのトラックがあれば使い、なければ音声を文字起こしします。
- ASR は既定で非同期 — job id があれば、長い文字起こしを止めずに照会できます。
- 言語を認識 — 言語の優先順位を指定し、API が解決した言語を読み取れます。
- プラットフォーム非依存 — 呼び出し側は動画がどこでホストされているかを知る必要がありません。
5 つのプラットフォームに対応する 1 つの文字起こし API
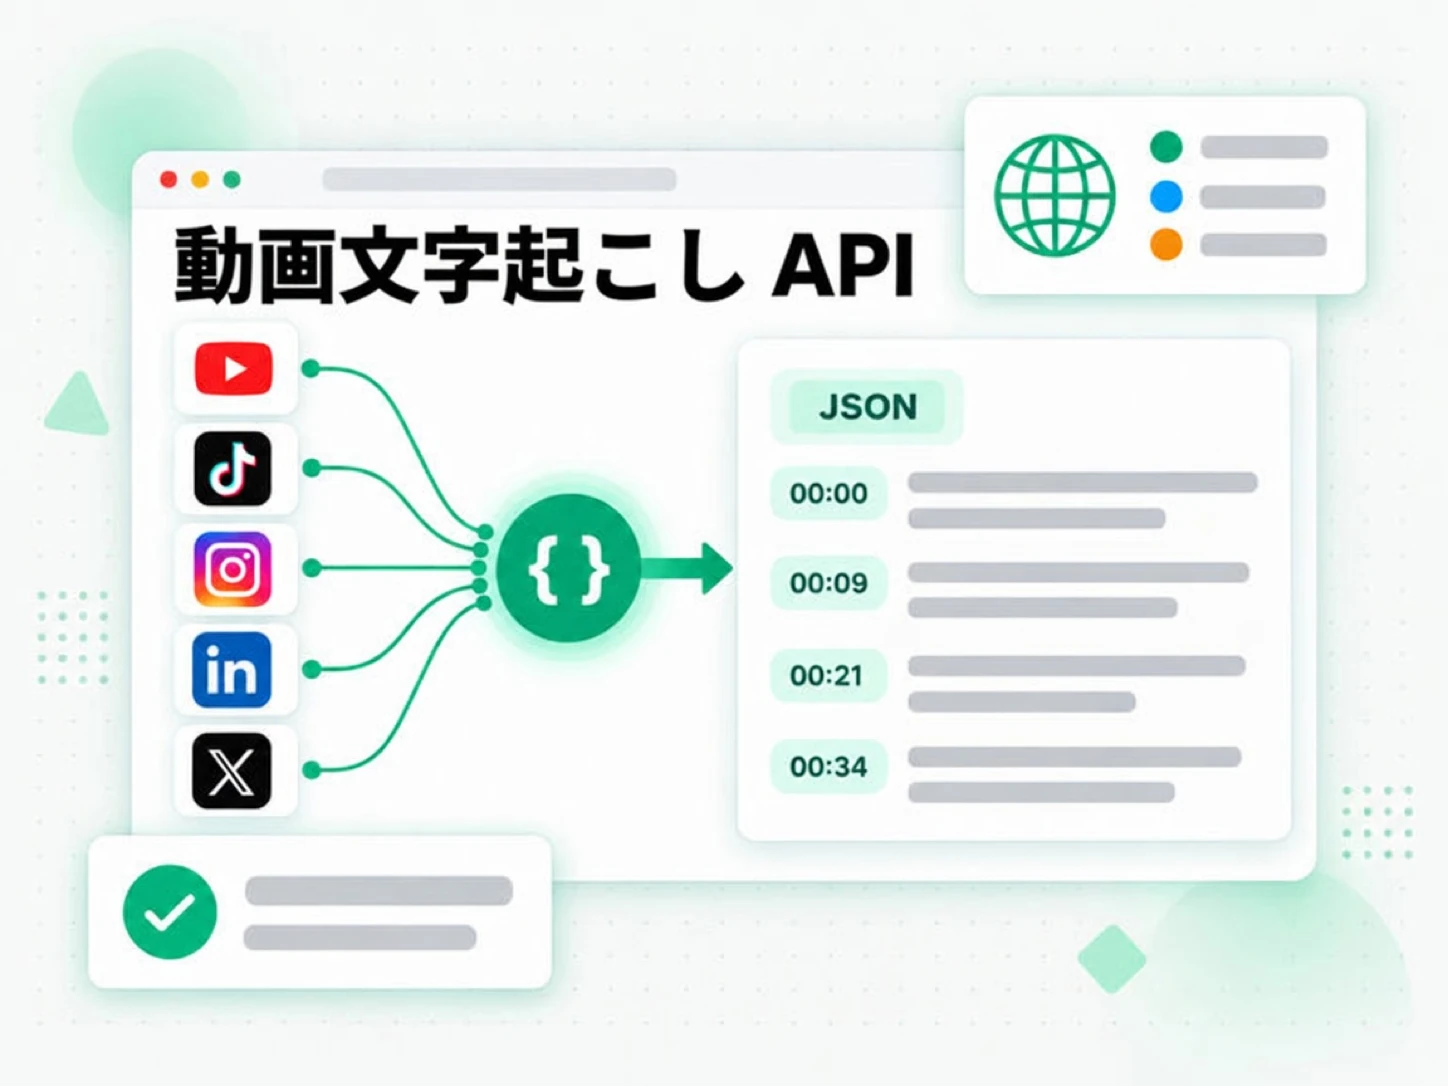
YouTube
公開された YouTube 動画、ショート、ライブ録画の文字起こしを、クリエイターの字幕を優先し、字幕がなければ AI 文字起こしで提供します。YouTube はさらに、検索、動画、チャンネル、アップロード、再生リスト、字幕という完全な探索の窓口を持つプラットフォームで、文字起こし自体とあわせて利用できます。チャンネルのたまりや再生リストはタイムスタンプ付き文字起こしのバッチになり、1 つのリンクは検索できる読みやすいテキストとして返ります。
TikTok
公開された TikTok 動画の文字起こしを、字幕を優先し、音声認識を代替として提供します。動画リンクを貼り付けると、話された内容をそのまま再利用、翻訳、引用できる、きれいなタイムスタンプ付きテキストとして読めます。同じ呼び出しが短いクリップも長めのアップロードも扱うので、トレンドもチュートリアルも顔出しトーク動画もテキストとして返ります。
公開された Instagram のリールと動画投稿の文字起こしです。Instagram には読める字幕トラックがないため、抽出は非同期の音声認識になります。リンクを送り、ジョブを照会し、準備できたらテキストを受け取ります。これにより、プラットフォームが言葉をテキストとして公開したことがなくても、リールを引用して検索できます。
公開された LinkedIn の動画投稿の文字起こしを、字幕を優先し、音声認識を代替として提供します。結果はタイムスタンプ付きで返るので、講演、製品クリップ、録画した会議が、引用して再利用できる検索可能なテキストになります。ウェビナー録画から論点を抜き出したり、創業者の近況を編集できる下書きに変えたりできます。
Twitter/X
公開された X の動画投稿の文字起こしです。X には読める字幕トラックがないため、抽出は非同期の音声認識を通ります。リンクを送り、ジョブを照会し、検索できるタイムスタンプ付きテキストを受け取ります。投稿が編集または削除される前に、動画を正確に引用したり、話された内容を保管したりできます。
文字起こしリクエストの流れ
1 回の呼び出しが、リンクまたはアップロードしたファイルを入力から文字起こしまで運び、API がどの経路を通ったかを教えます。
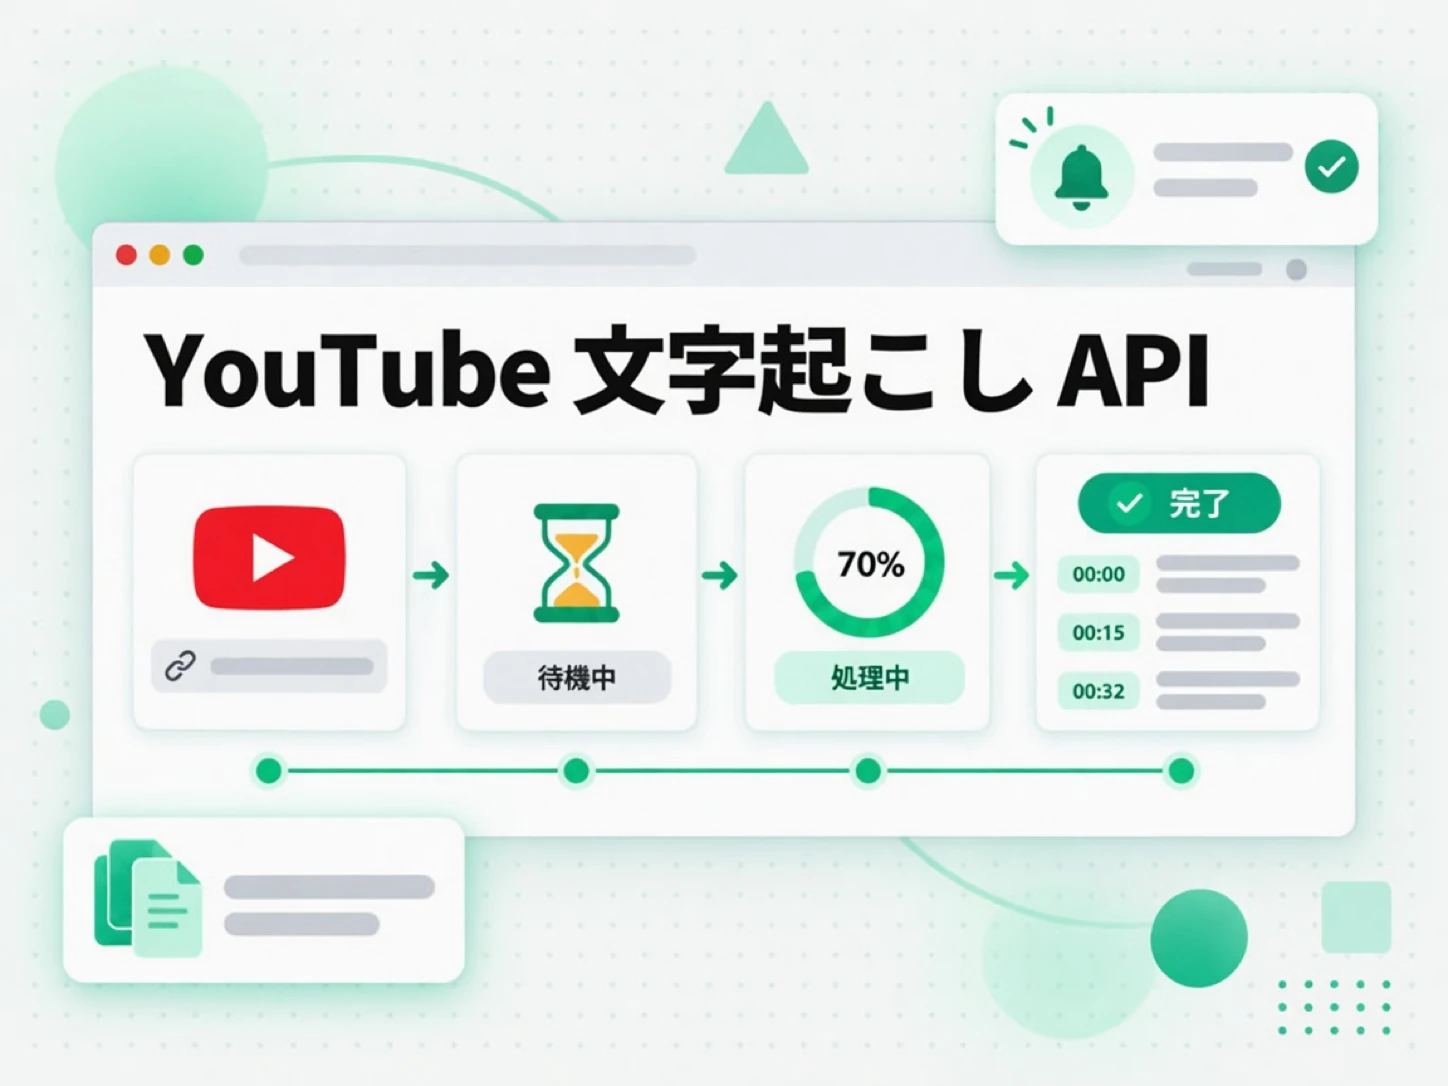
- ソースを送る —
urlを送り、すでに把握していればplatformとexternalIdを渡し、あるいは同じエンドポイントにファイルをmultipart/form-dataでアップロードします。 - 字幕の一致を得る — 動画がリストにある言語の字幕を持っていれば、文字起こしが応答として返ります。
- 言語の不一致を処理 — 字幕はあるがリストに合うものがない場合、リクエストは AI 文字起こしへ進み、job id とともに
202を返します。availableLanguages付きの404は、呼び出し側に音声認識が許可されていないときだけ返ります。 - ASR を強制または代替 — 明示的な
asr項目、字幕トラックがまったくない動画、アップロードしたファイルは ASR ジョブを開始し、job id を返します。 - 照会またはストリーム —
GET /v1/transcript/job/{id}で成功または失敗まで読み取るか、/eventsストリームを購読してサーバー送信の進捗を受け取ります。ジョブ照会は失敗したジョブでも200を返すので、statusフィールドで分岐します。 - 結果を読む — 完了した文字起こしには、解決された言語、長さ、タイムスタンプ付きセグメント、要求時にはタイトル、作成者、公開日などのメタデータが含まれます。
- 安全に繰り返す — すでに抽出済みの文字起こしは新しいジョブを開始せずキャッシュから返るので、同じソースを再度リクエストできます。
- 先に調べる —
GET /v1/transcript/infoがソースを解決し、抽出を決める前に提供できる言語を一覧にします。
202 を返し、本当に存在しない資産や許可されていない代替は 404 を返します。テキストの準備ができれば、どの経路も同じ文字起こしの形を返します。バッチ抽出とエクスポート
実際のワークロードは 1 本の動画で終わることはまれなので、API はバッチを URL リスト、再生リスト、チャンネルとして受け取ります。各バッチは独自の集計 — 保留中の件数、成功した件数、失敗した件数 — を追跡し、項目をページ単位で返すので、長いチャンネルが 1 つの巨大なペイロードとして届くことはありません。
- 3 つのバッチ形態 —
POST /v1/batchは、送るボディに応じて URL リスト、再生リスト、チャンネルを受け取ります。 - 独立したステータス — 失敗したリンクは個別に印を付けられ、バッチの残りを決して破棄しません。失敗した項目は
/retryで再試行できます。 - ページ単位の項目 —
GET /v1/batch/{batchId}でバッチを読み、返されたページトークンをたどって残りの項目を取得します。 - ライブの進捗 — 照会のたびに更新された件数が返るので、呼び出し側は長い実行がどこまで終わったかを示せます。
- 好きな形式でエクスポート — 完了したバッチを
/exportからtxt、csv、json、srt、vtt、zipでダウンロードします。
srt と vtt のエクスポートをそのままエディターやプレイヤーに入れられます。アーカイブなら、csv、json、zip が録音ライブラリ全体を 1 つのコーパスとして検索可能に保ちます。形式は単一の文字起こしレスポンスと揃っているので、1 つの結果を扱える利用者はすでにバッチの読み方を知っています。アカウントのライブラリに保存された文字起こし
抽出と保存は別ものです。文字起こしは保存された時点でアカウントのライブラリの一部になり、ライブラリは後から抽出を再実行せずに読み、検索し、ダウンロードし、削除する場所です。
- 保存内容を一覧 —
GET /v1/library/transcriptsがアカウントの文字起こし、バッチ記録、失敗履歴の行をページ単位でたどり、検索、プラットフォームと言語のフィルター、並べ替えに対応します。 - 1 つの項目を読む —
GET /v1/library/transcripts/{platform}/{externalId}がプラットフォームと外部 id で保存した文字起こしを、または指定した言語で返します。 - ダウンロード —
/downloadルートが保存した文字起こしをtxt、srt、vtt、json、mdとしてエクスポートします。 - 関連コンテンツ —
/relatedルートが同じチャンネルの他の保存項目を一覧にします。 - 削除 —
DELETEが他の人のコピーには触れずにライブラリから項目を外します。 - アカウント範囲の読み取り — ライブラリへのリクエストはアカウントが保存したものだけを返し、新しい抽出を決して開始しません。保存した文字起こしを見返すのは読み取りであり、別のジョブではありません。
文字起こしを超えた YouTube の探索
YouTube は、API が文字起こしの周辺の問いにも答えるプラットフォームで、YouTube Data API と同じリソース名を使います。
- 検索 —
GET /v1/youtube/searchがクエリで動画、チャンネル、再生リストを探し、カーソルページの結果を返します。 - 動画 —
GET /v1/youtube/videosが字幕が利用できるかを含む動画の詳細を返します。 - チャンネル —
GET /v1/youtube/channelsが id または@handleでチャンネルを解決します。 - チャンネルのアップロード —
GET /v1/youtube/channels/{channelId}/videosがチャンネルのアップロードをたどります。 - 再生リストの項目 —
GET /v1/youtube/playlists/{playlistId}/itemsが再生リストをたどります。 - 字幕 —
GET /v1/youtube/captionsが動画の字幕トラックのメタデータと字幕テキストを返します。音声認識ジョブは決して開始しません。requiresAsyncを報告したら、POST /v1/transcriptを呼び出して文字起こしを実行してください。
本番利用のために設計
公開する範囲は意図的に小さくし、サービスにとって重要な部分は推測ではなく文書化しています。
- 1 つの資格情報 — Bearer トークンとして送る API キー、またはスクリプトやサーバーから
X-API-Keyで認証します。 - スコープ付きキー — 呼び出し側に必要なスコープだけを付与し、
transcriptsとbatchesが抽出とバッチ作業を担います。 - 構造化されたエラー — 抽出と検証の失敗は、安定した
codeと読めるmessageを持つエラーオブジェクトを返します。認証 (401) とレート制限 (429) の応答は、より単純なフラットなエラー本体を使います。 - 実行可能な制限 — レート制限されたリクエストは
Retry-After付きの429を返し、成功した応答にはX-RateLimit-*ヘッダーが付くので、クライアントは正しく後退できます。 - 公開されたコントラクト — 完全な OpenAPI ドキュメントが API を支えるので、クライアントを生成し、サーバーをモックし、実際の応答をスキーマに対して検証できます。
- エージェントのための兄弟 — 呼び出し側がサービスではなく AI クライアントなら、同じアカウントと同じツールを transcript.im の MCP サーバーから利用できます。
関連ツール
文字起こし API のよくある質問
transcript.im API とは何ですか?
transcript.im API は、公開された動画または音声のリンクを、タイムスタンプ付きの文字起こしに変換する REST の窓口で、既存の字幕を優先し、動画に字幕がなければ AI 文字起こしを使います。
transcript.im API はどのプラットフォームに対応していますか?
送られたリンクからプラットフォームを判定し、YouTube、TikTok、Instagram、LinkedIn、Twitter/X の文字起こしを抽出します。YouTube、TikTok、LinkedIn は字幕を優先し音声認識を代替として使い、Instagram と X は字幕トラックがなく直接音声認識に進みます。
動画に字幕がない場合はどうなりますか?
動画に字幕トラックがまったくない場合、API は ASR ジョブを開始して job id を返します。文字起こしが準備できるまでそのジョブを照会するので、リクエストが音声認識で止まることはありません。
ローカルの音声または動画ファイルを文字起こしできますか?
はい。POST /v1/transcript は URL の代わりに file パートを持つ multipart/form-data 本体を受け取ります。アップロードしたファイルは直接音声認識に進むため 202 ジョブを返し、待ち時間の予算内に終われば 200 の結果を返します。
transcript.im API はテキストと一緒にタイムスタンプを返せますか?
はい。JSON の応答にはタイムスタンプ付きセグメントが含まれ、テキストの応答は行ごとにタイムスタンプの接頭辞を保てるので、話された瞬間に戻れます。
特定の言語で文字起こしをリクエストするには?
asr と asr-<code> の項目を含む、カンマ区切りの言語優先リストを送ります。字幕の一致は直接返され、字幕はあるがリストに合うものがない場合、リクエストは AI 文字起こしへ進んで 202 ジョブを返します。利用可能な言語付きの 404 は、音声認識が許可されていないときだけ返されます。
非同期の文字起こしがいつ準備できるかはどう分かりますか?
同じ資格情報で GET /v1/transcript/job/{id} を成功または失敗を報告するまで照会するか、GET /v1/transcript/job/{id}/events を購読してサーバー送信の更新を受け取ります。ジョブ照会は失敗したジョブでも 200 を返すので、HTTP コードではなく status と error フィールドを読んでください。
transcript.im API はバッチ抽出に対応していますか?
はい。バッチは URL リスト、再生リスト、チャンネルを受け取り、各項目のステータスを追跡し、項目をページ単位で返します。
どのエクスポート形式をダウンロードできますか?
完了したバッチは txt、csv、json、srt、vtt、zip としてエクスポートされ、保存した 1 件の文字起こしは txt、srt、vtt、json、md としてダウンロードされます。
保存した文字起こしはどこにありますか?
アカウントのライブラリが、保存した文字起こしとバッチ記録のある場所で、/v1/library の下にあります。一覧、読み取り、ダウンロード、関連、削除のルートを提供し、読み取りはアカウント範囲に限られ、新しい抽出を決して開始しません。
YouTube の字幕エンドポイントは何を返しますか?
GET /v1/youtube/captions は、動画の字幕トラックのメタデータと字幕テキストをあわせて返します。音声認識ジョブは決して開始しません。requiresAsync を報告したら、POST /v1/transcript を呼び出して文字起こしを実行してください。
transcript.im API はエラーとレート制限をどう報告しますか?
抽出と検証のエラーは code と message を持つオブジェクトを使います。認証はフラットな 401 を、レート制限は Retry-After と X-RateLimit-* ヘッダー付きのフラットな 429 を返すので、クライアントは正しく後退できます。