
REST API
Transkript-API für Video und Audio
transcript.im stellt dieselbe Extraktions-Pipeline, die das Produkt antreibt, als versionierte Transkript-API bereit. Sende eine Video- oder Audio-URL und erhalte zeitgestempelten Text zurück, als JSON oder Klartext, mit automatisch erkannter Plattform. Vorhandene Untertitel werden zuerst verwendet; hat ein Video keine, transkribiert die KI den Ton und das Ergebnis wird asynchron geliefert.
- Eine einzige
urlakzeptiert einen vollständigen oder kurzen Link und erkennt YouTube, TikTok, Instagram, LinkedIn und Twitter/X; bei YouTube wird auch eine reine Video-ID erkannt, undplatformplusexternalIddecken eine Quelle ab, die du bereits kennst. - Untertitel werden zuerst verwendet; hat ein Video keine, transkribiert die KI den gesprochenen Ton, und ein hochgeladener lokaler Datei-Upload läuft immer über die Spracherkennung.
format=jsonliefert zeitgestempelte Segmente, währendformat=textKlartext zum Einfügen liefert.- Die Batch-Extraktion deckt URL-Listen, Playlists und Kanäle ab.
- Batch-Exporte decken txt, csv, json, srt, vtt und zip ab; ein gespeichertes Transkript lädt als txt, srt, vtt, json oder md herunter.
- Gespeicherte Transkripte liegen in der Bibliothek des Kontos, und die YouTube-Erkennung deckt Suche, Videos, Kanäle, Uploads, Playlists und Untertitel ab.
- Der vollständige Vertrag wird als OpenAPI-Dokument veröffentlicht.
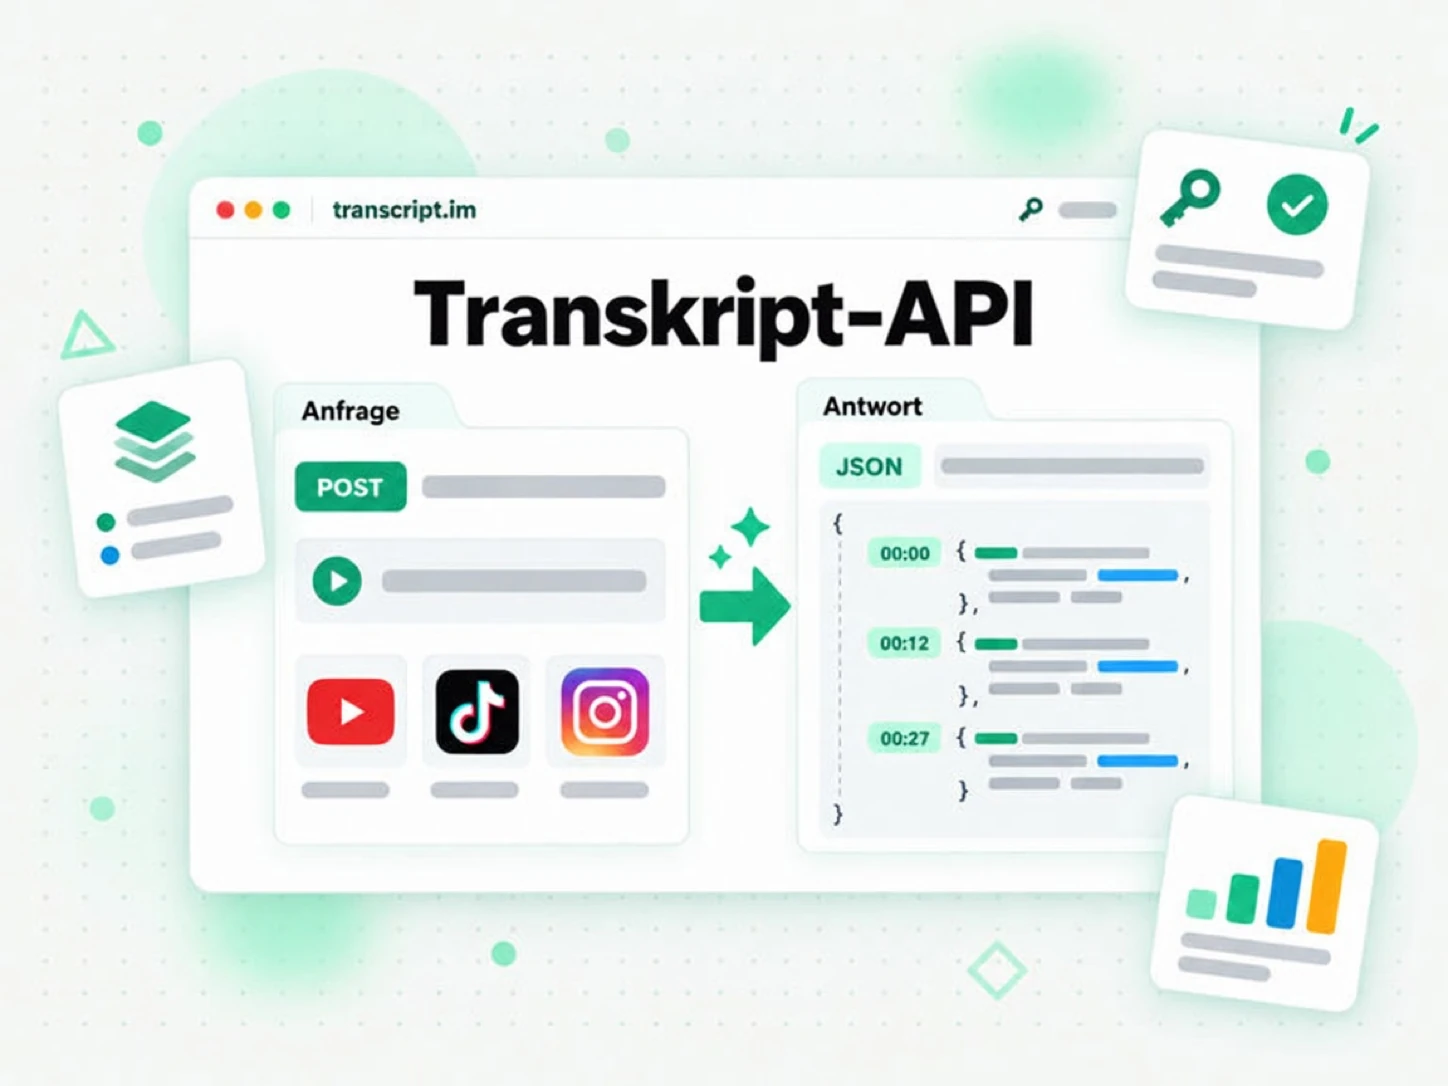
Was die transcript.im-API leistet
Die transcript.im-API verwandelt einen öffentlichen Video- oder Audio-Link in ein zeitgestempeltes Transkript, das dein Produkt lesen, speichern, durchsuchen oder an ein Modell übergeben kann. Du sendest eine URL; die API löst die Plattform auf, sucht die bereits vorhandene Untertitelspur des Erstellers und liefert den geschriebenen Text mit einem Zeitstempel in jeder Zeile. Hat ein Video gar keine Untertitel, bleibt die API nicht bei einem Fehler stehen – sie weicht auf die KI-Transkription des gesprochenen Tons aus, damit dieselbe Anfrage trotzdem Text liefert.
- Eine Anfrage, echter Text – löse einen Link auf und gib zeitgestempelte Transkriptsegmente oder Klartext zurück.
- Erst Untertitel, dann KI – nutze die Spur des Erstellers, wenn sie existiert, transkribiere den Ton, wenn nicht.
- Standardmäßig asynchron für ASR – eine job id lässt dich eine lange Transkription abfragen, ohne zu blockieren.
- Sprachbewusst – fordere eine Sprachpriorität an und lies die Sprache zurück, die die API aufgelöst hat.
- Plattformunabhängig – der Aufrufer muss nicht wissen, wo das Video gehostet wird.
Eine Transkript-API für fünf Plattformen
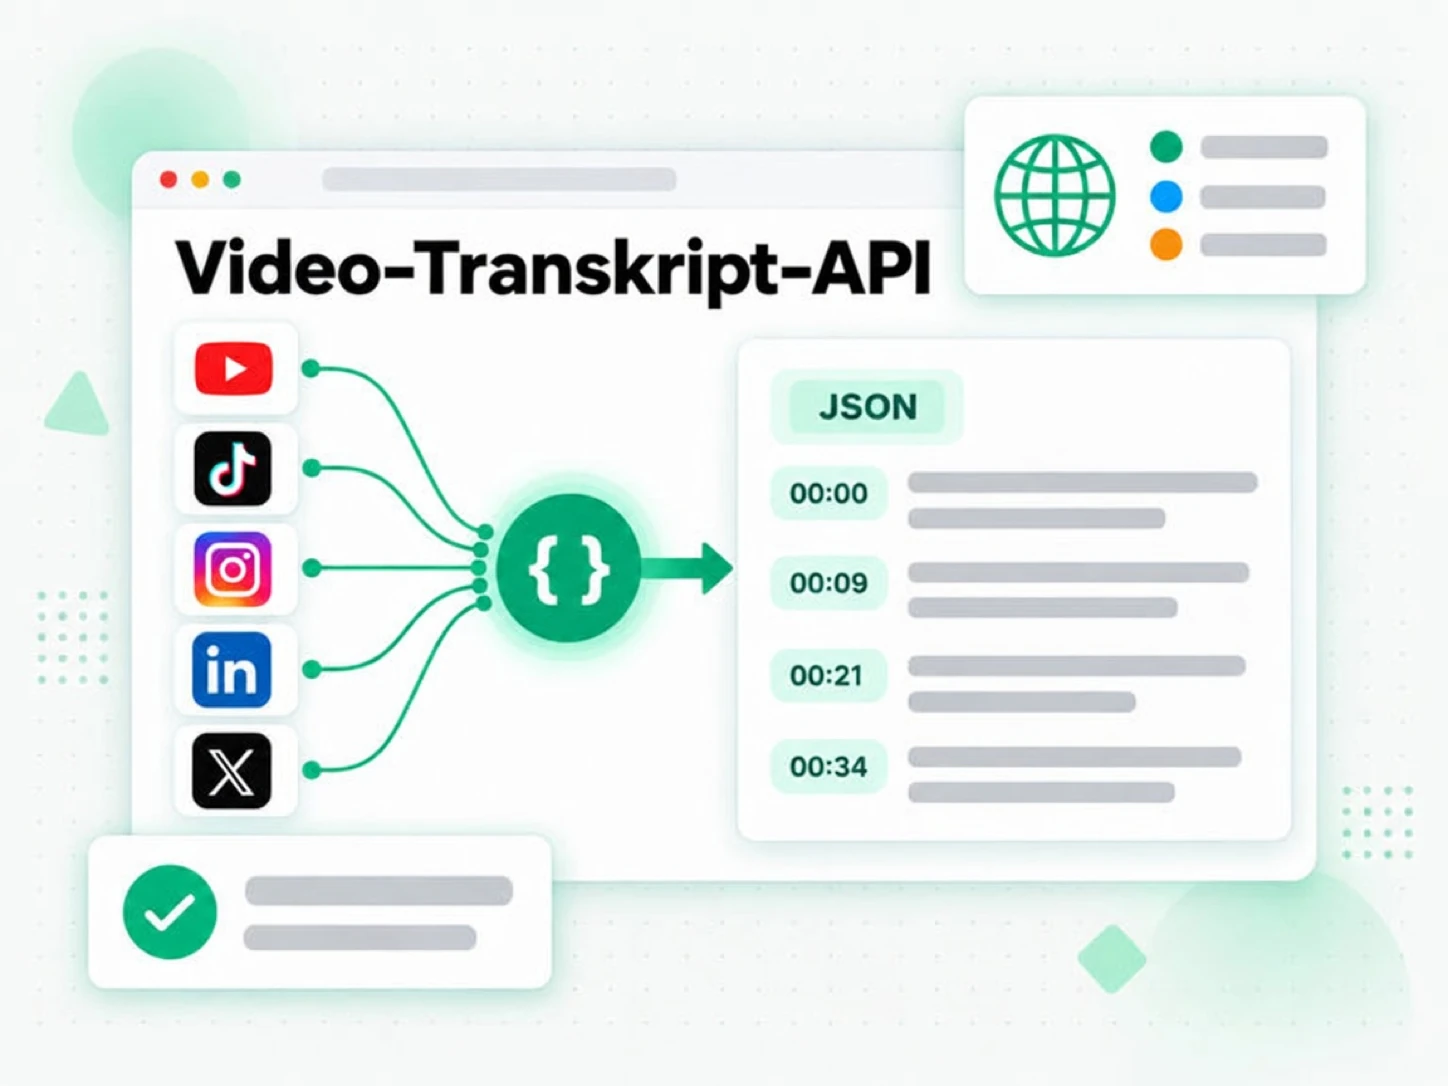
YouTube
Transkripte für jedes öffentliche YouTube-Video, jeden Short oder jede Live-Aufnahme, zuerst über die Untertitel des Erstellers und mit KI-Transkription, wenn Untertitel fehlen. YouTube ist zudem die Plattform mit einer vollständigen Erkennungsoberfläche – Suche, Videos, Kanäle, Uploads, Playlists und Untertitel –, die neben dem Transkript selbst verfügbar ist. Der Rückstand eines Kanals oder eine Playlist wird zu einem Batch zeitgestempelter Transkripte, während ein einzelner Link als lesbarer Text zurückkommt, den du durchsuchen kannst.
TikTok
Transkripte für öffentliche TikTok-Videos, zuerst über Untertitel und mit Spracherkennung als Rückfall. Füge einen Video-Link ein und lies den gesprochenen Inhalt als sauberen, zeitgestempelten Text, den du weiterverwenden, übersetzen oder zitieren kannst. Derselbe Aufruf deckt einen kurzen Clip und einen längeren Upload ab, sodass ein Trend, ein Tutorial und ein Talking-Head-Video alle als Text zurückkommen.
Transkripte für öffentliche Instagram-Reels und Video-Beiträge. Instagram hat keine Untertitelspur zum Lesen, die Extraktion läuft also über asynchrone Spracherkennung: Link senden, Job abfragen und den Text abholen, wenn er fertig ist. So wird ein Reel zitierbar und durchsuchbar, obwohl die Plattform seine Worte nie als Text veröffentlicht hat.
Transkripte für öffentliche LinkedIn-Video-Beiträge, zuerst über Untertitel und mit Spracherkennung als Rückfall. Das Ergebnis kommt mit Zeitstempeln zurück, sodass ein Vortrag, ein Produktclip oder ein aufgezeichnetes Meeting zu durchsuchbarem Text wird, den du zitieren und weiterverwenden kannst. Ziehe das Argument aus einer Webinar-Aufzeichnung oder verwandle das Update eines Gründers in einen Entwurf, den du bearbeiten kannst.
Twitter/X
Transkripte für öffentliche X-Video-Beiträge. X hat keine Untertitelspur zum Lesen, die Extraktion läuft also über asynchrone Spracherkennung: Link senden, Job abfragen und zeitgestempelten Text abholen, den du durchsuchen kannst. Zitiere ein Video präzise oder archiviere seinen gesprochenen Inhalt, bevor der Beitrag bearbeitet oder entfernt wird.
Wie eine Transkript-Anfrage abläuft
Ein einziger Aufruf führt einen Link oder eine hochgeladene Datei von der Eingabe zum Transkript, und die API sagt dir, welchen Weg sie genommen hat.
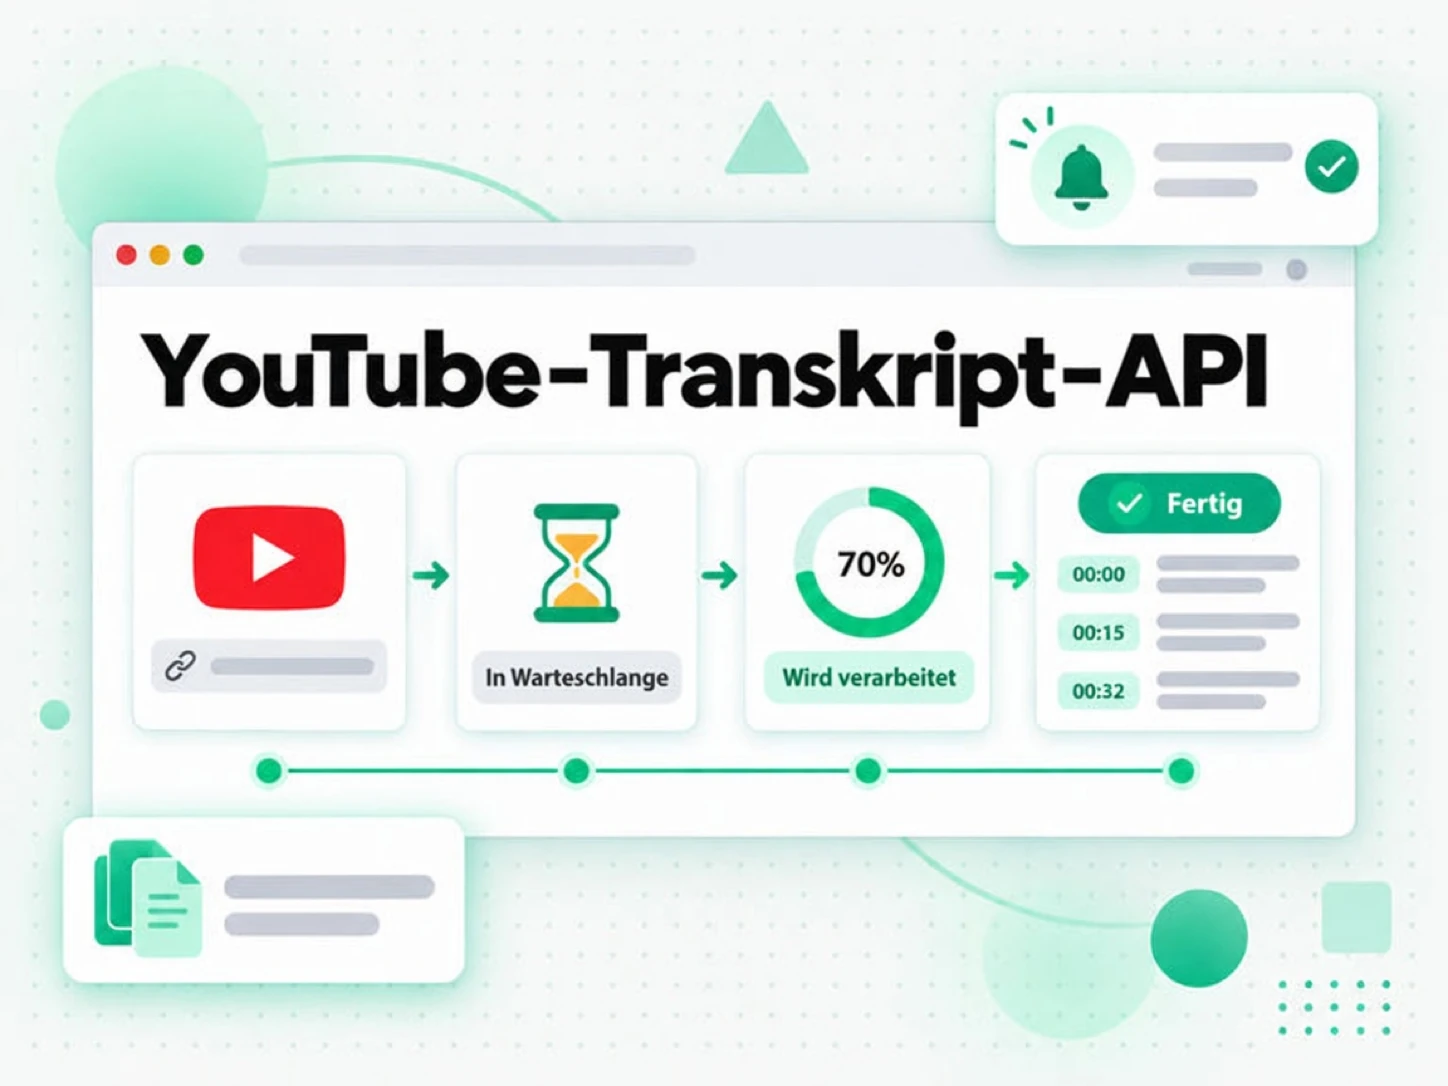
- Sende die Quelle – poste eine
url, übergibplatformundexternalId, wenn du sie bereits kennst, oder lade eine Datei alsmultipart/form-dataan denselben Endpoint hoch. - Erhalte einen Untertitel-Treffer – wenn das Video Untertitel in einer Sprache deiner Liste trägt, kommt das Transkript in der Antwort zurück.
- Behandle einen Sprach-Fehlschlag – wenn Untertitel existieren, aber keine zu deiner Liste passt, läuft die Anfrage weiter zur KI-Transkription und gibt
202mit einer job id zurück; ein404mitavailableLanguageswird nur zurückgegeben, wenn Spracherkennung für den Aufrufer nicht erlaubt ist. - Erzwinge ASR oder weiche darauf aus – ein expliziter
asr-Eintrag, ein Video ganz ohne Untertitelspur oder eine hochgeladene Datei startet einen ASR-Job und gibt eine job id zurück. - Abfragen oder streamen – lies den Job mit
GET /v1/transcript/job/{id}, bis er erfolgreich ist oder fehlschlägt, oder abonniere seinen/events-Stream für serverseitigen Fortschritt. Eine Job-Abfrage gibt200auch bei einem fehlgeschlagenen Job zurück, verzweige also nach dem Feldstatus. - Lies das Ergebnis – ein fertiges Transkript trägt seine aufgelöste Sprache, Länge, zeitgestempelten Segmente und auf Wunsch Metadaten wie Titel, Autor und Veröffentlichungsdatum.
- Wiederhole sicher – ein bereits extrahiertes Transkript wird aus dem Cache geliefert, statt einen neuen Job zu starten, dieselbe Quelle kann also erneut angefragt werden.
- Erst prüfen –
GET /v1/transcript/infolöst eine Quelle auf und listet die Sprachen, die sie bedienen kann, bevor du dich auf eine Extraktion festlegst.
202 mit einer job id zurück, und eine tatsächlich fehlende Ressource oder ein nicht erlaubter Rückfall gibt 404 zurück. Jeder Weg gibt dieselbe Transkript-Form zurück, sobald der Text fertig ist.Batch-Extraktion und Exporte
Echte Arbeitslasten enden selten bei einem einzigen Video, die API akzeptiert einen Batch also als URL-Liste, Playlist oder Kanal. Jeder Batch verfolgt seine eigenen Summen – wie viele Elemente ausstehen, wie viele erfolgreich waren und wie viele fehlgeschlagen sind – und liefert Elemente Seite für Seite, damit ein langer Kanal nicht als eine riesige Nutzlast ankommt.
- Drei Batch-Formen –
POST /v1/batchnimmt eine URL-Liste, eine Playlist oder einen Kanal, je nachdem, welchen Body du sendest. - Unabhängiger Status – ein fehlgeschlagener Link wird für sich markiert und verwirft nie den Rest des Batchs; fehlgeschlagene Elemente können mit
/retrywiederholt werden. - Seitenweise Elemente – lies den Batch mit
GET /v1/batch/{batchId}und folge dem zurückgegebenen Seitentoken für die übrigen Elemente. - Live-Fortschritt – jede Abfrage liefert aktualisierte Zähler, sodass ein Aufrufer zeigen kann, wie viel eines langen Laufs fertig ist.
- Exportiere in deinem Format – lade einen fertigen Batch unter
/exportalstxt,csv,json,srt,vttoderzipherunter.
srt und vtt direkt in einen Editor oder Player. Für ein Archiv halten csv, json und zip eine ganze Bibliothek von Aufzeichnungen als einen Korpus durchsuchbar. Die Formate decken sich mit den Antworten einzelner Transkripte, ein Konsument, der ein Ergebnis verarbeitet, kann also bereits einen Batch lesen.Gespeicherte Transkripte in der Bibliothek des Kontos
Extraktion und Speicherung sind getrennt: Ein Transkript wird Teil der Bibliothek des Kontos, sobald es gespeichert ist, und in der Bibliothek liest, durchsuchst, lädst und entfernst du es später, ohne die Extraktion erneut auszuführen.
- Gespeicherte Inhalte auflisten –
GET /v1/library/transcriptsblättert durch die Transkripte des Kontos, Batch-Datensätze und fehlgeschlagenen Verlaufszeilen, mit Suche, Filtern nach Plattform und Sprache sowie Sortierung. - Ein Element lesen –
GET /v1/library/transcripts/{platform}/{externalId}gibt ein gespeichertes Transkript nach Plattform und externer id zurück, oder für die Sprache, die du nennst. - Herunterladen – die Route
/downloadexportiert ein gespeichertes Transkript alstxt,srt,vtt,jsonodermd. - Verwandte Inhalte – die Route
/relatedlistet weitere gespeicherte Elemente desselben Kanals auf. - Entfernen –
DELETEnimmt ein Element aus der Bibliothek, ohne die Kopie von jemand anderem anzutasten. - Kontogebundene Lesezugriffe – eine Anfrage an die Bibliothek gibt nur zurück, was das Konto gespeichert hat, und startet nie eine neue Extraktion; ein gespeichertes Transkript erneut anzusehen ist also ein Lesevorgang, kein neuer Job.
YouTube-Erkennung jenseits von Transkripten
YouTube ist die Plattform, auf der die API auch die Fragen rund um ein Transkript beantwortet, mit denselben Ressourcennamen wie die YouTube-Data-API.
- Suche –
GET /v1/youtube/searchfindet Videos, Kanäle oder Playlists per Abfrage und gibt cursorseitige Ergebnisse zurück. - Videos –
GET /v1/youtube/videosgibt Details zu einem Video zurück, einschließlich der Frage, ob Untertitel verfügbar sind. - Kanäle –
GET /v1/youtube/channelslöst einen Kanal per id oder@handleauf. - Kanal-Uploads –
GET /v1/youtube/channels/{channelId}/videosdurchläuft die Uploads eines Kanals. - Playlist-Elemente –
GET /v1/youtube/playlists/{playlistId}/itemsdurchläuft eine Playlist. - Untertitel –
GET /v1/youtube/captionsgibt die Metadaten der Untertitelspur und den Untertiteltext eines Videos zurück. Es startet nie einen Spracherkennungsjob: Wenn esrequiresAsyncmeldet, rufePOST /v1/transcriptauf, um die Transkription auszuführen.
Für den Produktionseinsatz gebaut
Die Oberfläche ist bewusst klein, und die Teile, die für einen Dienst zählen, sind dokumentiert statt geraten.
- Eine einzige Credential – authentifiziere dich mit einem API-Schlüssel als Bearer-Token oder mit
X-API-Keyaus einem Skript oder Server. - Scope-beschränkte Schlüssel – vergib nur die Scopes, die ein Aufrufer braucht, wobei
transcriptsundbatchesExtraktion und Batch-Arbeit abdecken. - Strukturierte Fehler – Extraktions- und Validierungsfehler geben ein Fehlerobjekt mit stabilem
codeund lesbaremmessagezurück; Antworten zur Authentifizierung (401) und zum Ratenlimit (429) nutzen einen einfacheren flachen Fehlerbody. - Umsetzbare Limits – eine ratenlimitierte Anfrage gibt
429mitRetry-Afterzurück, und erfolgreiche Antworten tragenX-RateLimit-*-Header, damit ein Client korrekt zurückweichen kann. - Ein veröffentlichter Vertrag – das vollständige OpenAPI-Dokument stützt die API, du kannst also einen Client generieren, einen Server mocken oder echte Antworten gegen das Schema validieren.
- Ein Gegenstück für Agenten – dasselbe Konto und dieselben Tools sind über den transcript.im-MCP-Server erreichbar, wenn dein Aufrufer ein KI-Client statt eines Dienstes ist.
Ähnliche Tools
Häufige Fragen zur Transkript-API
Was ist die transcript.im-API?
Die transcript.im-API ist eine REST-Oberfläche, die einen öffentlichen Video- oder Audio-Link in ein zeitgestempeltes Transkript verwandelt, zuerst über vorhandene Untertitel und mit KI-Transkription, wenn ein Video keine hat.
Welche Plattformen unterstützt die transcript.im-API?
Sie extrahiert Transkripte aus YouTube, TikTok, Instagram, LinkedIn und Twitter/X, indem sie die Plattform aus dem gesendeten Link erkennt. YouTube, TikTok und LinkedIn nutzen zuerst Untertitel mit Spracherkennung als Rückfall; Instagram und X haben keine Untertitelspur und gehen direkt zur Spracherkennung.
Was passiert, wenn ein Video keine Untertitel hat?
Wenn ein Video gar keine Untertitelspur hat, startet die API einen ASR-Job und gibt eine job id zurück; du fragst diesen Job ab, bis das Transkript fertig ist, die Anfrage blockiert also nie durch die Spracherkennung.
Kann ich eine lokale Audio- oder Videodatei transkribieren?
Ja. POST /v1/transcript akzeptiert einen multipart/form-data-Body mit einem file-Teil statt einer URL. Eine hochgeladene Datei geht direkt zur Spracherkennung, gibt also einen 202-Job zurück – oder ein 200-Ergebnis, wenn sie innerhalb des Wartebudgets fertig wird.
Kann die transcript.im-API Zeitstempel mit dem Text zurückgeben?
Ja. JSON-Antworten tragen zeitgestempelte Segmente, und Textantworten können ein Zeitstempel-Präfix pro Zeile behalten, sodass du zum Moment zurückkehren kannst, in dem eine Zeile gesprochen wurde.
Wie fordere ich ein Transkript in einer bestimmten Sprache an?
Sende eine kommagetrennte Sprachprioritätsliste, einschließlich asr- und asr-<code>-Einträgen. Ein Untertitel-Treffer wird direkt zurückgegeben; wenn Untertitel existieren, aber keine zur Liste passt, läuft die Anfrage weiter zur KI-Transkription und gibt einen 202-Job zurück, und ein 404 mit den verfügbaren Sprachen wird nur zurückgegeben, wenn Spracherkennung nicht erlaubt ist.
Woher weiß ich, wann ein asynchrones Transkript fertig ist?
Frage GET /v1/transcript/job/{id} mit derselben Credential ab, bis er Erfolg oder Fehlschlag meldet, oder abonniere GET /v1/transcript/job/{id}/events für serverseitige Updates. Eine Job-Abfrage gibt 200 auch bei einem fehlgeschlagenen Job zurück, lies also die Felder status und error statt des HTTP-Codes.
Unterstützt die transcript.im-API die Batch-Extraktion?
Ja. Ein Batch nimmt eine URL-Liste, eine Playlist oder einen Kanal, verfolgt den Status jedes Elements und liefert Elemente Seite für Seite.
Welche Exportformate kann ich herunterladen?
Ein fertiger Batch exportiert als txt, csv, json, srt, vtt oder zip; ein einzelnes gespeichertes Transkript lädt als txt, srt, vtt, json oder md herunter.
Wo liegen gespeicherte Transkripte?
Die Bibliothek des Kontos ist der Ort, an dem gespeicherte Transkripte und Batch-Datensätze liegen, unter /v1/library. Sie bietet Routen zum Auflisten, Lesen, Herunterladen, für Verwandtes und zum Löschen, und ihre Lesezugriffe sind kontogebunden und starten nie eine neue Extraktion.
Was gibt der YouTube-Untertitel-Endpoint zurück?
GET /v1/youtube/captions gibt die Metadaten der Untertitelspur eines Videos zusammen mit dem Untertiteltext zurück. Es startet nie einen Spracherkennungsjob; wenn es requiresAsync meldet, rufe POST /v1/transcript auf, um die Transkription auszuführen.
Wie meldet die transcript.im-API Fehler und Ratenlimits?
Extraktions- und Validierungsfehler nutzen ein Objekt mit code und message; die Authentifizierung gibt ein flaches 401, und das Ratenlimit gibt ein flaches 429 mit Retry-After plus X-RateLimit-*-Headern zurück, damit ein Client korrekt zurückweichen kann.
Füge deinem Produkt Transkripte hinzu
Erstelle einen API-Schlüssel, sende einen Video-Link oder eine lokale Datei und lies das Transkript als JSON oder Klartext zurück.