
MCP-Server
transcript.im MCP-Server für KI-Agenten
Der MCP-Server von transcript.im gibt einem KI-Client ein Transkript-Tool, das er direkt aufrufen kann. Richte Claude, ChatGPT, Cursor oder OpenAI Agent Builder auf den Server und gib einen API-Schlüssel an; das Modell kann dann das Transkript eines öffentlichen Links abrufen, einen Batch starten, Untertitel exportieren oder YouTube durchsuchen – ohne Browser und ohne eigene Integration. Es ist ein entfernter HTTP-Endpunkt, ein gehosteter Client braucht also nur die URL und einen Schlüssel, keine lokale Installation.
- Ein entfernter Endpunkt unter
https://mcp.transcript.im/mcp, authentifiziert mit deinem API-Schlüssel: nichts zu installieren. - Elf Tools für Transkripte, Batches, Exporte, YouTube-Discovery und Nutzung.
- Keine KI-Tools: dein Client führt das Modell bereits aus; der Server liefert Transkripte und Plattformdaten.
- Dasselbe Konto und dieselbe Extraktions-Pipeline, die du schon über die REST API nutzt.
- Lange Transkripte werden mit einem Page-Token in Blöcke geteilt, damit ein einzelnes Ergebnis nicht das Kontextfenster flutet.
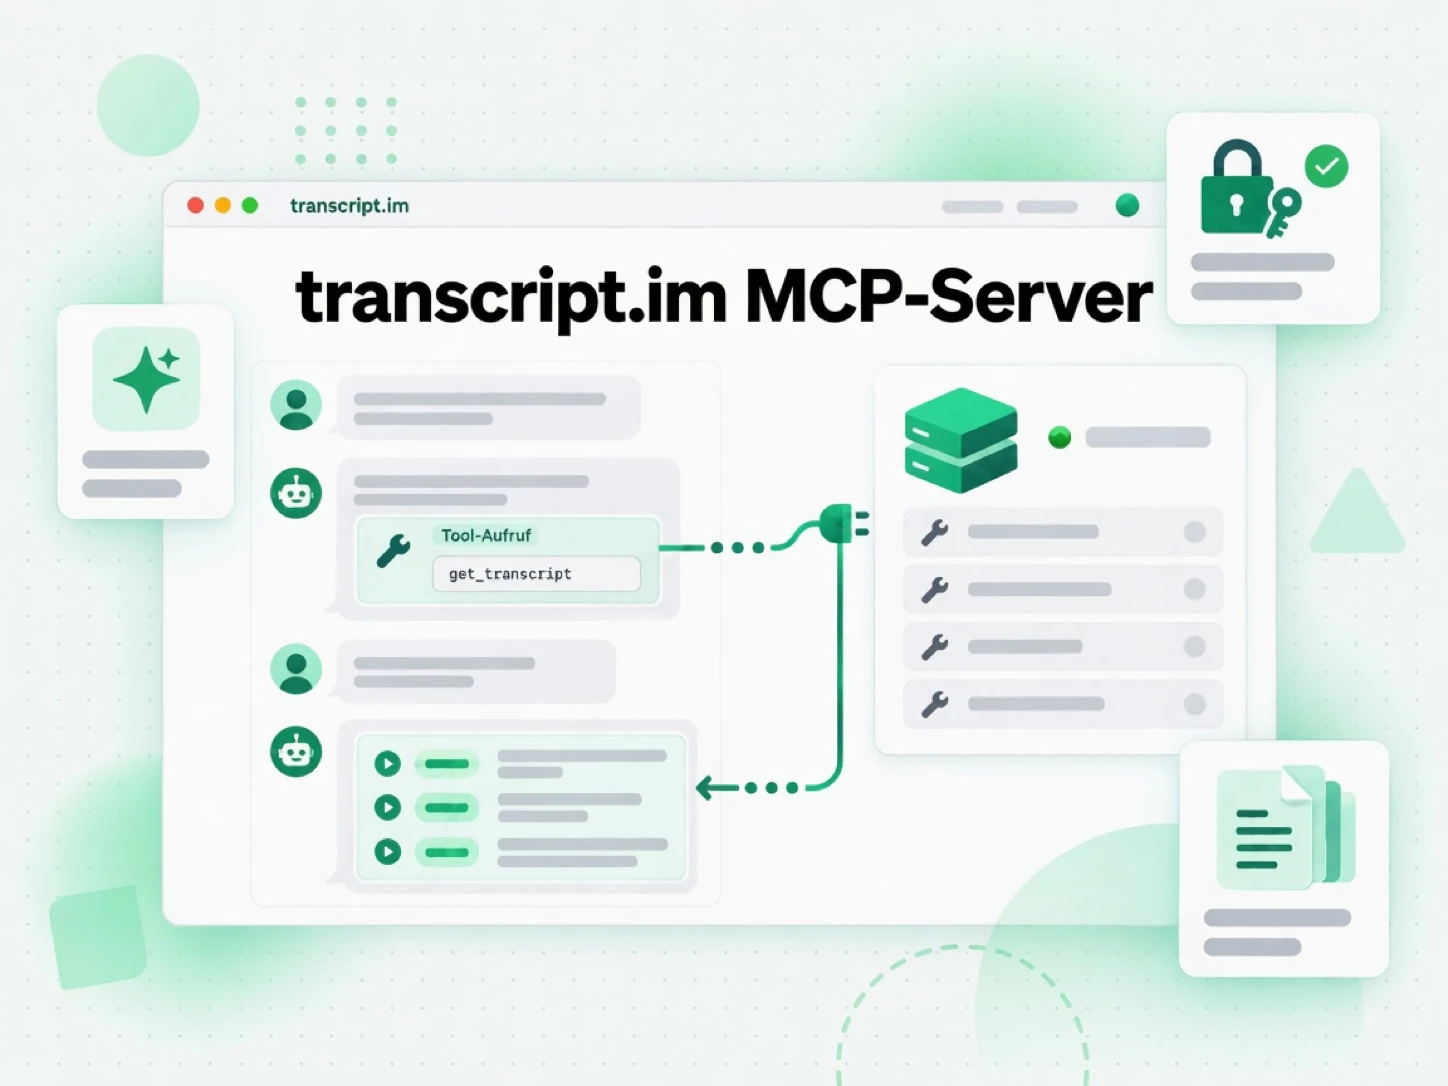
Was der MCP-Server von transcript.im macht
Das Model Context Protocol lässt einen Client die Tools entdecken und aufrufen, die ein Server veröffentlicht. Der MCP-Server von transcript.im nutzt diese Oberfläche für eine Aufgabe: einen öffentlichen Video- oder Audio-Link in ein Transkript zu verwandeln und die Plattformfragen drumherum zu beantworten. Ein Client ruft get_transcript mit einer URL auf; der Server erreicht die Extraktions-Pipeline von transcript.im, nutzt die Untertitel des Erstellers, wenn sie existieren, und weicht auf die KI-Transkription aus, wenn nicht.
- Transkript-Extraktion als Tool: ein Aufruf verwandelt einen Link in Text mit Zeitstempeln.
- Auch YouTube-Discovery: Videos suchen, Kanäle auflösen, Uploads und Playlist-Einträge auflisten und Untertitel-Metadaten lesen.
- Batches und Exporte: viele Links einreihen und das fertige Set anschließend exportieren.
- Kein Modell darin: der Server liefert Daten; der Client entscheidet, was er damit tut.
Tools, die dein Agent aufrufen kann
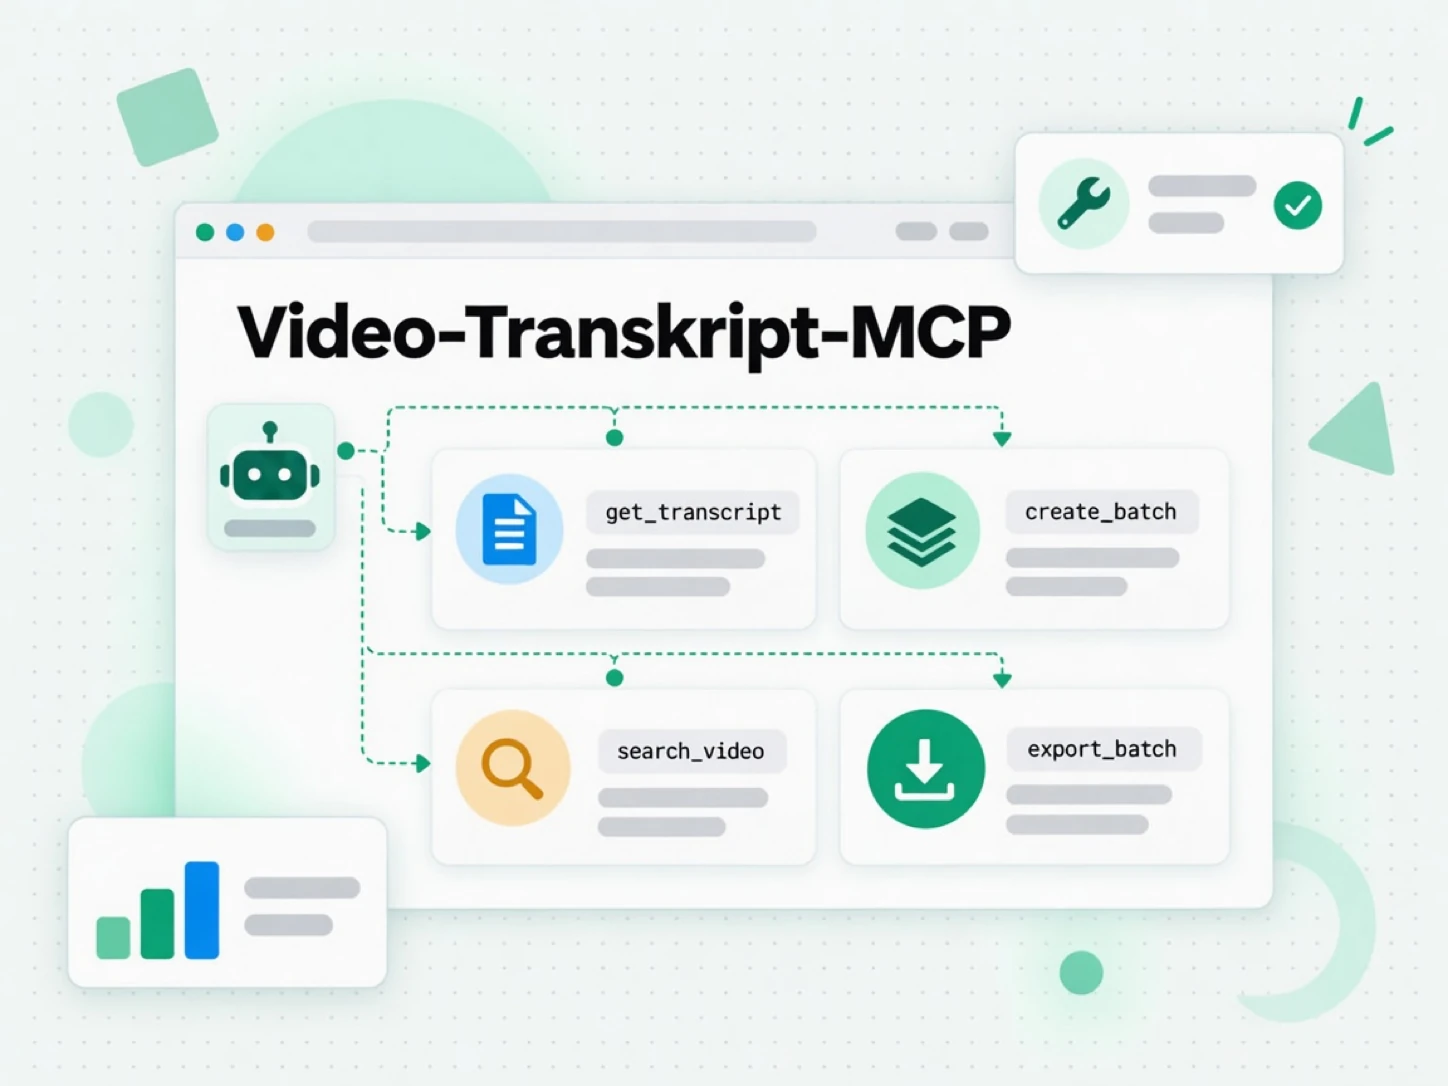
Transkripte
get_transcript extrahiert ein Transkript aus einer URL oder liest den nächsten Block eines langen, und get_transcript_info liefert die Metadaten eines Videos und die Untertitelspuren, die die API auflösen kann, bevor du dich für eine Extraktion entscheidest. Zusammen kann ein Agent beurteilen, ob sich ein Video zum Transkribieren lohnt, eine tatsächlich benötigte Sprachpriorität anfordern und den Text dann mit oder ohne Zeitstempel holen.
Batches und Exporte
create_batch startet einen Lauf aus einer URL-Liste, einer Playlist oder einem Kanal; get_batch meldet Status, Zähler und die nächste Seite von Einträgen; und export_batch verwandelt einen fertigen Batch in Text oder Untertitel. So verarbeitet ein Agent den gesamten Bestand eines Creators statt eines Clips nach dem anderen, und ein fehlgeschlagener Link wird separat gemeldet, statt den Rest zu verwerfen.
YouTube-Discovery
search_video findet Videos oder Kanäle nach Thema, get_channel löst einen Handle oder eine URL auf, list_channel_video listet die Uploads eines Kanals, list_playlist_item durchläuft eine Playlist und list_caption liest die Untertitel-Metadaten eines Videos samt Transkripttext. Mit diesen Tools recherchiert ein Agent eine Nische, prüft, was ein Creator veröffentlicht hat, und wählt die richtige Quelle, bevor er irgendetwas transkribiert.
Konto
get_usage gibt die Nutzungsübersicht des Kontos aus, damit ein Agent sieht, was das Konto bereits verbraucht hat, bevor es sich auf einen großen Batch oder einen langen Kanal einlässt, statt mitten im Lauf ein Limit zu entdecken.
Verbinde den Client, den du schon nutzt
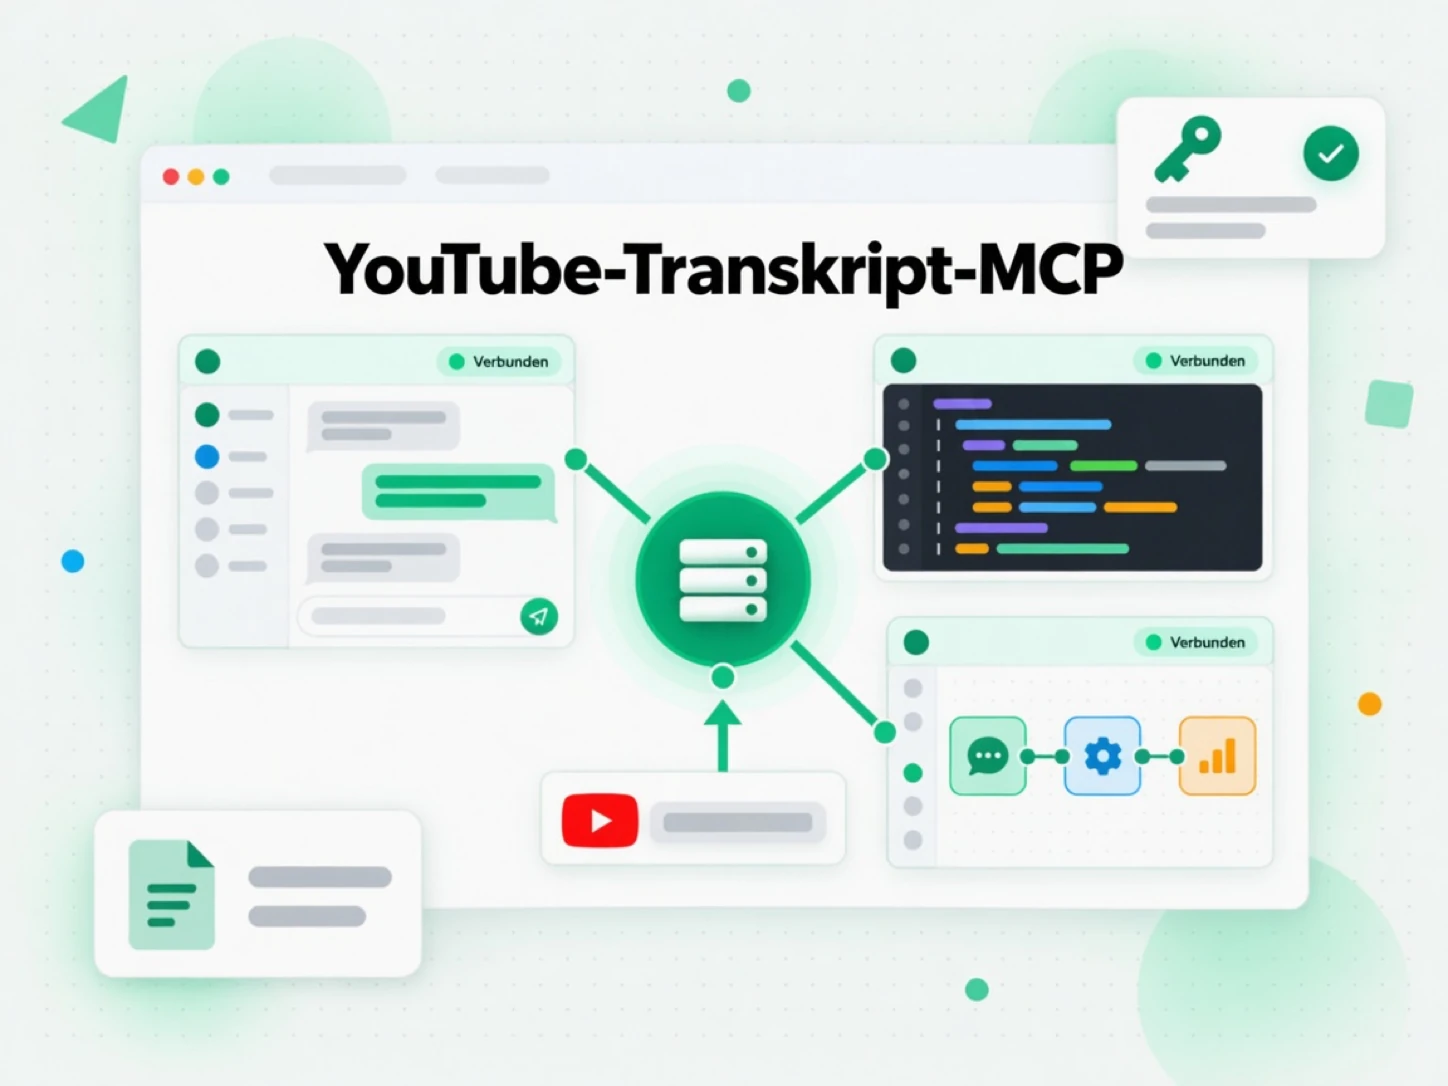
Claude
Füge den entfernten Server als benutzerdefinierten Connector hinzu oder registriere ihn über die Kommandozeile. Claude handelt den MCP-Server aus, stellt seine Tools der Unterhaltung bereit und hält sie über mehrere Züge verfügbar, sodass du in natürlicher Sprache ein Transkript anfordern und direkt danach eine Zusammenfassung verlangen kannst, ohne den Link zu wiederholen.
ChatGPT
Füge einen MCP-Connector hinzu und wähle die Authentifizierung per API-Schlüssel. ChatGPT ruft die Transkript-Tools dann wie jede andere verbundene App auf, das heißt, ein in den Chat eingefügter Video-Link kann zu lesbarem Text werden, den das Modell zitiert, übersetzt oder analysiert.
Cursor und andere Editoren
Richte die mcpServers-Konfiguration des Editors mit deinem API-Schlüssel auf die entfernte URL. Der Agent des Editors kann dann einen Link transkribieren und das Ergebnis direkt in dein Projekt oder deine Notizen schreiben.
OpenAI Agent Builder
Füge ein MCP-Tool mit der Server-URL und einer Bearer-Anmeldeinformation hinzu, und der Agent kann Transkripte als Schritt in einem größeren Workflow nutzen und den Text ohne eigenen Connector an das weitergeben, was als Nächstes kommt.
Verbinden und authentifizieren
Der Server ist ein entfernter HTTP-Endpunkt, das Verbinden eines Clients ist also eine URL und ein Schlüssel, keine Installation.
- Entferntes HTTP: füge
https://mcp.transcript.im/mcpzu deinem MCP-Client hinzu; auf deiner Maschine muss nichts laufen. - API-Schlüssel: sende den Schlüssel als
Authorization: Bearer <key>oderx-api-key; der Server reicht ihn an die REST API weiter, es gelten also dasselbe Konto und dieselben Berechtigungen. - Tool-Discovery: der Endpunkt beantwortet MCP-Discovery-Anfragen, sodass ein Client die angebotenen Tools auflisten kann, bevor er eines aufruft.
- Gleiche Ergebnisse: Tools, Chunking und Fehler entsprechen dem, was dasselbe Konto über die REST API erhält, das Verhalten hängt also nicht vom Client ab.
Lange Transkripte bleiben handhabbar
Eine zwei Stunden lange Aufnahme kann weit mehr Text erzeugen, als ein Modell in einem einzigen Tool-Ergebnis erhalten sollte, deshalb liefert der Server lange Transkripte in begrenzten Blöcken. Jeder Block meldet truncated: true und einen undurchsichtigen nextPageToken; ein erneuter Aufruf von get_transcript nur mit diesem Token liefert den nächsten Block, und der Agent wiederholt das, bis das Transkript erschöpft ist.
- Begrenzte Ergebnisse: jeder Block ist gedeckelt, damit ein einzelnes Ergebnis nicht das Kontextfenster flutet oder früheres Reasoning verdrängt.
- Zustandsloses Paging: das Token trägt die Position, und zwischen Aufrufen wird keine Serversession gehalten, sodass jede Replik den nächsten Block bedienen kann.
- JSON-Paging: ein JSON-Transkript paginiert nach Segment, damit ein strukturierter Konsument das erwartete Schema behält, während er den Text durchläuft.
- Job-Polling: ein Video ohne Untertitel liefert eine Job-ID, und der Agent pollt sie, bis das Transkript fertig ist.
- Lesbarer Anfang: der erste Block reicht, um eine Frage zum Beginn zu beantworten, ein kurzes Follow-up muss also nicht das ganze Transkript laden.
Fehler, auf die dein Agent reagieren kann
Wenn ein Tool-Aufruf fehlschlägt, liefert der Server einen MCP-Fehler mit lesbarem Text statt eines Stack-Trace. Strukturierte Details reisen mit dem Ergebnis, damit sich der Agent erholen kann, statt zu raten: ein code, ein HTTP-status, eine upgradeUrl bei erreichtem Limit und availableLanguages, wenn die angeforderte Sprache nicht verfügbar ist. Das macht aus einer Sackgasse eine nächste Aktion: eine andere Sprache versuchen, einen anderen Link wählen oder das Limit der Person im Gespräch zeigen. Ein Modell, das den Grund eines Fehlers lesen kann, kann seinen eigenen nächsten Versuch korrigieren – das ist der Unterschied zwischen einem Agenten, der sinnvoll erneut versucht, und einem, der in derselben kaputten Anfrage hängen bleibt.
Ähnliches
FAQ zum MCP-Server
Was ist der MCP-Server von transcript.im?
Der MCP-Server von transcript.im ist eine Model-Context-Protocol-Oberfläche, die Transkript-Extraktion, Batch-Jobs, Exporte und YouTube-Discovery als Tools bereitstellt, die ein KI-Client aufrufen kann.
Welche Clients können sich mit dem MCP-Server von transcript.im verbinden?
Claude, ChatGPT, Cursor, OpenAI Agent Builder und jeder andere MCP-Client können sich mit dem entfernten HTTP-Endpunkt und einem API-Schlüssel verbinden.
Enthält der MCP-Server von transcript.im KI-Tools?
Nein. Der Server stellt bewusst nur Daten und Extraktions-Tools bereit, weil der Client bereits das Modell ausführt, das das Ergebnis zusammenfasst oder umschreibt.
Wie erhält ein Agent ein Transkript aus einem Video-Link?
Er ruft das Transkript-Tool mit dem Link auf; der Server nutzt zuerst vorhandene Untertitel, weicht auf die KI-Transkription aus, wenn keine da sind, und liefert Text mit Zeitstempeln.
Wie geht der MCP-Server mit langen Transkripten um?
Sie werden in begrenzten Blöcken zurückgegeben. Jedes Ergebnis trägt ein Kürzungs-Flag und ein Page-Token, und der Agent ruft das Tool mit diesem Token erneut auf, um den nächsten Block zu lesen.
Kann ein Agent einen Batch über den MCP-Server von transcript.im ausführen?
Ja. Die Batch-Tools akzeptieren eine URL-Liste, eine Playlist oder einen Kanal, melden Status und Zähler und exportieren das fertige Set als Text oder Untertitel.
Funktioniert der MCP-Server von transcript.im mit YouTube-Suche und Kanälen?
Ja. Dedizierte Tools decken Video- und Kanalsuche, Kanalauflösung, Kanal-Uploads, Playlist-Einträge und Untertitel-Metadaten ab.
Wie authentifiziert der MCP-Server einen Client?
Er akzeptiert einen API-Schlüssel als Bearer-Token oder x-api-key-Header und reicht ihn an die REST API weiter, sodass seine Aufrufe auf demselben Konto landen wie eine direkte API-Anfrage.
Verbinde den MCP-Server von transcript.im
Füge die Server-URL zu deinem MCP-Client hinzu, gib einen API-Schlüssel an und frag deinen Agenten nach einem Transkript.