
REST API
適用於影片與音訊的轉錄 API
transcript.im 把驅動產品的那條擷取管線以帶版本的轉錄 API 開放出來。送出一個影片或音訊 URL,就能取回帶時間戳的文字,格式為 JSON 或純文字,平台由系統自動辨識。現有字幕優先使用;影片沒有字幕時,由 AI 轉寫音訊,結果以非同步方式回傳。
- 一個
url同時接受完整連結與短連結,並自動辨識 YouTube、TikTok、Instagram、LinkedIn 和 Twitter/X;YouTube 還支援直接傳影片 id,已知來源時也可以用platform加externalId指定。 - 優先使用字幕;影片沒有字幕時由 AI 轉寫人聲,本機檔案上傳則一律走語音辨識。
format=json回傳帶時間戳的分段,format=text回傳可直接貼上的純文字。- 批次擷取支援 URL 清單、播放清單和頻道。
- 批次匯出支援 txt、csv、json、srt、vtt、zip;已儲存的轉錄可下載為 txt、srt、vtt、json 或 md。
- 已儲存的轉錄存放在帳戶媒體庫中,YouTube 探索能力涵蓋搜尋、影片、頻道、上傳、播放清單和字幕。
- 完整契約以 OpenAPI 文件形式公開。
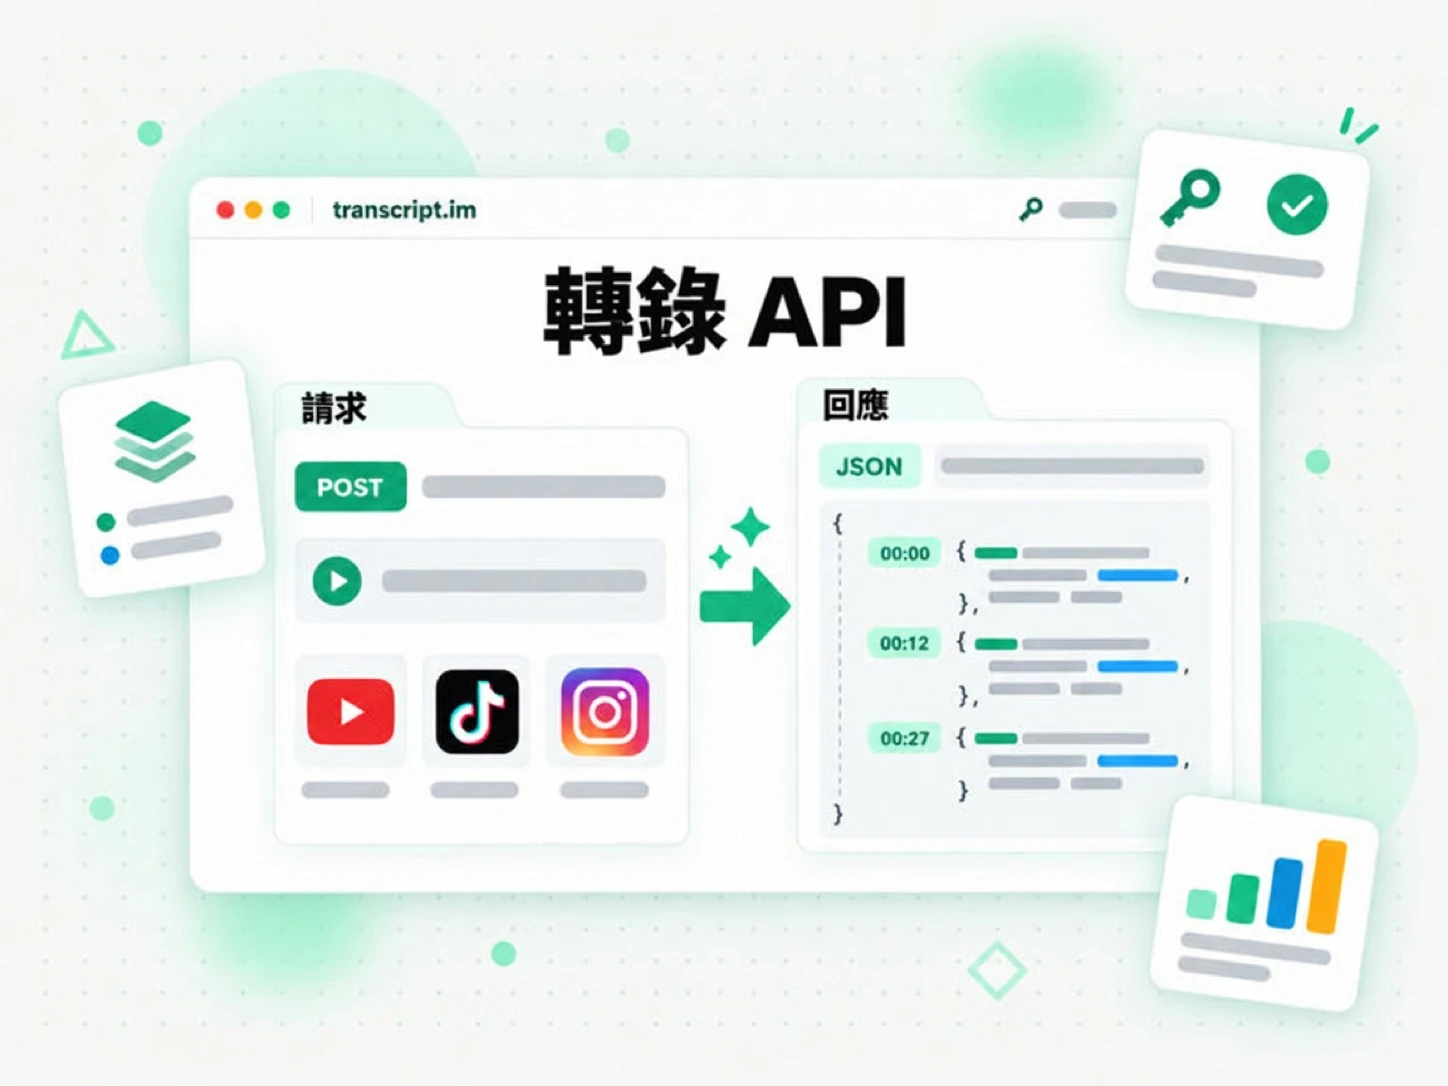
transcript.im API 能做什麼
transcript.im API 把公開的影片或音訊連結轉換成帶時間戳的轉錄文字,你的產品可以讀取、儲存、搜尋,或送入模型。你送出一個 URL;API 解析平台,尋找創作者既有的字幕軌,回傳每一行都帶時間戳的文字。當影片完全沒有字幕時,API 不會停在錯誤上——它會改用 AI 轉寫人聲,讓同一個請求照樣產出文字。
- 一次請求,真實文字——解析一個連結,回傳帶時間戳的轉錄分段或純文字。
- 字幕優先,AI 其次——有創作者字幕就用,沒有就轉寫音訊。
- ASR 預設非同步——取得 job id 後可以輪詢長時間轉寫而不會阻塞。
- 感知語言——請求語言優先順序,並讀回 API 實際解析出的語言。
- 平台無關——呼叫方不需要知道影片託管在哪裡。
一個轉錄 API,涵蓋五大平台
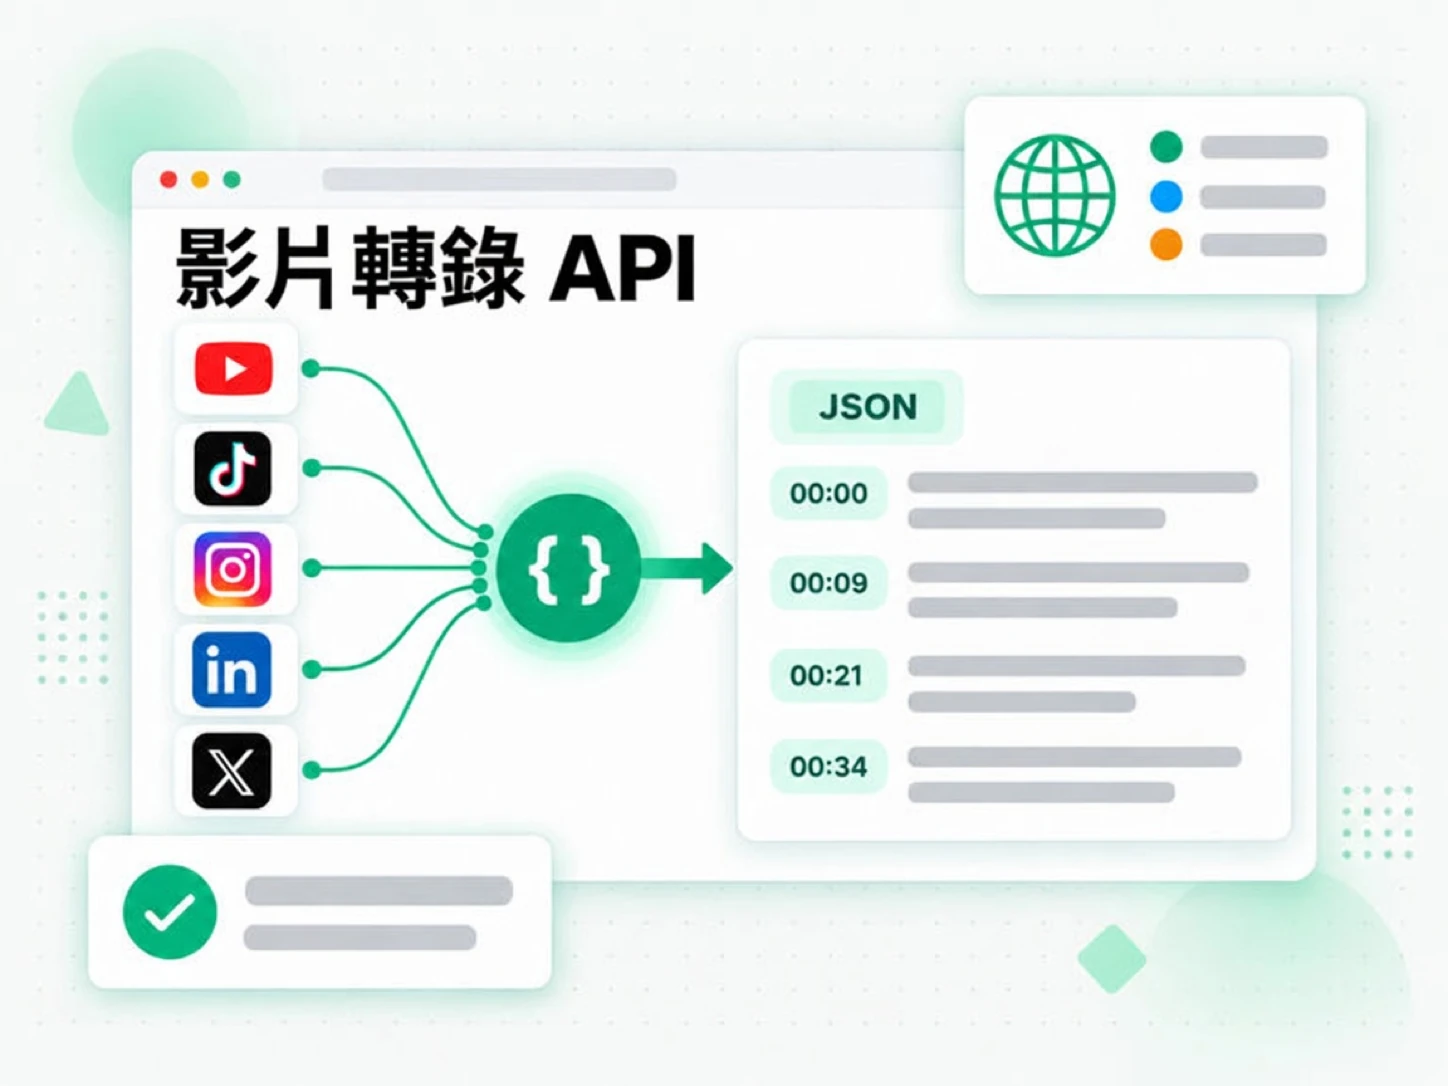
YouTube
任何公開的 YouTube 影片、Shorts 或直播錄影都能轉錄,優先使用創作者字幕,字幕缺失時用 AI 轉寫。YouTube 也是擁有完整探索能力的平台——搜尋、影片、頻道、上傳、播放清單和字幕——可與轉錄本身一起使用。一個頻道的積壓內容或一份播放清單會變成一整批帶時間戳的轉錄,而單一連結則回傳可搜尋的易讀文字。
TikTok
公開 TikTok 影片的轉錄,優先使用字幕,語音辨識作為後備。貼上影片連結,即可把口播內容讀成乾淨、帶時間戳的文字,方便再利用、翻譯或引用。同一次呼叫既能處理短影音也能處理較長的上傳,所以趨勢、教學和出鏡口播都會以文字形式回傳。
公開 Instagram Reels 和影片貼文的轉錄。Instagram 沒有可讀取的字幕軌,因此擷取走非同步語音辨識:送出連結、輪詢任務,準備好後取回文字。這樣即使平台從未把講話發布成文字,一則 Reel 也能被引用和搜尋。
公開 LinkedIn 影片貼文的轉錄,優先使用字幕,語音辨識作為後備。結果帶時間戳回傳,因此一場演講、一段產品短片或一次會議錄影都會變成可搜尋、可引用、可重複使用的文字。你可以從網路研討會錄影裡擷取論點,或把創辦人的動態變成一封可編輯的草稿。
Twitter/X
公開 X 影片貼文的轉錄。X 沒有可讀取的字幕軌,因此擷取走非同步語音辨識:送出連結、輪詢任務,取回可搜尋的帶時間戳文字。你可以準確引用一段影片,或在貼文被編輯或刪除前封存其口播內容。
一次轉錄請求如何流動
一次呼叫就把連結或上傳的檔案從輸入帶到轉錄,API 會告訴你它走了哪條路徑。
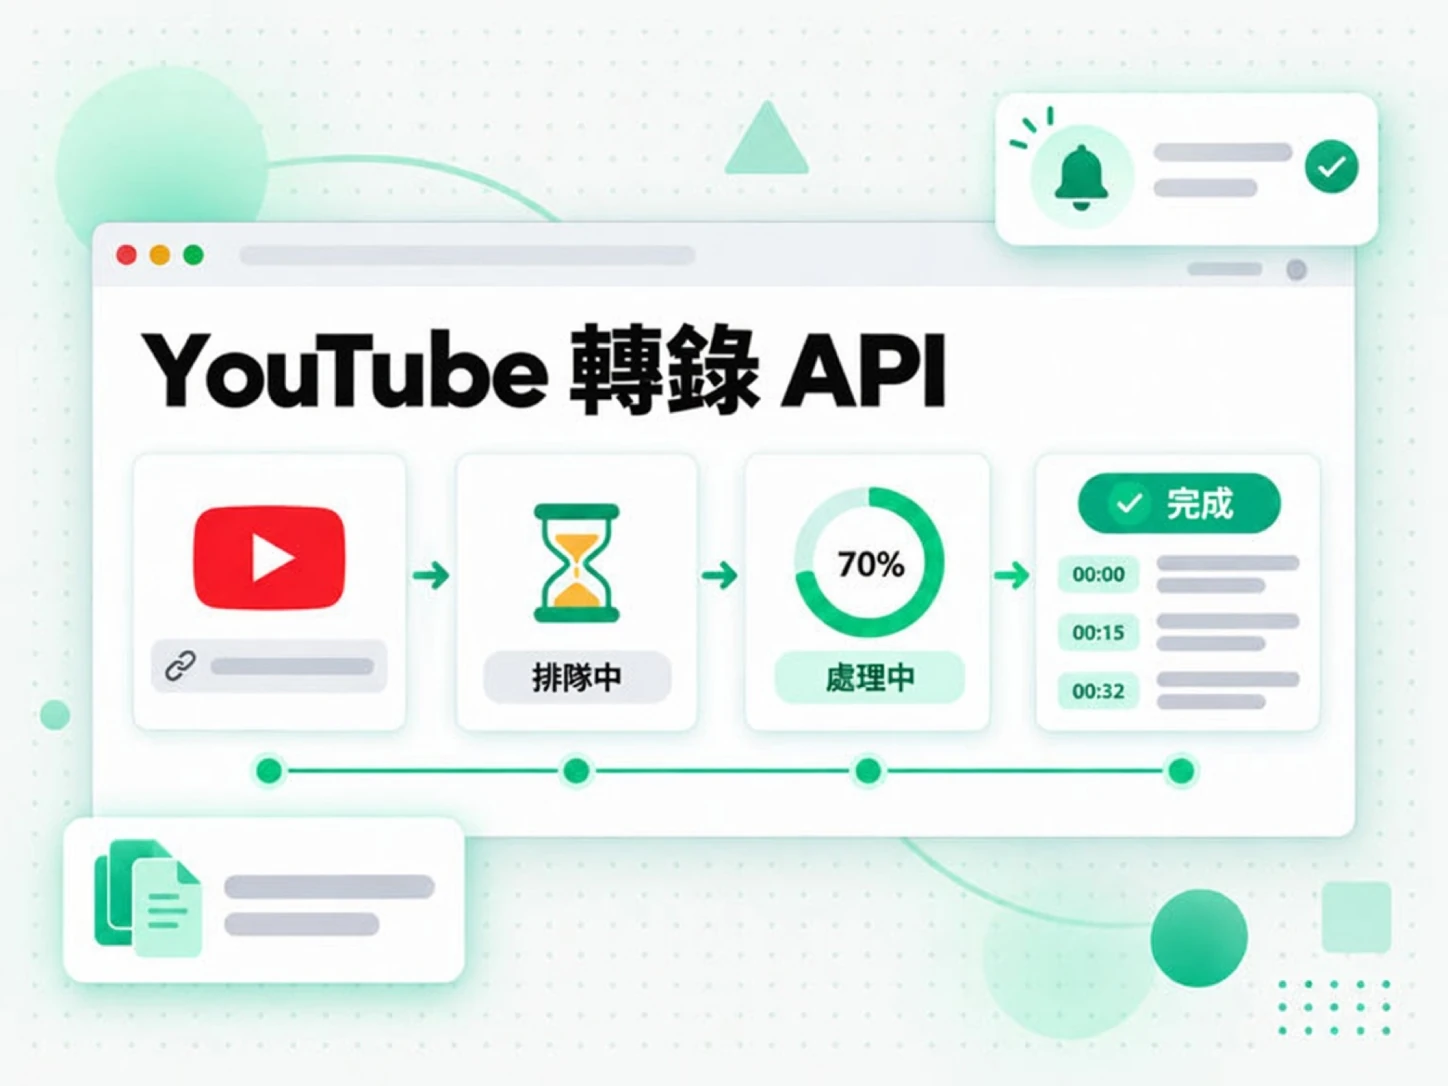
- 送出來源——提交
url,已知來源時傳platform和externalId,或以multipart/form-data把檔案上傳到同一個端點。 - 命中字幕——當影片帶有你清單中某種語言的字幕時,轉錄會直接隨回應回傳。
- 處理語言未命中——當存在字幕但沒有一條符合你的清單時,請求會繼續走 AI 轉寫並回傳
202和一個 job id;只有在呼叫方不允許使用語音辨識時,才會回傳帶availableLanguages的404。 - 強制或後備到 ASR——明確的
asr項目、完全沒有字幕軌的影片,或上傳的檔案,都會啟動 ASR 任務並回傳 job id。 - 輪詢或訂閱串流——用
GET /v1/transcript/job/{id}讀取任務直到成功或失敗,或訂閱其/events串流接收伺服器推送的進度。任務查詢即使任務失敗也會回傳200,所以要依status欄位分支。 - 讀取結果——完成的轉錄帶有解析出的語言、長度、帶時間戳的分段,以及視需求回傳的詮釋資料,如標題、作者和發布日期。
- 安全重試——已經擷取過的轉錄會直接從快取回傳,不再啟動新任務,所以同一個來源可以再次請求。
- 先探查——
GET /v1/transcript/info會解析來源並列出它能提供的語言,供你在決定擷取前判斷。
202 和 job id,真正不存在的資源或不被允許的後備則回傳 404。文字準備好後,每條路徑都回傳同一種轉錄結構。批次擷取與匯出
真實工作很少只處理一支影片,因此 API 接受 URL 清單、播放清單或頻道形式的批次任務。每個批次都追蹤自己的統計——有多少筆待處理、多少筆成功、多少筆失敗——並分頁回傳項目,長頻道不會以一整塊巨大的負載送達。
- 三種批次形態——
POST /v1/batch依你送出的請求主體接受 URL 清單、播放清單或頻道。 - 獨立狀態——失敗的連結會被單獨標記,絕不會丟棄批次中的其餘項目;失敗項目可以用
/retry重試。 - 分頁項目——用
GET /v1/batch/{batchId}讀取批次,然後跟隨回傳的 page token 取得剩餘項目。 - 即時進度——每次輪詢都回傳更新後的計數,呼叫方可以顯示長任務完成了多少。
- 依你的格式匯出——從
/export把完成的批次下載為txt、csv、json、srt、vtt或zip。
srt 和 vtt 匯出可以直接放進編輯器或播放器。對封存來說,csv、json 和 zip 讓整座錄影庫作為一個語料可供搜尋。這些格式與單筆轉錄的回應保持一致,所以能處理單筆結果的呼叫方,已經知道如何讀取批次。帳戶媒體庫中已儲存的轉錄
擷取與儲存是兩回事:轉錄一旦被儲存,就成為帳戶媒體庫的一部分,而媒體庫正是你之後讀取、搜尋、下載和刪除它的地方,無需重新執行擷取。
- 列出已儲存內容——
GET /v1/library/transcripts分頁走訪帳戶的轉錄、批次紀錄和失敗歷史列,支援搜尋、平台與語言篩選以及排序。 - 讀取單筆——
GET /v1/library/transcripts/{platform}/{externalId}依平台與外部 id 回傳已儲存的轉錄,或依你指定的語言回傳。 - 下載——
/download路由把已儲存的轉錄匯出為txt、srt、vtt、json或md。 - 相關內容——
/related路由列出同一頻道下其他已儲存項目。 - 刪除——
DELETE把項目從媒體庫移除,不會動到別人的副本。 - 限定帳戶的讀取——媒體庫請求只回傳該帳戶儲存的內容,絕不啟動新的擷取,所以回看一筆已儲存的轉錄是讀取,而不是又一個任務。
轉錄之外的 YouTube 探索能力
YouTube 是 API 還能回答轉錄周邊問題的平台,使用與 YouTube Data API 相同的資源命名。
- 搜尋——
GET /v1/youtube/search依查詢找影片、頻道或播放清單,回傳游標分頁結果。 - 影片——
GET /v1/youtube/videos回傳影片詳情,包括是否有可用字幕。 - 頻道——
GET /v1/youtube/channels依 id 或@handle解析頻道。 - 頻道上傳——
GET /v1/youtube/channels/{channelId}/videos走訪一個頻道的上傳。 - 播放清單項目——
GET /v1/youtube/playlists/{playlistId}/items走訪一份播放清單。 - 字幕——
GET /v1/youtube/captions回傳影片的字幕軌詮釋資料和字幕內文。它絕不啟動語音辨識任務:當它回報requiresAsync時,呼叫POST /v1/transcript來執行轉寫。
為正式環境而設計
介面刻意做得很小,服務真正在意的部分都有文件可依,而不是靠猜。
- 一組憑證——用 Bearer 權杖形式送出的 API 金鑰認證,或在指令稿、伺服器裡用
X-API-Key。 - 帶範圍的金鑰——只授予呼叫方需要的範圍,
transcripts和batches分別涵蓋擷取與批次工作。 - 結構化錯誤——擷取和驗證失敗回傳帶穩定
code與可讀message的錯誤物件;驗證 (401) 和限流 (429) 回應使用更簡單的扁平錯誤主體。 - 可執行的限制——被限流的請求回傳
429和Retry-After,成功回應會帶X-RateLimit-*標頭,讓用戶端能正確退避。 - 公開的契約——完整的 OpenAPI 文件支撐這套 API,你可以產生用戶端、模擬伺服器,或用 schema 驗證真實回應。
- 給代理的兄弟入口——如果你的呼叫方是 AI 用戶端而不是服務,同一個帳戶和工具也可以透過 transcript.im MCP 伺服器存取。
相關工具
轉錄 API 常見問題
transcript.im API 是什麼?
transcript.im API 是一個 REST 介面,把公開的影片或音訊連結轉換成帶時間戳的轉錄文字,優先使用既有字幕,影片沒有字幕時使用 AI 轉寫。
transcript.im API 支援哪些平台?
它會從你送出的連結辨識平台,擷取 YouTube、TikTok、Instagram、LinkedIn 和 Twitter/X 的轉錄。YouTube、TikTok 和 LinkedIn 優先使用字幕,以語音辨識作為後備;Instagram 和 X 沒有字幕軌,會直接走語音辨識。
影片沒有字幕時會怎樣?
當影片完全沒有字幕軌時,API 會啟動 ASR 任務並回傳 job id;你輪詢該任務直到轉錄準備好,所以請求不會因語音辨識而阻塞。
可以轉錄本機的音訊或影片檔案嗎?
可以。POST /v1/transcript 接受帶 file 部分的 multipart/form-data 請求主體,用它替代 URL。上傳的檔案會直接走語音辨識,因此回傳 202 任務——如果在等待預算內完成,則回傳 200 結果。
transcript.im API 能在回傳文字時一併帶上時間戳嗎?
可以。JSON 回應帶有帶時間戳的分段,文字回應可以保留每行的時間戳前置字串,因此你可以回到某句話被說出的那一刻。
如何請求特定語言的轉錄?
送出一個以逗號分隔的語言優先順序清單,包含 asr 和 asr-<code> 項目。字幕命中會直接回傳;當存在字幕但沒有一條符合清單時,請求會繼續走 AI 轉寫並回傳 202 任務,只有在不允許使用語音辨識時,才會回傳帶可用語言的 404。
如何知道非同步轉錄已經準備好?
用同一組憑證輪詢 GET /v1/transcript/job/{id},直到它回報成功或失敗,或訂閱 GET /v1/transcript/job/{id}/events 接收伺服器推送的更新。任務查詢在任務失敗時也回傳 200,所以請讀取 status 和 error 欄位,而不是 HTTP 狀態碼。
transcript.im API 支援批次擷取嗎?
支援。一個批次接受 URL 清單、播放清單或頻道,追蹤每個項目的狀態,並分頁回傳項目。
可以下載哪些匯出格式?
完成的批次可匯出為 txt、csv、json、srt、vtt 或 zip;單筆已儲存的轉錄可下載為 txt、srt、vtt、json 或 md。
已儲存的轉錄放在哪裡?
帳戶媒體庫就是已儲存的轉錄和批次紀錄所在之處,位於 /v1/library 下。它提供列出、讀取、下載、相關和刪除路由,讀取限定在帳戶範圍內,絕不啟動新的擷取。
YouTube 字幕端點回傳什麼?
GET /v1/youtube/captions 回傳影片的字幕軌詮釋資料以及字幕內文。它絕不啟動語音辨識任務;當它回報 requiresAsync 時,呼叫 POST /v1/transcript 來執行轉寫。
transcript.im API 如何回報錯誤和限流?
擷取和驗證錯誤使用帶 code 和 message 的物件;驗證回傳扁平的 401,限流回傳扁平的 429,並帶 Retry-After 和 X-RateLimit-* 標頭,讓用戶端能正確退避。