
MCP 伺服器
給 AI 代理的 transcript.im MCP 伺服器
transcript.im MCP 伺服器為 AI 用戶端提供一個可直接呼叫的逐字稿工具。把 Claude、ChatGPT、Cursor 或 OpenAI Agent Builder 指向伺服器並提供 API 金鑰,模型就能從公開連結取得逐字稿、啟動批量任務、匯出字幕或檢索 YouTube,不需瀏覽器,也不需客製整合。它是遠端 HTTP 端點,因此託管用戶端只需要 URL 和金鑰,不需要本機安裝。
- 一個遠端端點
https://mcp.transcript.im/mcp,以你的 API 金鑰驗證,無需安裝。 - 11 個工具,涵蓋逐字稿、批量、匯出、YouTube 檢索與用量。
- 不含 AI 工具——模型已在你的用戶端執行;伺服器只提供逐字稿與平台資料。
- 與 REST API 相同的帳戶、相同的抽取流程。
- 長逐字稿以分頁權杖切分,單一結果不會淹沒上下文視窗。
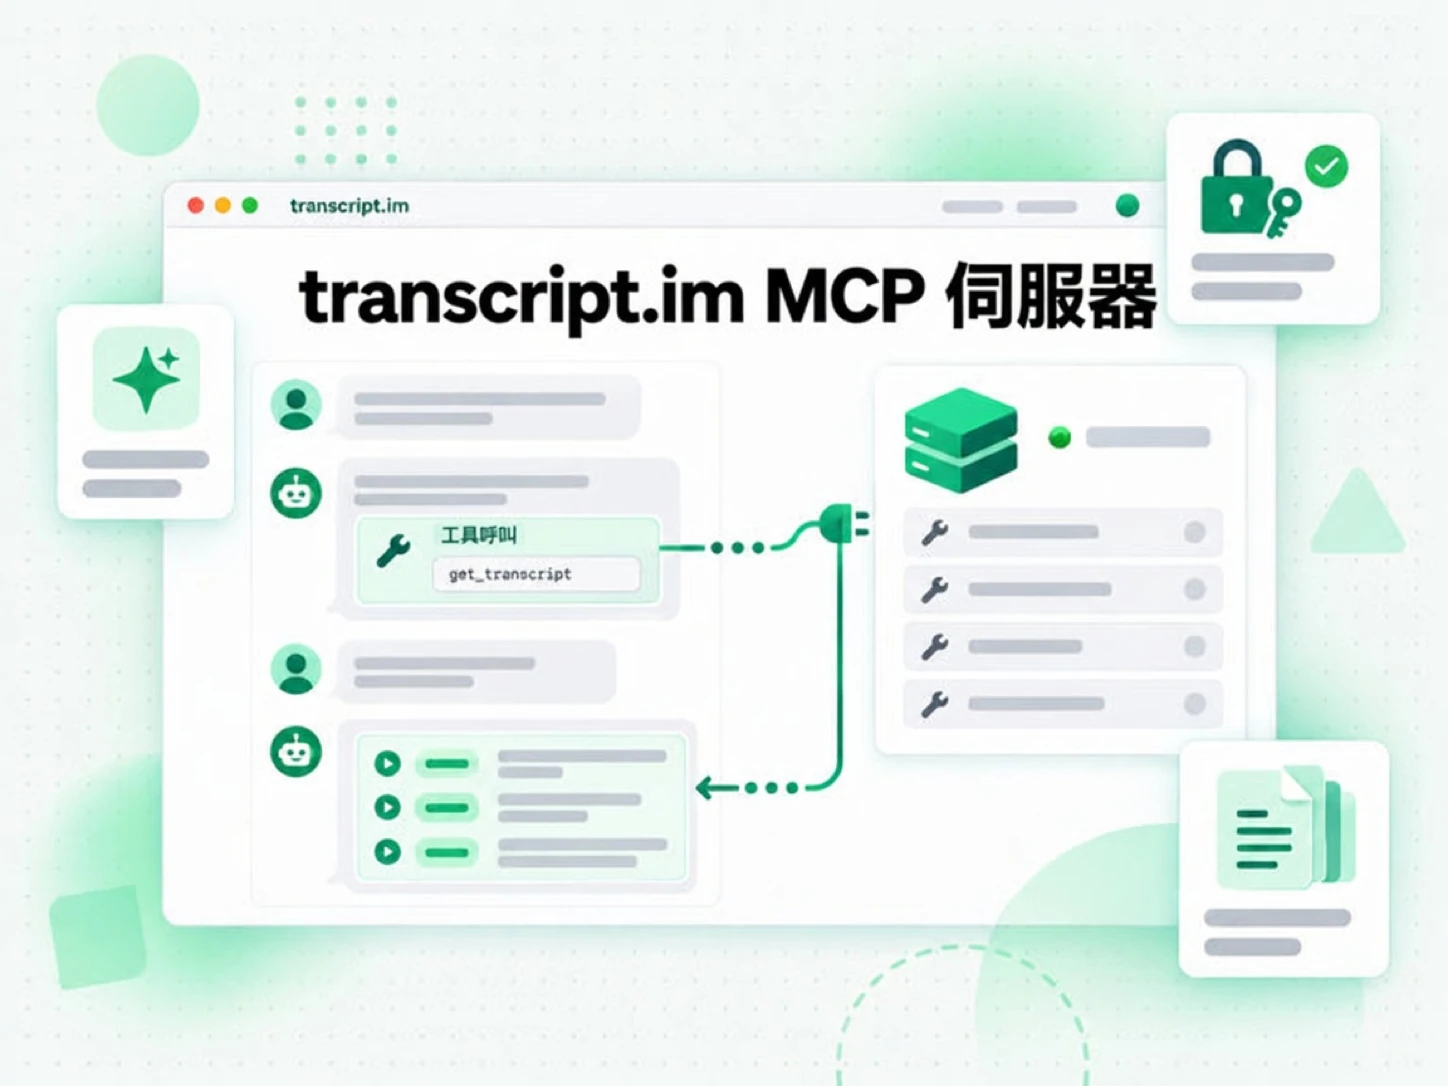
transcript.im MCP 伺服器做什麼
Model Context Protocol 讓用戶端探索並呼叫伺服器發布的工具。transcript.im MCP 伺服器把這套介面用在一件事:把公開的影片或音訊連結變成逐字稿,並回答圍繞它的平台問題。用戶端帶上 URL 呼叫 get_transcript;伺服器接入 transcript.im 抽取流程,有創作者字幕時優先使用,沒有時退回 AI 轉錄。
- 把逐字稿抽取當成工具——一次呼叫就把連結變成帶時間戳的文字。
- 還有 YouTube 檢索——搜尋影片、解析頻道、列出上傳與播放清單項目,並讀取字幕中繼資料。
- 批量與匯出——把許多連結排入佇列,再匯出完成的結果集。
- 內部不含模型——伺服器回傳資料,由用戶端決定怎麼用。
你的代理可以呼叫的工具
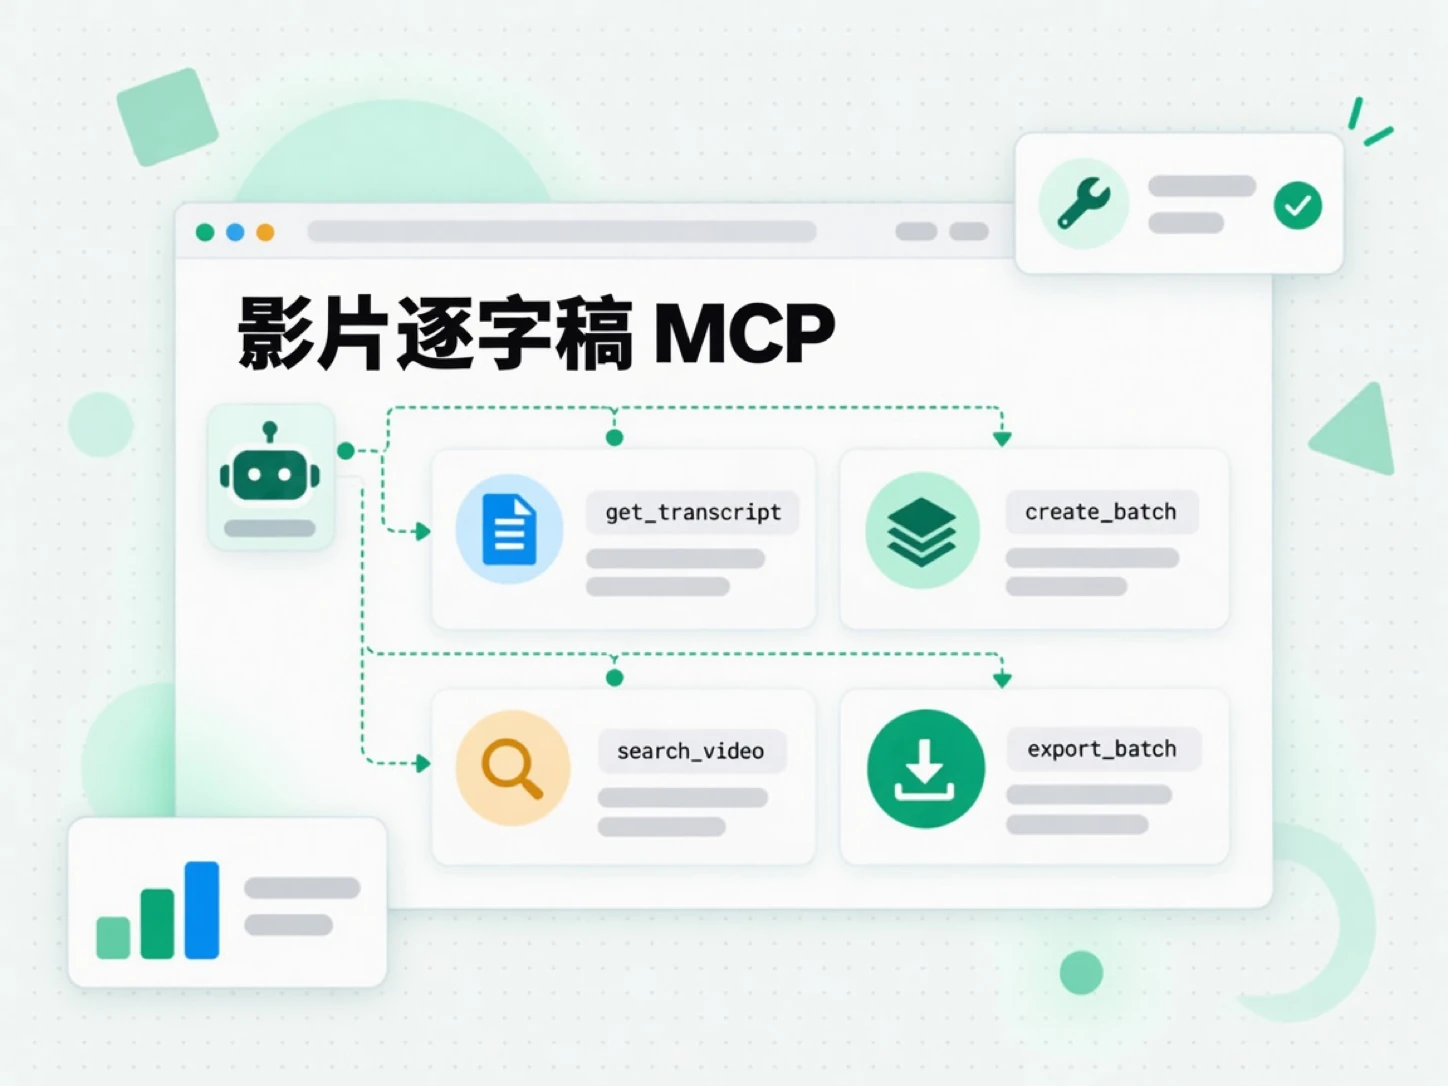
逐字稿
get_transcript 從 URL 抽取逐字稿,或讀取長逐字稿的下一段;get_transcript_info 在你決定抽取前回傳影片中繼資料與 API 能解析到的字幕軌。兩者搭配,代理可以判斷某支影片是否值得轉錄、要求真正需要的語言優先序,再取得帶或不帶時間戳的文字。
批量與匯出
create_batch 從 URL 清單、播放清單或頻道啟動一次執行;get_batch 回報狀態、計數與下一頁項目;export_batch 把完成的批量轉成文字或字幕。代理因此能處理某位創作者的全部內容,而不是一次一個片段;單一連結失敗會被單獨回報,而不會丟棄其餘結果。
YouTube 檢索
search_video 依主題尋找影片或頻道,get_channel 解析 handle 或 URL,list_channel_video 列出頻道上傳,list_playlist_item 走訪播放清單,list_caption 讀取影片的字幕中繼資料與逐字稿文字。代理用這些工具研究利基、查看創作者發布過什麼,並在轉錄之前選對來源。
帳戶
get_usage 回報帳戶的用量摘要,讓代理在投入大批量或長頻道前看到帳戶已經用了多少,而不是執行到一半才發現限制。
連接你已經在用的用戶端
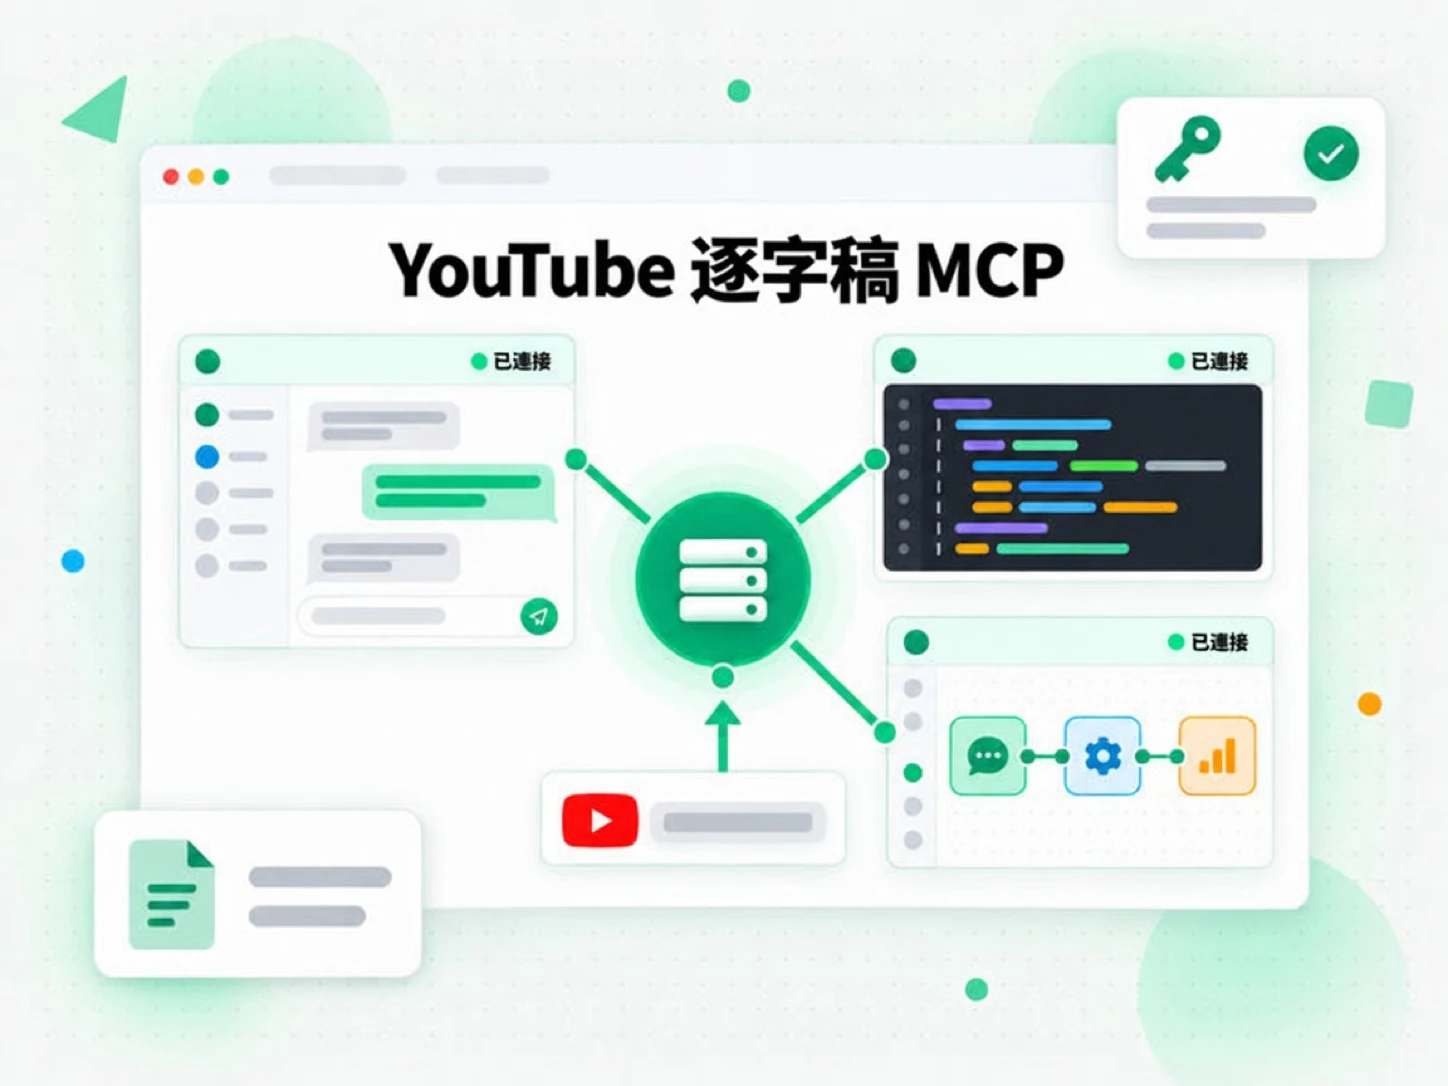
Claude
把遠端伺服器加為自訂連接器,或從命令列註冊。Claude 會與 MCP 伺服器協商,把工具暴露到對話中,並在多輪之間保持可用,因此你可以用自然語言要一份逐字稿,緊接著再要一份摘要,而不必重複連結。
ChatGPT
加入 MCP 連接器並選擇 API 金鑰驗證。ChatGPT 接著會像呼叫其他已連接應用一樣呼叫逐字稿工具,這表示聊天中貼上的影片連結可以變成模型能引用、翻譯或分析的文字。
Cursor 與其他編輯器
把編輯器的 mcpServers 設定連同 API 金鑰指向遠端 URL。編輯器的代理就能轉錄連結,並把結果直接寫進你的專案或筆記。
OpenAI Agent Builder
用伺服器 URL 與 Bearer 憑證加入一個 MCP 工具,代理就能把逐字稿當成更大工作流程中的一步,把文字交給後續環節,而不需客製連接器。
連接與驗證
伺服器是遠端 HTTP 端點,因此連接用戶端只需 URL 和金鑰,而不是安裝。
- 遠端 HTTP——把
https://mcp.transcript.im/mcp加入你的 MCP 用戶端;你的機器上不需執行任何東西。 - API 金鑰——把金鑰以
Authorization: Bearer <key>或x-api-key送出;伺服器會把它轉送給 REST API,因此適用同一個帳戶與同一套權限。 - 工具探索——端點會回應 MCP 探索請求,用戶端可以在呼叫之前列出它暴露的工具。
- 結果一致——工具、分塊與錯誤都和同一帳戶從 REST API 得到的一致,因此行為不取決於用戶端。
長逐字稿依然可控
兩小時的錄音可能產生遠超模型單一工具結果應接收的文字,因此伺服器把長逐字稿以有界分塊回傳。每個分塊會回報 truncated: true 與不透明的 nextPageToken;只帶該權杖再次呼叫 get_transcript 會回傳下一段,代理重複此過程直到逐字稿取完。
- 結果有界——每個分塊都有上限,單一結果不會淹沒上下文視窗,也不會擠掉先前的推理。
- 無狀態分頁——權杖攜帶位置,呼叫之間不保留伺服器工作階段,因此任何副本都能提供下一段。
- JSON 分頁——JSON 逐字稿依片段分頁,結構化消費方可以在走訪文字時保持自己預期的 schema。
- 任務輪詢——沒有字幕的影片會回傳一個任務 ID,代理輪詢它直到逐字稿就緒。
- 開頭可讀——第一段就足以回答關於開頭的問題,簡短的追問不必拉取整份逐字稿。
你的代理能據以行動的錯誤
當工具呼叫失敗時,伺服器回傳帶有可讀文字的 MCP 錯誤,而不是堆疊追蹤。結構化細節隨結果一同回傳,讓代理可以復原而不是猜測:code、HTTP status、達到限制時的 upgradeUrl,以及要求的語言不可用時的 availableLanguages。這把死路變成下一步動作——換一種語言、換一個連結,或把限制告訴對話中的人。能讀懂失敗原因的模型可以修正自己的下一次嘗試,這正是能有效重試的代理與卡在同一個壞呼叫上的代理之間的差別。
相關
MCP 伺服器常見問題
transcript.im MCP 伺服器是什麼?
transcript.im MCP 伺服器是一個 Model Context Protocol 介面,把逐字稿抽取、批量任務、匯出與 YouTube 檢索當成 AI 用戶端可呼叫的工具暴露出來。
哪些用戶端可以連接 transcript.im MCP 伺服器?
Claude、ChatGPT、Cursor、OpenAI Agent Builder 以及任何其他 MCP 用戶端都可以用 API 金鑰連接遠端 HTTP 端點。
transcript.im MCP 伺服器包含 AI 工具嗎?
不包含。伺服器刻意只暴露資料與抽取工具,因為負責摘要或改寫的模型已由用戶端執行。
代理如何從影片連結取得逐字稿?
它帶上連結呼叫逐字稿工具;伺服器優先使用現有字幕,沒有時退回 AI 轉錄,並回傳帶時間戳的文字。
MCP 伺服器如何處理長逐字稿?
長逐字稿以有界分塊回傳。每個結果帶有截斷旗標與分頁權杖,代理用該權杖再次呼叫工具讀取下一段。
代理可以透過 transcript.im MCP 伺服器執行批量嗎?
可以。批量工具接受 URL 清單、播放清單或頻道,回報狀態與計數,並把完成的結果集匯出為文字或字幕。
transcript.im MCP 伺服器支援 YouTube 搜尋與頻道嗎?
支援。專用工具涵蓋影片與頻道搜尋、頻道解析、頻道上傳、播放清單項目與字幕中繼資料。
MCP 伺服器如何驗證用戶端?
它接受作為 Bearer 權杖或 x-api-key 標頭的 API 金鑰,並轉送給 REST API,因此其呼叫與直接 API 請求落在同一個帳戶上。