
翻譯 YouTube 逐字稿並保留時間戳
先生成 YouTube 逐字稿,再翻譯成目標語言,每句都保留原本的時間戳。
把 YouTube 影片轉成文字,作法是先記下說過的內容,再翻譯這些台詞。被翻譯的不是畫面,而是說出來的話。YouTube 可以在影片播放時顯示字幕,某些影片甚至能由播放器在畫面上疊出翻譯字幕,只要你還在看就一直顯示。但你一離開,那層疊字也跟著消失。一份能讓你引用、搜尋或轉交給他人的翻譯,是已經翻好的逐字稿,而且每一行仍對應到原本的時間點。
YouTube 的檢視逐字稿說明頁介紹的是閱讀檢視:在說明欄中開啟 顯示轉錄稿,跟著目前這一行看,點選某一行即可跳轉。它沒有說明翻譯後的文件,也沒有說明如何儲存。本頁接下來要講的,就是產出這份文件的順序。先產生逐字稿。再翻譯台詞。時間要留在原本的位置。
為什麼要翻譯逐字稿
要翻譯的是逐字稿,而不是影片檔案,理由是真正會反覆用到的東西是文字。一堂你用讀的比用聽的更能吸收的課、一句你必須用筆記語言引用的主張,以及一段你要替另一群觀眾上字幕的剪輯,全都從同一個東西出發:化為文字的說出來的話。翻譯 MP4 不會產生這些文字。配上一條新的配音也不會。那些是不同的工作,本頁不談。
有些觀眾只需要那層疊字。如果播放器已經顯示翻譯,而你也只看這麼一次,那就留在那裡就好。但當你關掉分頁後還需要那些字句、當你要搜尋某個詞,或當翻譯必須搬進文件或編輯器時,就得離開疊字。疊字是顯示,逐字稿才是文字。
逐字稿也為「什麼能被翻譯」畫出一條清楚界線。說話內容在範圍內。烙印在畫面裡的標題卡、下三分之一字卡,以及其他直接畫進畫面的文字並不會被讀取,所以也不會被翻譯。一支幾乎沒有或完全沒有說話的音樂影片,產出會很單薄,因為沒多少話可記。兩個人同時開口、吵雜的環境、悶住的麥克風,都會削弱來源台詞,而翻譯救不回一行原本就錯的內容。在你把翻譯當成引文之前,先對照時間戳讀一下原文。
連結必須是公開的。私人影片、已刪除的影片、僅限會員的影片,或只能在別人的帳號內播放的連結,都無法用貼上的公開網址開啟。年齡限制與地區限制也可能擋下同一個請求。YouTube 不願提供的影片,沒有哪個開關能強迫它提供。
先產生,再翻譯
翻譯是第二步。第一步是逐字稿,以字幕或說話原本的語言呈現。跳過這一步,就沒有成行的東西可以翻譯。摘要、留言串或影片說明都不能代替。它們不是說出來的順序,也不會為每一行附上時間。
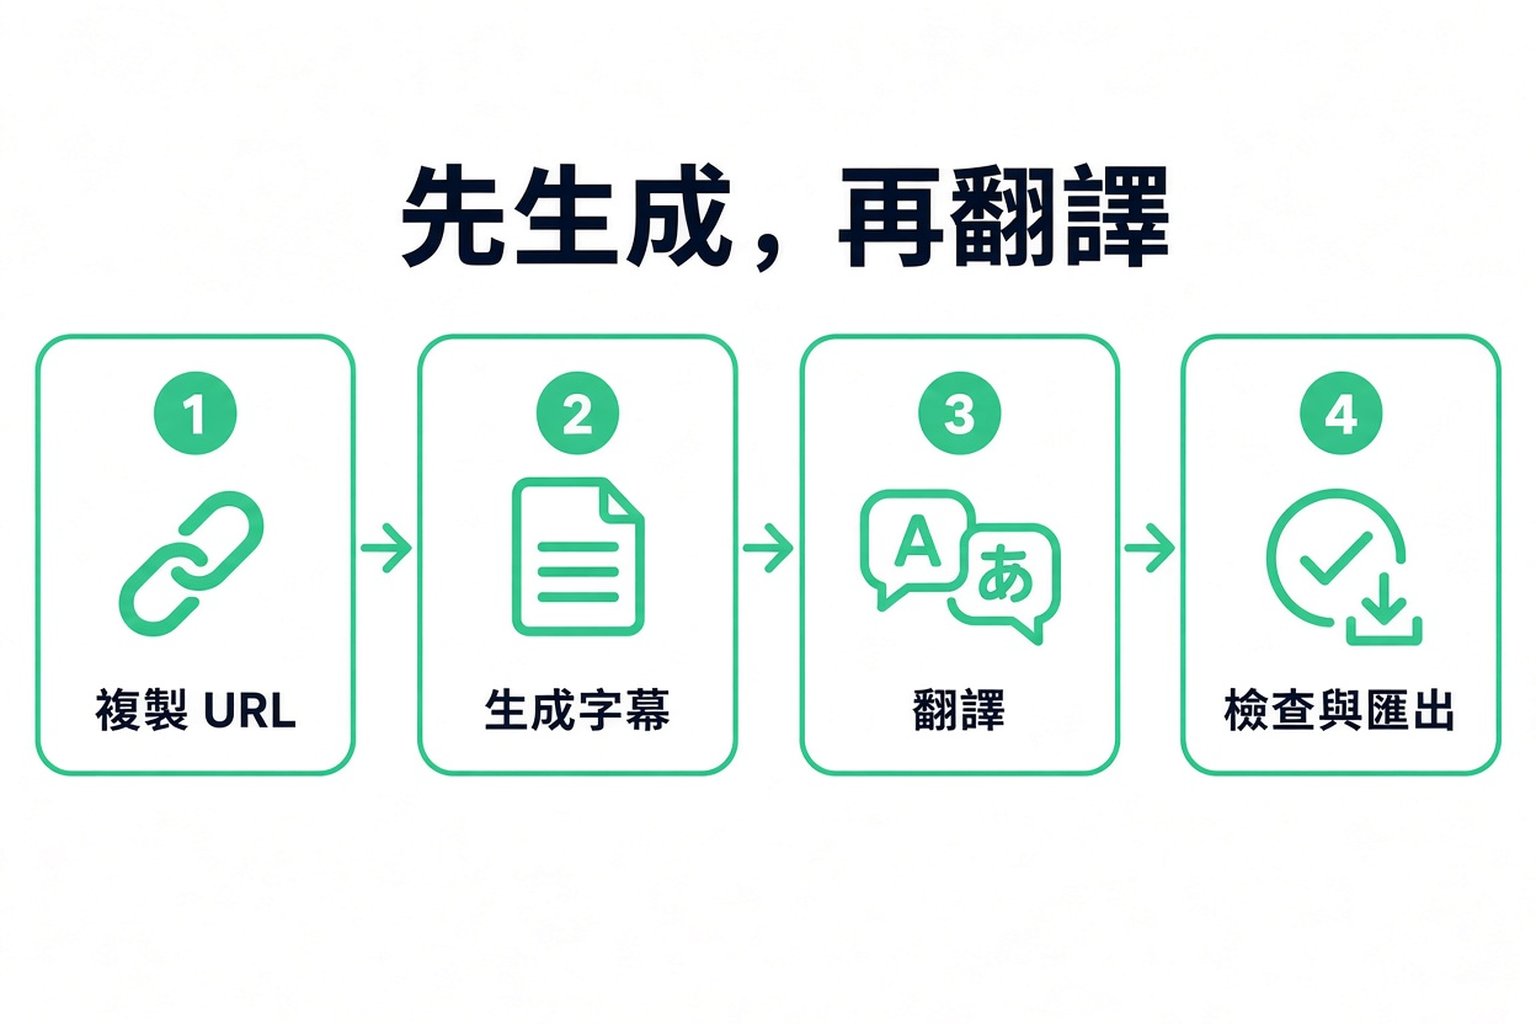
在 transcript.im 上,請照這個順序做:
- 複製你想換成另一種語言的公開影片網址。
- 貼上網址並產生台詞,然後才選目標語言。影片上原本就有的字幕就是來源。只有在沒有這些字幕時,才會去轉錄說話內容。
- 對這些台詞執行「翻譯」,並挑選一種支援的語言。字句會改變,YouTube 上的原始上傳不會。
- 對照原本的時間檢查翻譯後的每一行。當翻譯必須存在瀏覽器之外時,就匯出。
要翻譯 YouTube 逐字稿,你手上已經有連結。你不必重新上傳影片,也不必手動輸入翻譯,除非你之後要修正某一行。修正只會留在你的副本裡,不會寫回原始上傳。
目標語言是支援清單中的其中一種:阿拉伯文、中文(簡體)、英文、法文、德文、印地語、義大利文、日文、韓文、葡萄牙文、俄文與西班牙文。這裡的中文是簡體,並不是另一個繁體目標。葡萄牙文是一個目標,不分國家。如果你需要的語言不在清單上,這一步不會無中生有。挑一個工具真正提供的目標,或把匯出的文字拿到確實提供該語言的地方翻譯,並接受第二個工具可能不會保留時間碼,除非你自己帶著走。
來源語言就是字幕或說話原本的語言。一支以日語講述的影片,會先產生日語台詞,即使你打算讀西班牙文也一樣。翻譯是之後才選的目標,換一個目標,就是對同一批來源台詞再做一次不同的翻譯。從西班牙文切換到德文,並不會把西班牙文結果改成德文,而是重新翻譯來源。
自動字幕只要存在,仍然是來源。它的好壞,就取決於那條字幕軌。人名、口音,還有語速快的附帶閒談,都是它容易出錯的地方。對於從來沒有字幕的影片,直接從音訊轉錄,也有同樣的限制:文字只能跟著錄音走。先看過你在意的那一行原文,再翻譯,不要還沒看就翻。
讓時間軸保持對齊
時間維持不動,因為翻譯不會重建時間軸。每一行都保留措辭改變前的開始時間與長度。只有文字被替換掉。原本在 1:02 開始的句子,翻譯後仍在 1:02 開始,即使新的措辭比原文更長或更短也一樣。
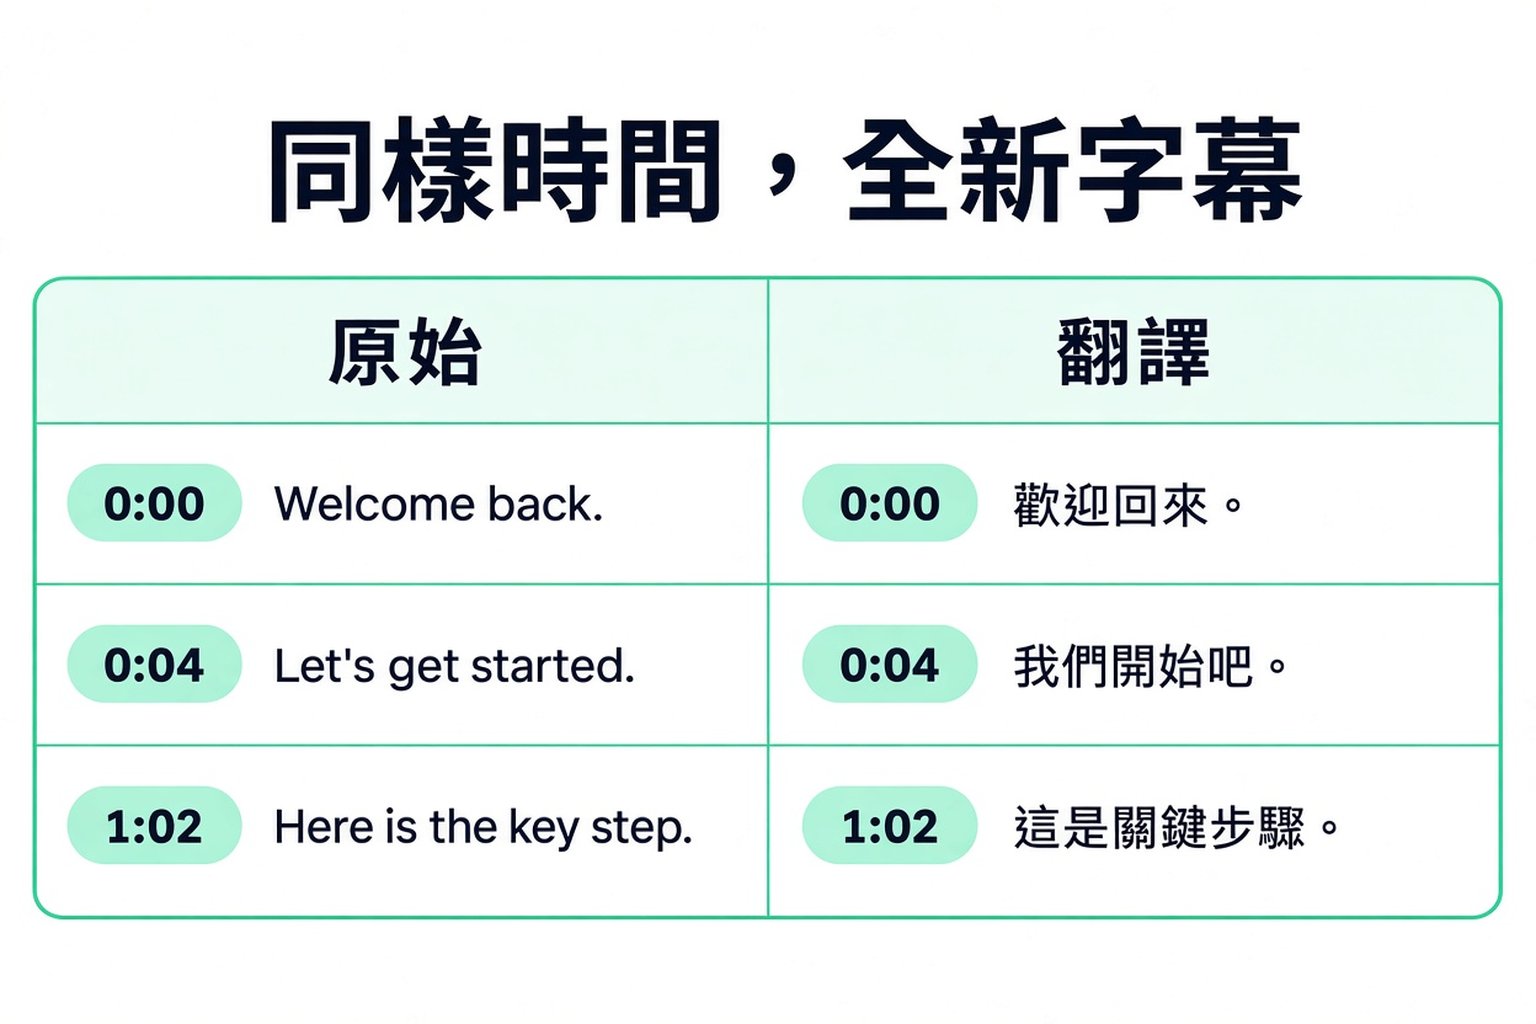
翻譯就是這樣緊扣著影片中的那個時刻。翻譯後的那一行,是貼在原始瞬間上的標籤,而不是一段自有節奏的新演出。行旁邊的時間,仍然是來源影片中的那個瞬間。你聽到的是原音,讀到的是翻譯。你不會聽到配音,因為並沒有製作新的音訊。
匯出時用的也是同一組時間。翻譯的 TXT 只有翻譯後的文字,每個 cue 一行,不含時間。SRT 和 VTT 則保留開始與結束時間,讓剪輯軟體或網頁播放器能顯示翻譯後的 cue。結束時間就是原始那一行的結束時間,並經過修剪,以免和下一個 cue 重疊。播放器就會一次顯示一行,而不是把兩行疊在一起。
較長的翻譯,正是人們容易誤解的地方。cue 不會為了配合新句子而變長。文字必須塞進原本的時間範圍內。一行簡短的英文變成一行冗長的德文,仍然會在原始 cue 結束時結束。在畫面上,播放器可能會把更多文字折行,塞進同一段時間裡。這個檔案並沒有把影片重新對時,去配合一個念出翻譯的嗓音。如果你之後要錄配音,得自己為那段配音對時。這個匯出不會幫你代勞。
閱讀器可以在你核對時,在每一行翻譯旁顯示開始時間。複製段落時的情形就像 TXT 匯出,只帶走文字,捨去時間。如果時間必須跟著句子一起走,就用 SRT 或 VTT,或在貼進筆記的句子旁邊寫下時間。對齊只有在緊跟著你即將引用的那一行時,才有意義。
清理(Clean)如果你有跑,是另一道不同的處理。它會修正文字裡的文法、標點和辨識錯誤,並保留時間。它不是翻譯。翻譯(Translate)才是改變語言的那道處理。當某一行亂掉時,先對原文跑清理,再翻譯,這樣才不會把一個辨識錯誤,翻譯成另一種語言裡一句理直氣壯的錯句。
常見誤解
最常見的失誤,是翻譯錯了對象。螢幕上的標題、被攝影機拍到的投影片,以及烙印在畫面裡的硬字幕,都不在 YouTube 逐字稿裡,所以不會以另一種語言呈現。如果影片的意思藏在那些圖文裡,而旁白從來沒說出口,翻譯也找不回來。你讀到的,會只有講出來的話。
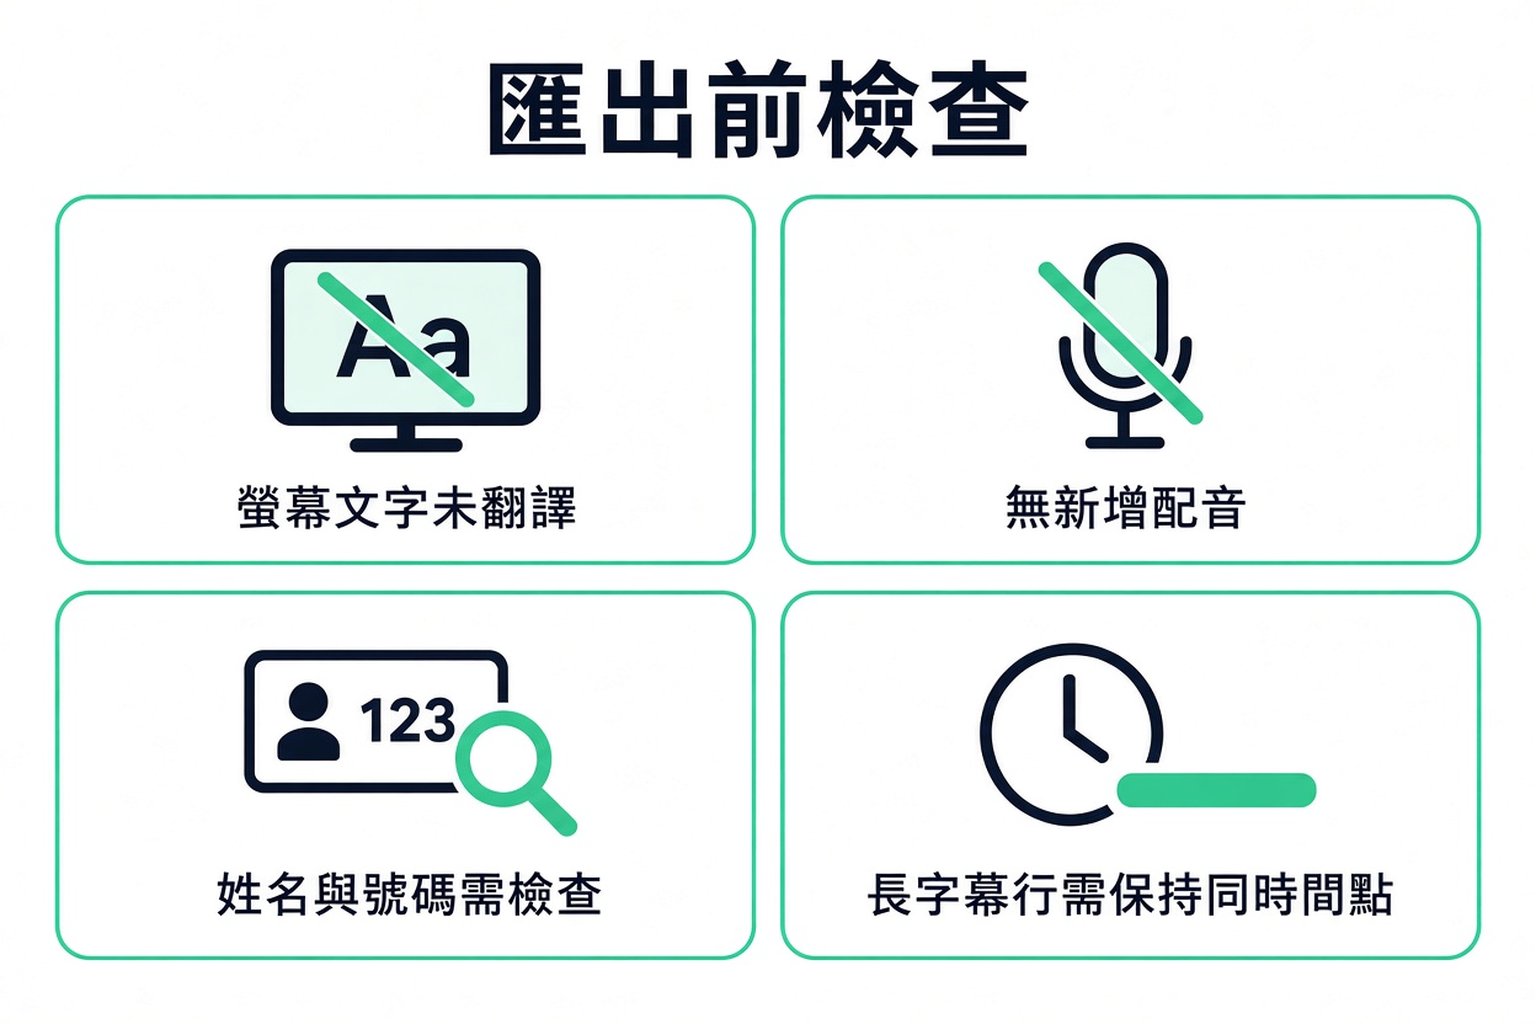
下一個誤解,是以為會有全新的音軌。把 YouTube 影片轉成文字,你能留下來的是措辭。你不會得到替代的嗓音、對嘴的配音,或以翻譯句長重新建立的時間軸。原始音訊仍然是計時的基準。配音是另一回事的剪輯。
另一個誤解,是把簡短的重述拿來翻譯,卻期待有逐行的時間。摘要、重點和章節摘要,都是同一份 YouTube 逐字稿的簡短檢視。在你逐行讀完之前,它們很好用。它們不是翻譯後的逐字稿,也不會給你每個口說行對應一個帶時間的 cue。能保持對齊的翻譯,是直接跑在逐字稿的行上。Study Notes、Meeting Summary、Creator Repurpose、Moments 和心智圖,都是那份文字的其他檢視方式。它們都不是語言轉換。心智圖可以把節點指向某個時刻,方便你瀏覽。但它仍然不是每一行的翻譯措辭。
專有名詞、數字和慣用語,都需要人工檢查。一個名字可能被音譯、半翻譯,或直接照聽到的樣子留下來。依賴原文語言的笑話,禁不起逐字直譯。在你把翻譯當成講者原話引用之前,先打開時間戳聽一下。翻譯是那一行的詮釋。錄音才是來源。
短 cue 裡的快語,和冗長的翻譯有一樣的實際限制。時間範圍是由原始那一行決定的。如果你把 SRT 丟進剪輯軟體,覺得翻譯後的 cue 太擠,就在剪輯軟體裡把那個 cue 切開或改寫。不要指望匯出會把那個時刻拉長。
幾乎沒有講話的影片,翻譯出來也幾乎什麼都沒有。沉默、音樂和掌聲都不是句子。如果逐字稿只有寥寥幾行,翻譯也只會有寥寥幾行。那是來源本身的性質,不是目標語言失敗。
如果逐字稿一直沒開始,翻譯就永遠不會啟動。最常見的原因是影片無法公開存取。
如果目標是給播放器使用的時間軸字幕軌,請匯出翻譯後各行的 SRT 或 VTT。關於從 YouTube 連結建立這類字幕軌(當成字幕,而非閱讀文字)的頁面,請見 YouTube 字幕產生器。當你要的是翻譯後的用字,包括那份用字的時間軸檔案時,請用本文;當你要的是字幕軌本身時,則改用字幕產生器。
字幕疊加夠用時,就配著它觀看。當你需要另一種語言的文字,並附上原始時間點時,就產生逐字稿、翻譯各行,並保留時間。YouTube 逐字稿產生器 正是把那個公開連結變成你接下來要翻譯的文字的地方。