
REST API
API de transcription pour la vidéo et l'audio
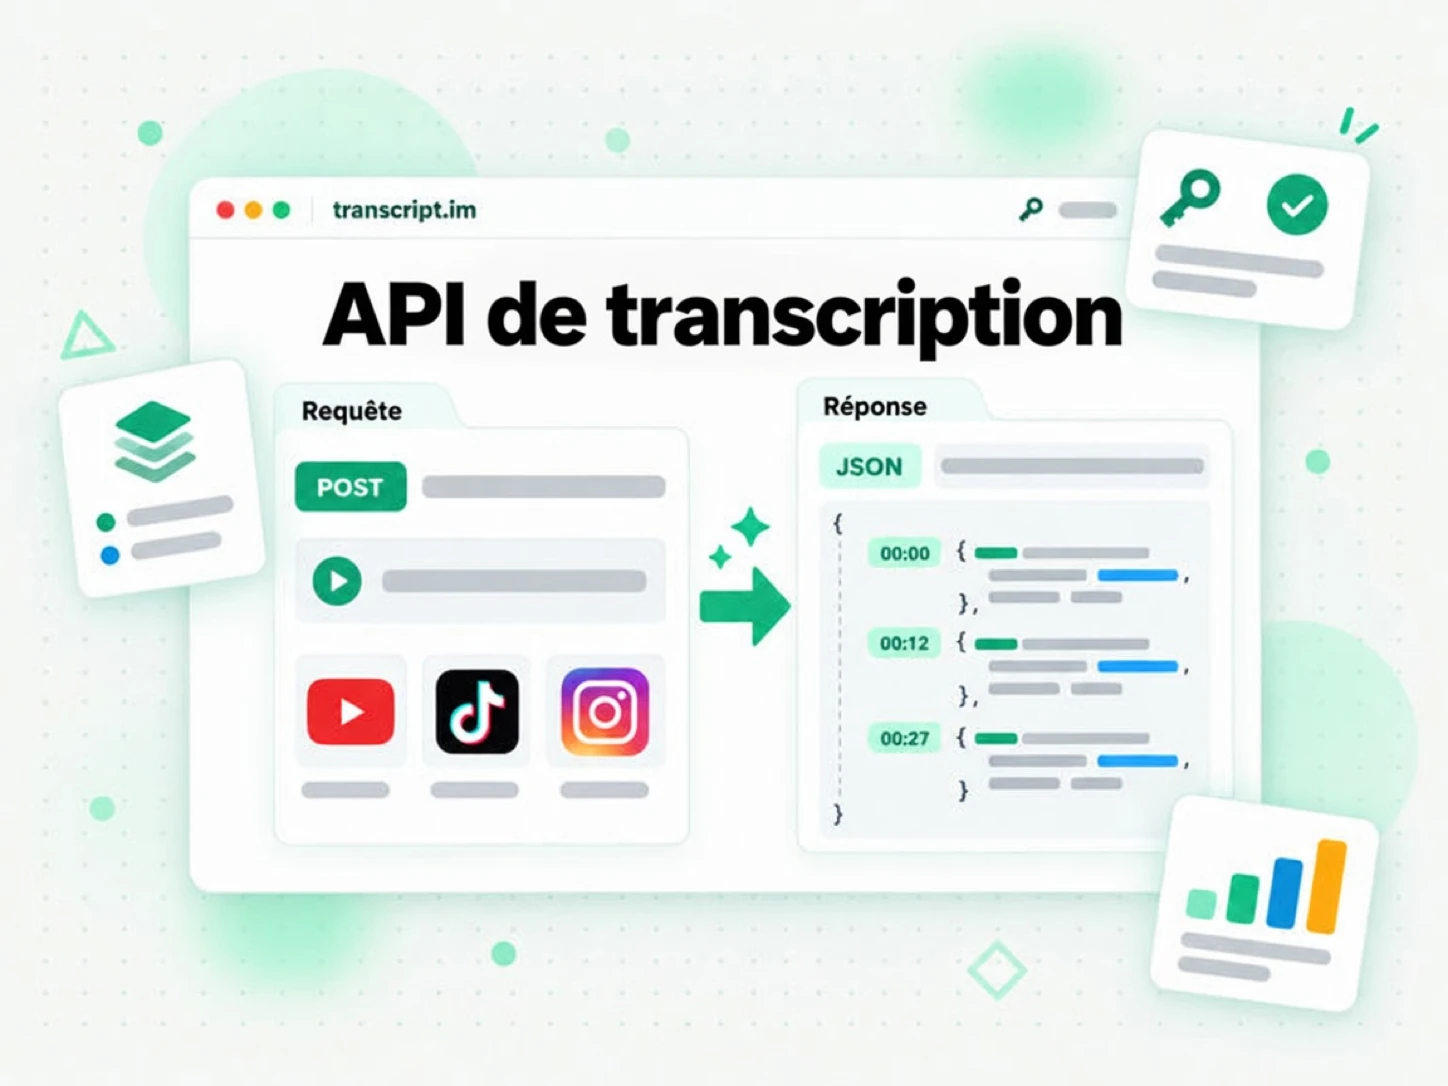
transcript.im expose en API versionnée le même pipeline d'extraction que celui qui fait tourner le produit. Envoyez une URL de vidéo ou d'audio et recevez du texte horodaté, en JSON ou en texte brut, avec la plateforme détectée pour vous. Les sous-titres existants sont utilisés en priorité ; quand une vidéo n'en a aucun, l'IA transcrit l'audio et le résultat est livré de façon asynchrone.
- Une seule
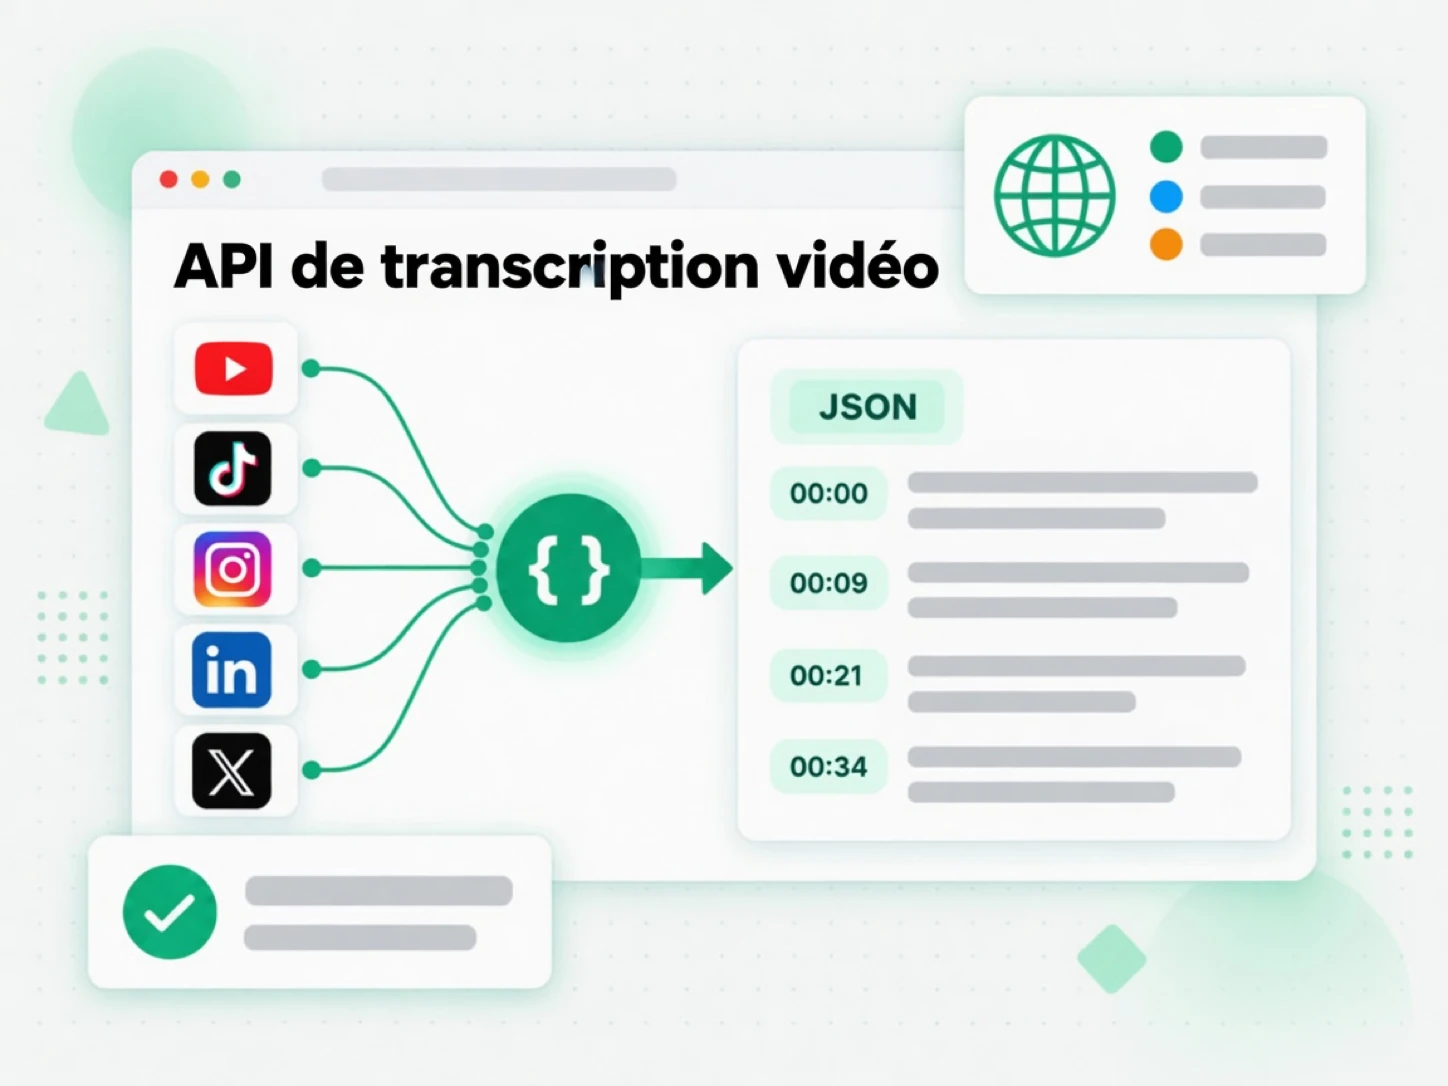
urlaccepte un lien complet ou court et détecte YouTube, TikTok, Instagram, LinkedIn et Twitter/X ; pour YouTube, un simple id de vidéo est aussi reconnu, etplatformavecexternalIdcouvrent une source que vous connaissez déjà. - Les sous-titres sont utilisés en priorité ; quand une vidéo n'en a aucun, l'IA transcrit l'audio, et un fichier local envoyé passe toujours par la reconnaissance vocale.
format=jsonrenvoie des segments horodatés, tandis queformat=textrenvoie du texte brut prêt à coller.- L'extraction par lots couvre les listes d'URL, les playlists et les chaînes.
- L'export par lots couvre txt, csv, json, srt, vtt et zip ; une transcription enregistrée se télécharge en txt, srt, vtt, json ou md.
- Les transcriptions enregistrées vivent dans la bibliothèque du compte, et la découverte YouTube couvre la recherche, les vidéos, les chaînes, les publications, les playlists et les sous-titres.
- Le contrat complet est publié sous forme de document OpenAPI.
Ce que fait l'API transcript.im
L'API transcript.im transforme un lien public de vidéo ou d'audio en une transcription horodatée que votre produit peut lire, stocker, rechercher ou transmettre à un modèle. Vous envoyez une URL ; l'API résout la plateforme, cherche la piste de sous-titres que le créateur possède déjà et renvoie le texte écrit avec un horodatage à chaque ligne. Quand une vidéo n'a aucun sous-titre, l'API ne s'arrête pas sur une erreur : elle bascule vers la transcription IA de l'audio parlé pour que la même requête produise quand même du texte.
- Une requête, du vrai texte : résolvez un lien et renvoyez des segments de transcription horodatés ou du texte brut.
- Les sous-titres d'abord, l'IA ensuite : utilisez la piste du créateur quand elle existe, transcrivez l'audio quand elle n'existe pas.
- Asynchrone par défaut pour l'ASR : un job id vous permet d'interroger une longue transcription sans bloquer.
- Conscient de la langue : demandez une priorité de langue et relisez la langue que l'API a résolue.
- Indépendant de la plateforme : l'appelant n'a pas besoin de savoir où la vidéo est hébergée.
Une API de transcription pour cinq plateformes
YouTube
Des transcriptions pour toute vidéo publique YouTube, Short ou enregistrement en direct, en utilisant d'abord les sous-titres du créateur et la transcription IA quand ils manquent. YouTube est aussi la plateforme dotée d'une surface de découverte complète — recherche, vidéos, chaînes, publications, playlists et sous-titres — disponible aux côtés de la transcription elle-même. Le catalogue d'une chaîne ou une playlist devient un lot de transcriptions horodatées, tandis qu'un simple lien revient sous forme de texte lisible que vous pouvez rechercher.
TikTok
Des transcriptions pour les vidéos publiques TikTok, avec les sous-titres utilisés d'abord et la reconnaissance vocale comme solution de repli. Collez un lien de vidéo et lisez le contenu parlé sous forme de texte propre et horodaté que vous pouvez réutiliser, traduire ou citer. Le même appel couvre un court clip et une publication plus longue, donc une tendance, un tutoriel et une vidéo face caméra reviennent tous sous forme de texte.
Des transcriptions pour les Reels et publications vidéo publics Instagram. Instagram n'a pas de piste de sous-titres à lire, l'extraction passe donc par la reconnaissance vocale asynchrone : envoyez le lien, interrogez le job et récupérez le texte quand il est prêt. Un Reel devient ainsi citable et recherchable, même si la plateforme n'a jamais publié ses mots sous forme de texte.
Des transcriptions pour les publications vidéo publiques LinkedIn, avec les sous-titres utilisés d'abord et la reconnaissance vocale comme solution de repli. Le résultat revient horodaté, donc une conférence, un clip produit ou une réunion enregistrée devient un texte recherchable que vous pouvez citer et réutiliser. Tirez l'argument d'un enregistrement de webinaire ou transformez l'actualité d'un fondateur en brouillon que vous pouvez modifier.
Twitter/X
Des transcriptions pour les publications vidéo publiques X. X n'a pas de piste de sous-titres à lire, l'extraction passe donc par la reconnaissance vocale asynchrone : envoyez le lien, interrogez le job et récupérez un texte horodaté que vous pouvez rechercher. Citez une vidéo avec précision ou archivez son contenu parlé avant que la publication ne soit modifiée ou supprimée.
Le parcours d'une requête de transcription
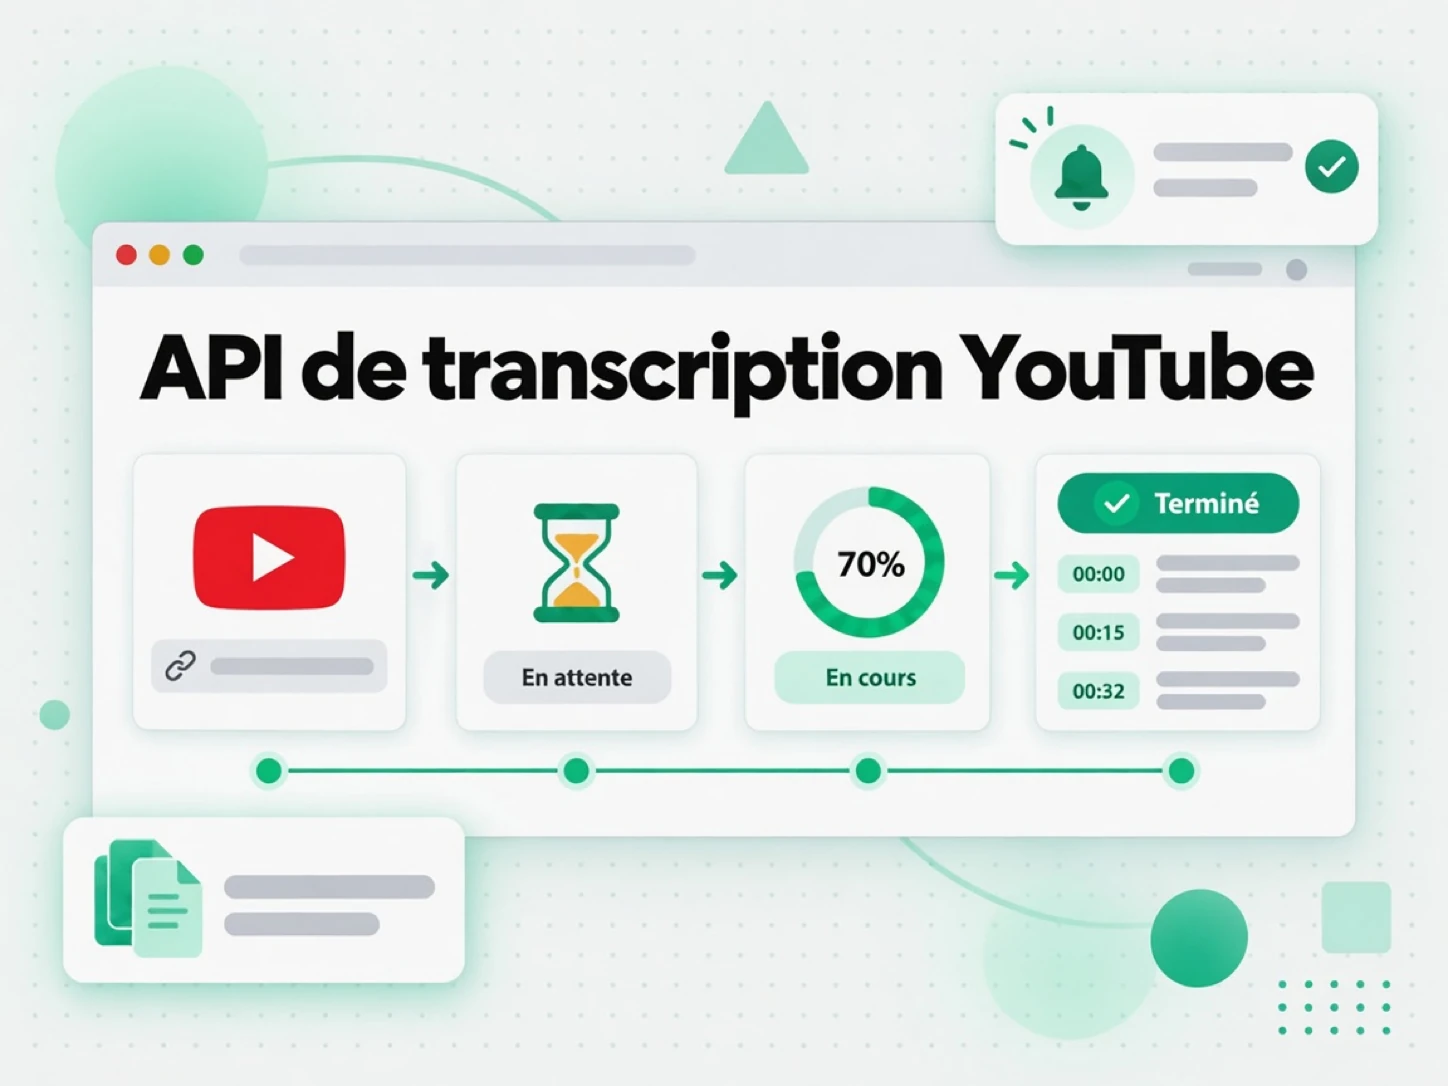
Un seul appel mène un lien ou un fichier envoyé de l'entrée jusqu'à la transcription, et l'API vous indique quel chemin elle a pris.
- Envoyez la source : publiez une
url, passezplatformetexternalIdquand vous les connaissez déjà, ou envoyez un fichier enmultipart/form-datavers le même endpoint. - Obtenez une correspondance de sous-titres : quand la vidéo porte des sous-titres dans une langue de votre liste, la transcription revient dans la réponse.
- Gérez une langue absente : quand des sous-titres existent mais qu'aucun ne correspond à votre liste, la requête continue vers la transcription IA et renvoie
202avec un job id ; un404avecavailableLanguagesn'est renvoyé que lorsque la reconnaissance vocale n'est pas autorisée pour l'appelant. - Forcez l'ASR ou repliez-vous dessus : une entrée
asrexplicite, une vidéo sans aucune piste de sous-titres ou un fichier envoyé démarre un job ASR et renvoie un job id. - Interrogez ou diffusez : lisez le job avec
GET /v1/transcript/job/{id}jusqu'à sa réussite ou son échec, ou abonnez-vous à son flux/eventspour la progression côté serveur. Une requête de job renvoie200même quand le job a échoué, branchez donc sur le champstatus. - Lisez le résultat : une transcription terminée porte sa langue résolue, sa durée, ses segments horodatés et, sur demande, des métadonnées comme le titre, l'auteur et la date de publication.
- Répétez sans risque : une transcription déjà extraite est servie depuis le cache au lieu de démarrer un nouveau job, la même source peut donc être redemandée.
- Inspectez d'abord :
GET /v1/transcript/inforésout une source et liste les langues qu'elle peut servir avant que vous ne vous engagiez dans une extraction.
202 avec un job id, et une ressource réellement manquante ou un repli non autorisé renvoie 404. Chaque chemin renvoie la même forme de transcription une fois le texte prêt.Extraction par lots et exports
Les charges de travail réelles s'arrêtent rarement à une seule vidéo, l'API accepte donc un lot sous forme de liste d'URL, de playlist ou de chaîne. Chaque lot suit ses propres totaux — combien d'éléments sont en attente, combien ont réussi et combien ont échoué — et renvoie les éléments page par page, pour qu'une longue chaîne n'arrive pas en une seule charge énorme.
- Trois formes de lot :
POST /v1/batchaccepte une liste d'URL, une playlist ou une chaîne, selon le corps que vous envoyez. - Statut indépendant : un lien en échec est marqué seul et ne rejette jamais le reste du lot ; les éléments en échec peuvent être relancés avec
/retry. - Éléments paginés : lisez le lot avec
GET /v1/batch/{batchId}, puis suivez le jeton de page renvoyé pour les éléments restants. - Progression en direct : chaque interrogation renvoie des compteurs actualisés, l'appelant peut donc montrer où en est une longue exécution.
- Exportez dans votre format : téléchargez un lot terminé depuis
/exportentxt,csv,json,srt,vttouzip.
srt et vtt entrent directement dans un éditeur ou un lecteur. Pour une archive, csv, json et zip gardent toute une bibliothèque d'enregistrements recherchable comme un seul corpus. Les formats s'alignent sur les réponses d'une transcription unique, donc un consommateur qui traite un résultat sait déjà lire un lot.Transcriptions enregistrées dans la bibliothèque du compte
L'extraction et le stockage sont distincts : une transcription rejoint la bibliothèque du compte une fois enregistrée, et la bibliothèque est l'endroit où vous la lisez, la recherchez, la téléchargez et la supprimez ensuite sans relancer l'extraction.
- Listez le contenu enregistré :
GET /v1/library/transcriptsparcourt page par page les transcriptions du compte, les enregistrements de lots et les lignes d'historique en échec, avec recherche, filtres de plateforme et de langue et tri. - Lisez un élément :
GET /v1/library/transcripts/{platform}/{externalId}renvoie une transcription enregistrée par plateforme et id externe, ou pour la langue que vous indiquez. - Téléchargez : la route
/downloadexporte une transcription enregistrée entxt,srt,vtt,jsonoumd. - Contenu associé : la route
/relatedliste d'autres éléments enregistrés de la même chaîne. - Supprimez :
DELETEretire un élément de la bibliothèque sans toucher à la copie de qui que ce soit d'autre. - Lectures limitées au compte : une requête vers la bibliothèque ne renvoie que ce que le compte a enregistré et ne démarre jamais une nouvelle extraction, donc revoir une transcription enregistrée est une lecture, pas un nouveau job.
Découverte YouTube au-delà des transcriptions
YouTube est la plateforme où l'API répond aussi aux questions autour d'une transcription, en reprenant les noms de ressources de l'API YouTube Data.
- Recherche :
GET /v1/youtube/searchtrouve des vidéos, des chaînes ou des playlists par requête et renvoie des résultats paginés par curseur. - Vidéos :
GET /v1/youtube/videosrenvoie les détails d'une vidéo, notamment la présence de sous-titres. - Chaînes :
GET /v1/youtube/channelsrésout une chaîne par id ou@handle. - Publications d'une chaîne :
GET /v1/youtube/channels/{channelId}/videosparcourt les publications d'une chaîne. - Éléments d'une playlist :
GET /v1/youtube/playlists/{playlistId}/itemsparcourt une playlist. - Sous-titres :
GET /v1/youtube/captionsrenvoie les métadonnées de la piste de sous-titres et le texte des sous-titres d'une vidéo. Elle ne démarre jamais un job de reconnaissance vocale : quand elle indiquerequiresAsync, appelezPOST /v1/transcriptpour lancer la transcription.
Conçue pour la production
La surface est volontairement réduite, et les parties qui comptent pour un service sont documentées plutôt que devinées.
- Une seule credential : authentifiez-vous avec une clé d'API envoyée comme jeton Bearer, ou avec
X-API-Keydepuis un script ou un serveur. - Clés à portée limitée : accordez uniquement les portées dont l'appelant a besoin, avec
transcriptsetbatchescouvrant l'extraction et le travail par lots. - Erreurs structurées : les échecs d'extraction et de validation renvoient un objet d'erreur avec un
codestable et unmessagelisible ; les réponses d'authentification (401) et de limite de débit (429) utilisent un corps d'erreur plat plus simple. - Limites exploitables : une requête limitée en débit renvoie
429avecRetry-After, et les réponses réussies portent des en-têtesX-RateLimit-*pour qu'un client puisse reculer correctement. - Un contrat publié : le document OpenAPI complet soutient l'API, vous pouvez donc générer un client, simuler un serveur ou valider de vraies réponses contre le schéma.
- Un frère pour les agents : le même compte et les mêmes outils sont accessibles depuis le serveur MCP transcript.im si votre appelant est un client IA plutôt qu'un service.
À voir aussi
Questions fréquentes sur l'API de transcription
Qu'est-ce que l'API transcript.im ?
L'API transcript.im est une surface REST qui transforme un lien public de vidéo ou d'audio en transcription horodatée, en utilisant d'abord les sous-titres existants et la transcription IA quand une vidéo n'en a aucun.
Quelles plateformes l'API transcript.im prend-elle en charge ?
Elle extrait des transcriptions de YouTube, TikTok, Instagram, LinkedIn et Twitter/X en détectant la plateforme du lien que vous envoyez. YouTube, TikTok et LinkedIn utilisent d'abord les sous-titres avec la reconnaissance vocale comme solution de repli ; Instagram et X n'ont pas de piste de sous-titres et passent directement à la reconnaissance vocale.
Que se passe-t-il quand une vidéo n'a pas de sous-titres ?
Quand une vidéo n'a aucune piste de sous-titres, l'API démarre un job ASR et renvoie un job id ; vous interrogez ce job jusqu'à ce que la transcription soit prête, la requête ne bloque donc jamais sur la reconnaissance vocale.
Puis-je transcrire un fichier audio ou vidéo local ?
Oui. POST /v1/transcript accepte un corps multipart/form-data avec une partie file au lieu d'une URL. Un fichier envoyé passe directement par la reconnaissance vocale, il renvoie donc un job 202 — ou un résultat 200 s'il se termine dans le budget d'attente.
L'API transcript.im peut-elle renvoyer des horodatages avec le texte ?
Oui. Les réponses JSON portent des segments horodatés et les réponses texte peuvent conserver un préfixe d'horodatage par ligne, vous pouvez donc revenir au moment où une phrase a été dite.
Comment demander une transcription dans une langue précise ?
Envoyez une liste de priorité de langues séparée par des virgules, incluant des entrées asr et asr-<code>. Une correspondance de sous-titres est renvoyée directement ; quand des sous-titres existent mais qu'aucun ne correspond à la liste, la requête continue vers la transcription IA et renvoie un job 202, et un 404 avec les langues disponibles n'est renvoyé que lorsque la reconnaissance vocale n'est pas autorisée.
Comment savoir quand une transcription asynchrone est prête ?
Interrogez GET /v1/transcript/job/{id} avec la même credential jusqu'à ce qu'il indique une réussite ou un échec, ou abonnez-vous à GET /v1/transcript/job/{id}/events pour des mises à jour côté serveur. Une requête de job renvoie 200 même quand le job a échoué, lisez donc les champs status et error plutôt que le code HTTP.
L'API transcript.im prend-elle en charge l'extraction par lots ?
Oui. Un lot accepte une liste d'URL, une playlist ou une chaîne, suit le statut de chaque élément et renvoie les éléments page par page.
Quels formats d'export puis-je télécharger ?
Un lot terminé s'exporte en txt, csv, json, srt, vtt ou zip ; une seule transcription enregistrée se télécharge en txt, srt, vtt, json ou md.
Où vivent les transcriptions enregistrées ?
La bibliothèque du compte est l'endroit où vivent les transcriptions enregistrées et les enregistrements de lots, sous /v1/library. Elle expose des routes de liste, de lecture, de téléchargement, d'associés et de suppression, et ses lectures sont limitées au compte et ne démarrent jamais une nouvelle extraction.
Que renvoie l'endpoint de sous-titres YouTube ?
GET /v1/youtube/captions renvoie les métadonnées de la piste de sous-titres d'une vidéo ainsi que le texte des sous-titres. Elle ne démarre jamais un job de reconnaissance vocale ; quand elle indique requiresAsync, appelez POST /v1/transcript pour lancer la transcription.
Comment l'API transcript.im signale-t-elle les erreurs et les limites de débit ?
Les erreurs d'extraction et de validation utilisent un objet avec code et message ; l'authentification renvoie un 401 plat, et la limite de débit renvoie un 429 plat avec Retry-After plus des en-têtes X-RateLimit-* pour qu'un client puisse reculer correctement.
Ajoutez des transcriptions à votre produit
Créez une clé d'API, envoyez un lien de vidéo ou un fichier local, et lisez la transcription en JSON ou en texte brut.