
REST API
वीडियो और ऑडियो के लिए ट्रांसक्रिप्ट API
transcript.im वही एक्सट्रैक्शन पाइपलाइन एक वर्जन वाले ट्रांसक्रिप्ट API के रूप में देता है जो प्रोडक्ट को चलाती है। एक वीडियो या ऑडियो URL भेजें और टाइमस्टैम्प वाला टेक्स्ट वापस पाएं, JSON या सादे टेक्स्ट में, और प्लेटफ़ॉर्म अपने आप पहचान लिया जाएगा। पहले मौजूदा कैप्शन इस्तेमाल होते हैं; जब किसी वीडियो में कैप्शन न हों, तो AI ऑडियो को ट्रांसक्राइब करता है और नतीजा एसिंक्रोनस तरीके से मिलता है।
- एक
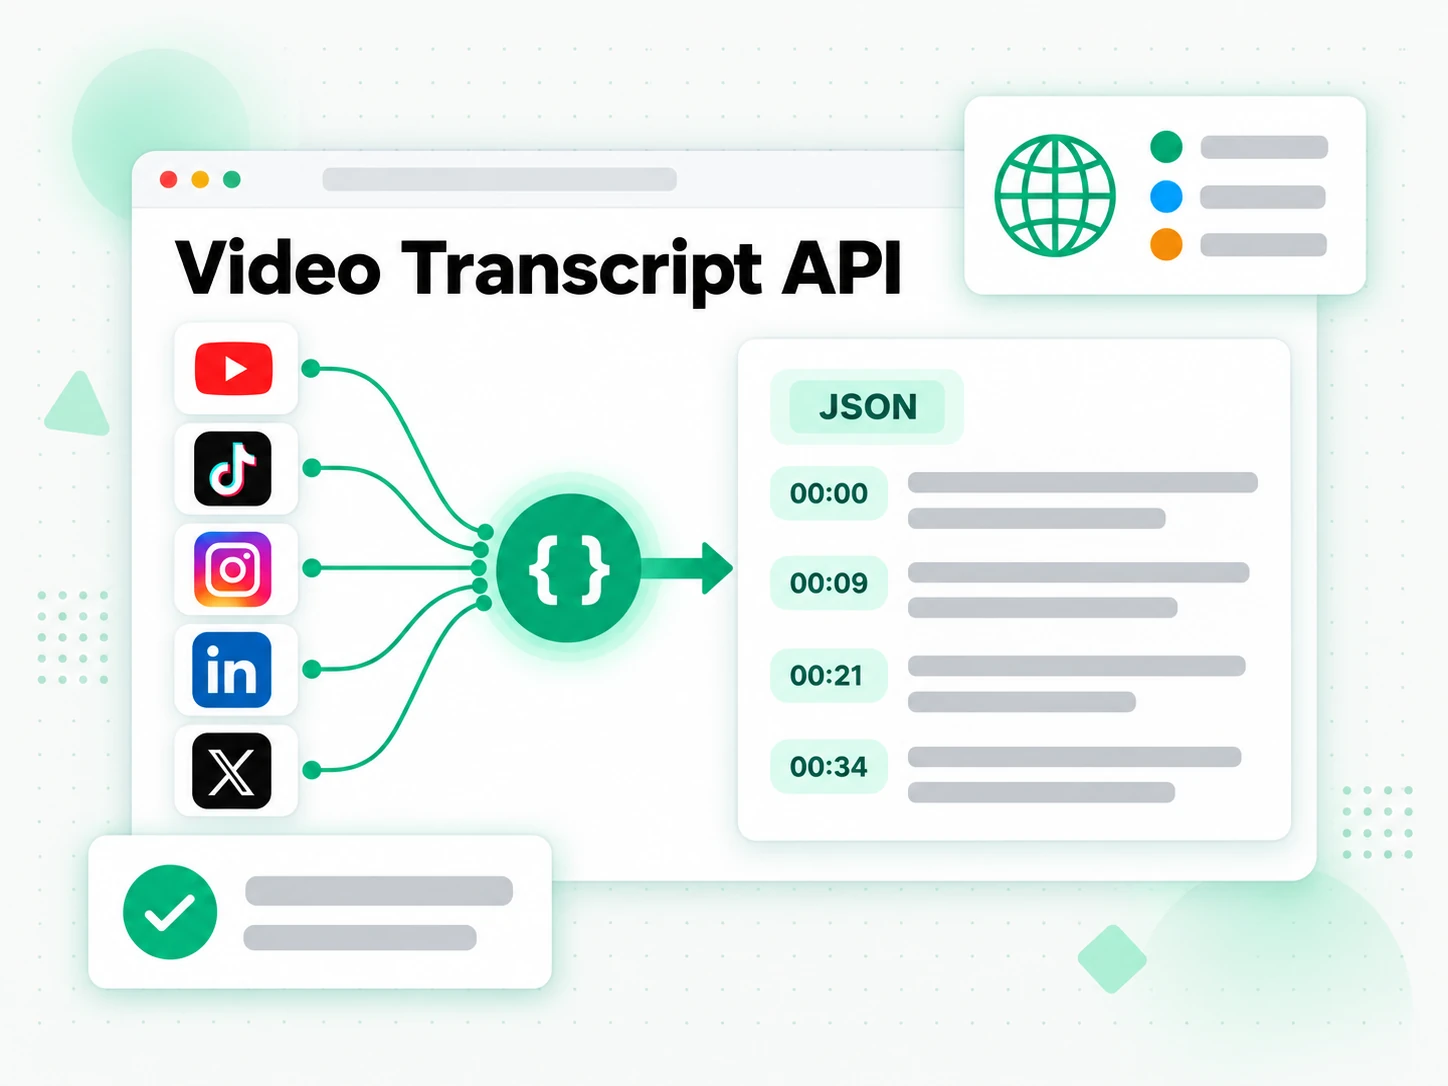
urlपूरा या छोटा लिंक स्वीकार करता है और YouTube, TikTok, Instagram, LinkedIn और Twitter/X को पहचान लेता है; YouTube के लिए सिर्फ़ वीडियो id भी पहचाना जाता है, औरplatformके साथexternalIdउस सोर्स को कवर करते हैं जिसे आप पहले से जानते हैं। - पहले कैप्शन इस्तेमाल होते हैं; जब किसी वीडियो में कैप्शन न हों तो AI बोले गए ऑडियो को ट्रांसक्राइब करता है, और लोकल फ़ाइल अपलोड हमेशा स्पीच रिकग्निशन पर जाता है।
format=jsonटाइमस्टैम्प वाले सेगमेंट लौटाता है, जबकिformat=textपेस्ट करने के लिए तैयार सादा टेक्स्ट लौटाता है।- बैच एक्सट्रैक्शन URL लिस्ट, प्लेलिस्ट और चैनल को कवर करता है।
- बैच एक्सपोर्ट txt, csv, json, srt, vtt और zip को कवर करते हैं; सेव किया गया ट्रांसक्रिप्ट txt, srt, vtt, json या md के रूप में डाउनलोड होता है।
- सेव किए गए ट्रांसक्रिप्ट अकाउंट की Library में रहते हैं, और YouTube डिस्कवरी सर्च, वीडियो, चैनल, अपलोड, प्लेलिस्ट और कैप्शन को कवर करती है।
- पूरा कॉन्ट्रैक्ट एक OpenAPI डॉक्युमेंट के रूप में पब्लिश किया गया है।
transcript.im API क्या करता है
transcript.im API किसी भी सार्वजनिक वीडियो या ऑडियो लिंक को टाइमस्टैम्प वाले ट्रांसक्रिप्ट में बदल देता है, जिसे आपका प्रोडक्ट पढ़ सकता है, सेव कर सकता है, सर्च कर सकता है या किसी मॉडल को दे सकता है। आप एक URL भेजते हैं; API प्लेटफ़ॉर्म पहचानता है, क्रिएटर की मौजूदा कैप्शन ट्रैक देखता है, और हर लाइन के साथ टाइमस्टैम्प सहित लिखा हुआ टेक्स्ट लौटाता है। जब किसी वीडियो में कैप्शन बिल्कुल न हों, तो API सिर्फ़ एरर देकर रुकता नहीं — वह बोले गए ऑडियो की AI ट्रांसक्रिप्शन पर चला जाता है, ताकि वही रिक्वेस्ट फिर भी टेक्स्ट दे।
- एक रिक्वेस्ट, असली टेक्स्ट — लिंक रिज़ॉल्व करें और टाइमस्टैम्प वाले ट्रांसक्रिप्ट सेगमेंट या सादा टेक्स्ट पाएं।
- पहले कैप्शन, फिर AI — जब क्रिएटर की ट्रैक मौजूद हो तो उसका इस्तेमाल करें, न हो तो ऑडियो ट्रांसक्राइब करें।
- ASR के लिए डिफ़ॉल्ट रूप से async — जॉब id से आप लंबी ट्रांसक्रिप्शन को बिना रुके पोल कर सकते हैं।
- भाषा के प्रति सजग — भाषा प्राथमिकता मांगें और वह भाषा वापस पढ़ें जो API ने तय की।
- प्लेटफ़ॉर्म से आज़ाद — कॉलर को यह जानने की ज़रूरत नहीं कि वीडियो कहां होस्ट है।
पांच प्लेटफ़ॉर्म के लिए एक ट्रांसक्रिप्ट API
YouTube
किसी भी सार्वजनिक YouTube वीडियो, Short या लाइव रिकॉर्डिंग के लिए ट्रांसक्रिप्ट, पहले क्रिएटर के कैप्शन और कैप्शन न होने पर AI ट्रांसक्रिप्शन के साथ। YouTube वह प्लेटफ़ॉर्म भी है जहां ट्रांसक्रिप्ट के साथ-साथ पूरी discovery सतह — सर्च, वीडियो, चैनल, अपलोड, प्लेलिस्ट और कैप्शन — उपलब्ध है। किसी चैनल का पुराना सारा कंटेंट या एक प्लेलिस्ट टाइमस्टैम्प वाले ट्रांसक्रिप्ट का बैच बन जाता है, जबकि एक अकेला लिंक पढ़ने लायक टेक्स्ट बनकर आता है जिसे आप सर्च कर सकते हैं।
TikTok
सार्वजनिक TikTok वीडियो के लिए ट्रांसक्रिप्ट, पहले कैप्शन और फ़ॉलबैक के रूप में speech recognition। वीडियो लिंक पेस्ट करें और बोले गए कंटेंट को साफ़, टाइमस्टैम्प वाले टेक्स्ट के रूप में पढ़ें, जिसे आप दोबारा इस्तेमाल कर सकते हैं, ट्रांसलेट कर सकते हैं या कोट कर सकते हैं। वही कॉल एक छोटे क्लिप और एक लंबे अपलोड दोनों को कवर करती है, इसलिए एक ट्रेंड, एक ट्यूटोरियल और एक talking-head पोस्ट — सब टेक्स्ट के रूप में आ जाते हैं।
सार्वजनिक Instagram Reels और वीडियो पोस्ट के लिए ट्रांसक्रिप्ट। Instagram में पढ़ने के लिए कोई कैप्शन ट्रैक नहीं होता, इसलिए एक्सट्रैक्शन async speech recognition से होता है: लिंक सबमिट करें, जॉब पोल करें, और टेक्स्ट तैयार होने पर उसे ले लें। इससे एक Reel कोट करने और सर्च करने लायक बन जाता है, भले ही प्लेटफ़ॉर्म ने उसके शब्द कभी टेक्स्ट के रूप में न छापे हों।
सार्वजनिक LinkedIn वीडियो पोस्ट के लिए ट्रांसक्रिप्ट, पहले कैप्शन और फ़ॉलबैक के रूप में speech recognition। नतीजा टाइमस्टैम्प के साथ आता है, इसलिए एक टॉक, एक प्रोडक्ट क्लिप या एक रिकॉर्ड की गई मीटिंग सर्च करने लायक टेक्स्ट बन जाती है जिसे आप साइट कर सकते हैं और दोबारा इस्तेमाल कर सकते हैं। किसी वेबिनार रिकॉर्डिंग से दलील निकालें, या किसी फ़ाउंडर के अपडेट को ऐसे ड्राफ़्ट में बदलें जिसे आप एडिट कर सकें।
Twitter/X
सार्वजनिक X वीडियो पोस्ट के लिए ट्रांसक्रिप्ट। X में पढ़ने के लिए कोई कैप्शन ट्रैक नहीं होता, इसलिए एक्सट्रैक्शन async speech recognition से चलता है: लिंक सबमिट करें, जॉब पोल करें, और टाइमस्टैम्प वाला टेक्स्ट ले लें जिसे आप सर्च कर सकते हैं। किसी वीडियो को सही-सही कोट करें, या पोस्ट के एडिट या हटाए जाने से पहले उसके बोले गए कंटेंट को आर्काइव कर लें।
ट्रांसक्रिप्ट रिक्वेस्ट कैसे आगे बढ़ती है
एक ही कॉल लिंक या अपलोड की गई फ़ाइल को इनपुट से ट्रांसक्रिप्ट तक ले जाती है, और API बताता है कि उसने कौन-सा रास्ता लिया।
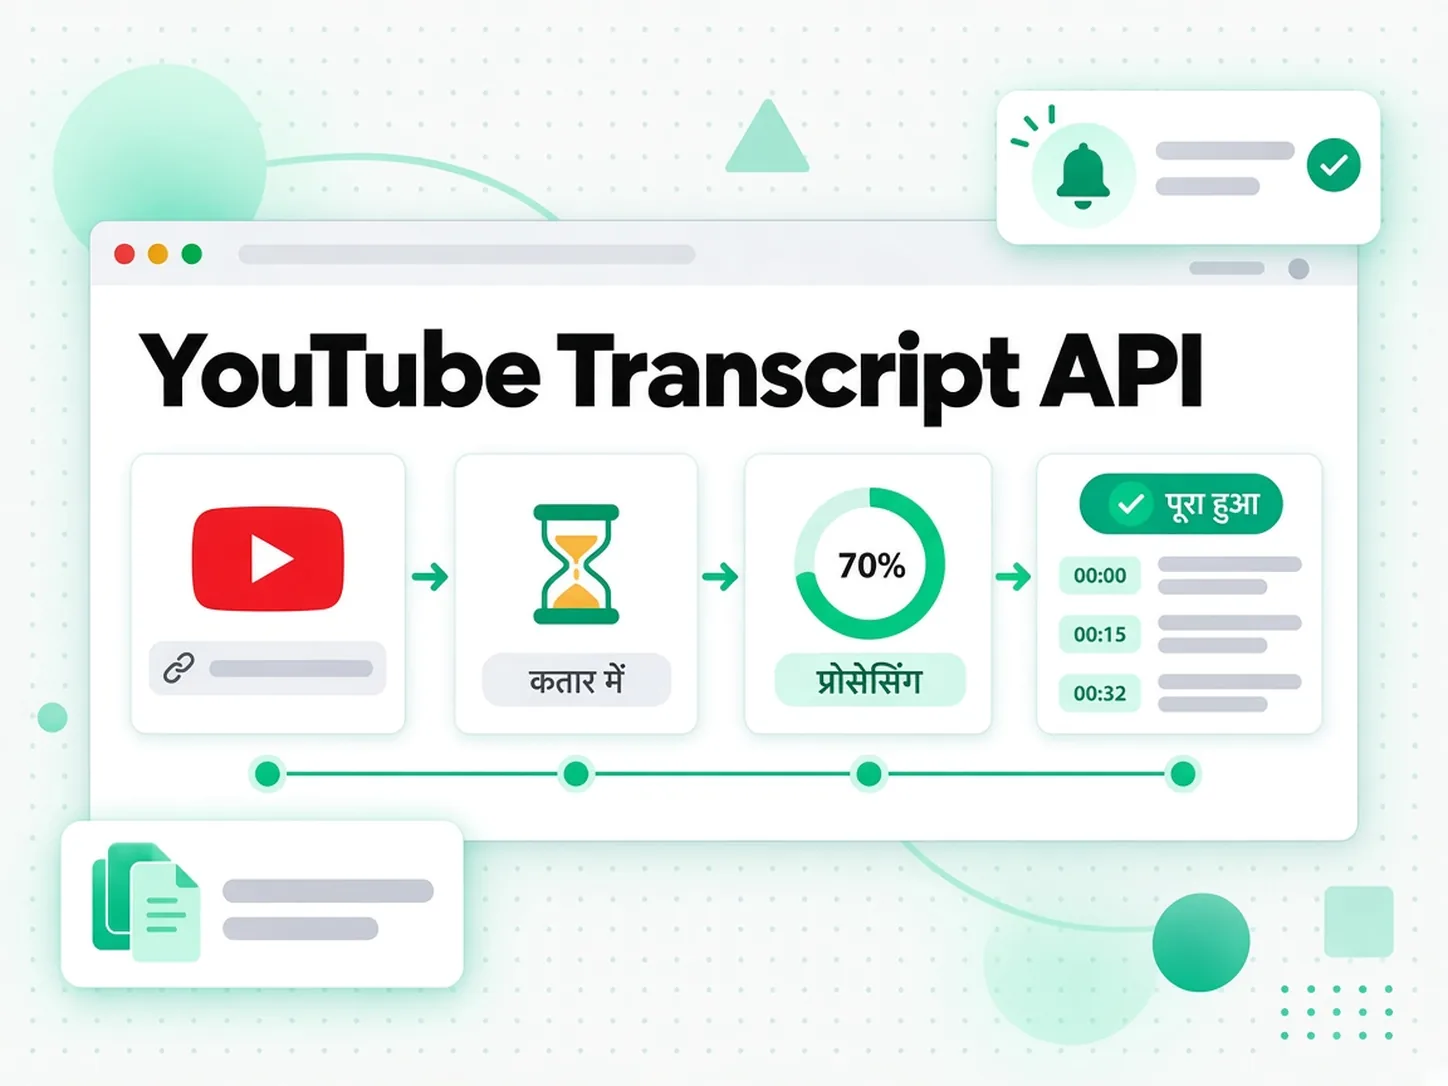
- स्रोत भेजें — एक
urlपोस्ट करें, जब उन्हें पहले से जानते हों तोplatformऔरexternalIdपास करें, या उसी एंडपॉइंट परmultipart/form-dataके रूप में फ़ाइल अपलोड करें। - कैप्शन मैच पाएं — जब वीडियो में आपकी लिस्ट की किसी भाषा के कैप्शन हों, तो ट्रांसक्रिप्ट उसी रिस्पॉन्स में आ जाता है।
- भाषा न मिलने पर संभालें — जब कैप्शन मौजूद हों पर आपकी लिस्ट से कोई न मिले, तो रिक्वेस्ट AI ट्रांसक्रिप्शन की ओर बढ़ती है और जॉब id के साथ
202लौटाती है;availableLanguagesवाला404सिर्फ़ तब लौटता है जब कॉलर के लिए speech recognition की इजाज़त न हो। - ASR पर मजबूर करें या उस पर लौटें — कोई साफ़
asrएंट्री, बिना किसी कैप्शन ट्रैक वाला वीडियो, या अपलोड की गई फ़ाइल ASR जॉब शुरू करती है और जॉब id लौटाती है। - पोल करें या स्ट्रीम करें — जॉब को
GET /v1/transcript/job/{id}से तब तक पढ़ें जब तक वह सफल या फेल न हो जाए, या server-sent प्रगति के लिए उसकी/eventsस्ट्रीम को सब्सक्राइब करें। जॉब क्वेरी फेल जॉब के लिए भी200लौटाती है, इसलिएstatusफ़ील्ड पर ब्रांच करें। - नतीजा पढ़ें — तैयार ट्रांसक्रिप्ट के साथ उसकी तय की गई भाषा, लंबाई, टाइमस्टैम्प वाले सेगमेंट और, मांगे जाने पर, title, author और publish date जैसी मेटाडेटा आती है।
- सुरक्षित तरीके से दोहराएं — जो ट्रांसक्रिप्ट पहले ही निकाला जा चुका है वह नई जॉब शुरू करने के बजाय कैश से सर्व होता है, इसलिए वही स्रोत दोबारा मांगा जा सकता है।
- पहले जांचें —
GET /v1/transcript/infoकिसी स्रोत को रिज़ॉल्व करता है और एक्सट्रैक्शन पर जाने से पहले उन भाषाओं की लिस्ट दिखाता है जिन्हें वह सर्व कर सकता है।
202 लौटाता है, और सच में गायब एसेट या मना किया गया फ़ॉलबैक 404 लौटाता है। टेक्स्ट तैयार होने पर हर रास्ता वही ट्रांसक्रिप्ट शेप लौटाता है।बैच एक्सट्रैक्शन और एक्सपोर्ट
असली काम शायद ही एक वीडियो पर रुकते हैं, इसलिए API बैच को URL लिस्ट, प्लेलिस्ट या चैनल के रूप में स्वीकार करता है। हर बैच अपने टोटल खुद ट्रैक करता है — कितने आइटम पेंडिंग हैं, कितने सफल हुए और कितने फेल — और आइटम एक बार में एक पेज लौटाता है, ताकि लंबा चैनल एक बड़े पेलोड के रूप में न आए।
- बैच के तीन रूप —
POST /v1/batchURLs की लिस्ट, एक प्लेलिस्ट या एक चैनल लेता है, जो आपके भेजे गए body से तय होता है। - स्वतंत्र स्टेटस — एक फेल लिंक अपने आप मार्क होता है और बाकी बैच को कभी नहीं गिराता; फेल आइटम
/retryसे दोबारा ट्राई किए जा सकते हैं। - पेज किए गए आइटम — बैच को
GET /v1/batch/{batchId}से पढ़ें, फिर बाकी आइटम के लिए लौटाए गए page token का पीछा करें। - लाइव प्रगति — हर पोल अपडेटेड काउंट लौटाता है, ताकि कॉलर दिखा सके कि लंबे रन का कितना हिस्सा पूरा हुआ।
- अपने फ़ॉर्मेट में एक्सपोर्ट करें — तैयार बैच को
/exportसेtxt,csv,json,srt,vttयाzipके रूप में डाउनलोड करें।
srt और vtt एक्सपोर्ट सीधे किसी एडिटर या प्लेयर में चले जाते हैं। आर्काइव के लिए, csv, json और zip रिकॉर्डिंग की पूरी लाइब्रेरी को एक कोरपस के रूप में सर्च करने लायक रखते हैं। ये फ़ॉर्मेट single-transcript रिस्पॉन्स से मेल खाते हैं, इसलिए जो कंज़्यूमर एक नतीजा संभाल लेता है वह बैच पढ़ना भी जानता है।अकाउंट लाइब्रेरी में सेव किए गए ट्रांसक्रिप्ट
एक्सट्रैक्शन और स्टोरेज अलग हैं: ट्रांसक्रिप्ट सेव होते ही अकाउंट लाइब्रेरी का हिस्सा बन जाता है, और लाइब्रेरी वह जगह है जहां आप बाद में बिना एक्सट्रैक्शन दोबारा चलाए उसे पढ़, सर्च, डाउनलोड और हटा सकते हैं।
- सेव किया गया कंटेंट लिस्ट करें —
GET /v1/library/transcriptsअकाउंट के ट्रांसक्रिप्ट, बैच रिकॉर्ड और failed-history पंक्तियों को सर्च, प्लेटफ़ॉर्म और भाषा फ़िल्टर तथा सॉर्टिंग के साथ पेज करता है। - एक आइटम पढ़ें —
GET /v1/library/transcripts/{platform}/{externalId}प्लेटफ़ॉर्म और external id से, या आपकी बताई भाषा के लिए, सेव किया गया ट्रांसक्रिप्ट लौटाता है। - डाउनलोड —
/downloadरूट सेव किए गए ट्रांसक्रिप्ट कोtxt,srt,vtt,jsonयाmdके रूप में एक्सपोर्ट करता है। - संबंधित कंटेंट —
/relatedरूट उसी चैनल के दूसरे सेव किए गए आइटम लिस्ट करता है। - हटाएं —
DELETEकिसी और की कॉपी को छुए बिना आइटम को लाइब्रेरी से हटा देता है। - अकाउंट तक सीमित रीड — लाइब्रेरी रिक्वेस्ट सिर्फ़ वही लौटाती है जो अकाउंट ने सेव किया और कभी नया एक्सट्रैक्शन शुरू नहीं करती, इसलिए सेव किए गए ट्रांसक्रिप्ट पर दोबारा जाना एक रीड है, कोई नई जॉब नहीं।
ट्रांसक्रिप्ट से आगे YouTube discovery
YouTube वह प्लेटफ़ॉर्म है जहां API ट्रांसक्रिप्ट के आसपास के सवालों का जवाब भी देता है, YouTube Data API के वही रिसोर्स नाम इस्तेमाल करते हुए।
- सर्च —
GET /v1/youtube/searchक्वेरी से वीडियो, चैनल या प्लेलिस्ट ढूंढता है और cursor-paged नतीजे लौटाता है। - वीडियो —
GET /v1/youtube/videosकिसी वीडियो की जानकारी लौटाता है, जिसमें यह भी शामिल है कि कैप्शन उपलब्ध हैं या नहीं। - चैनल —
GET /v1/youtube/channelsकिसी चैनल को id या@handleसे रिज़ॉल्व करता है। - चैनल अपलोड —
GET /v1/youtube/channels/{channelId}/videosकिसी चैनल के अपलोड पर चलता है। - प्लेलिस्ट आइटम —
GET /v1/youtube/playlists/{playlistId}/itemsकिसी प्लेलिस्ट पर चलता है। - कैप्शन —
GET /v1/youtube/captionsकिसी वीडियो की caption-track मेटाडेटा और कैप्शन टेक्स्ट लौटाता है। यह कभी speech-recognition जॉब शुरू नहीं करता: जब यहrequiresAsyncबताए, तो ट्रांसक्रिप्शन चलाने के लिएPOST /v1/transcriptकॉल करें।
प्रोडक्शन इस्तेमाल के लिए बनाया गया
सतह जानबूझकर छोटी रखी गई है, और किसी सर्विस के लिए जो हिस्से मायने रखते हैं वे अंदाज़े के बजाय डॉक्युमेंट किए गए हैं।
- एक ही क्रेडेंशियल — Bearer token के रूप में भेजी गई API key से authenticate करें, या स्क्रिप्ट/सर्वर से
X-API-Keyके ज़रिए। - स्कोप्ड keys — कॉलर को सिर्फ़ ज़रूरी scopes दें, जिनमें
transcriptsऔरbatchesextraction और batch काम को कवर करते हैं। - स्ट्रक्चर्ड errors — extraction और validation की गड़बड़ियाँ एक error object लौटाती हैं जिसमें stable
codeऔर पढ़ने लायकmessageहोता है; authentication (401) और rate-limit (429) रिस्पॉन्स में सादा flat error body आता है। - काम की limits — rate-limited request
429के साथRetry-Afterलौटाती है, और सफल रिस्पॉन्स मेंX-RateLimit-*headers होते हैं ताकि client सही तरीके से back off कर सके। - प्रकाशित contract — पूरा OpenAPI document API के पीछे है, जिससे आप client generate कर सकते हैं, server mock कर सकते हैं, या schema के मुताबिक असली responses validate कर सकते हैं।
- agents के लिए साथी — वही account और tools transcript.im MCP server से पहुँच सकते हैं, अगर आपका caller किसी service की बजाय AI client हो।
संबंधित
ट्रांसक्रिप्ट API FAQs
transcript.im API क्या है?
transcript.im API एक REST surface है जो किसी public वीडियो या ऑडियो लिंक को timestamp वाले ट्रांसक्रिप्ट में बदल देता है — पहले मौजूदा कैप्शन इस्तेमाल करता है और वीडियो में कैप्शन न होने पर AI transcription।
transcript.im API किन platforms को support करता है?
यह आपके भेजे गए लिंक से platform पहचानकर YouTube, TikTok, Instagram, LinkedIn और Twitter/X से ट्रांसक्रिप्ट निकालता है। YouTube, TikTok और LinkedIn पहले कैप्शन इस्तेमाल करते हैं और ज़रूरत पड़ने पर speech recognition; Instagram और X में कोई caption track नहीं होता, इसलिए सीधे speech recognition चलता है।
जब किसी वीडियो में कैप्शन न हों तो क्या होता है?
जब वीडियो में कोई कैप्शन ट्रैक ही न हो, तो API एक ASR job शुरू करता है और job id लौटाता है; आप उस job को तब तक poll करते हैं जब तक ट्रांसक्रिप्ट तैयार न हो जाए, इसलिए request कभी speech recognition पर block नहीं होती।
क्या मैं local ऑडियो या वीडियो file transcribe कर सकता हूँ?
हाँ। POST /v1/transcript URL की जगह file part के साथ multipart/form-data body भी लेता है। Upload की गई file सीधे speech recognition पर जाती है, इसलिए यह 202 job लौटाती है — या 200 result अगर काम wait budget के अंदर पूरा हो जाए।
क्या transcript.im API टेक्स्ट के साथ timestamps लौटा सकता है?
हाँ। JSON responses में timestamp वाले segments होते हैं और text responses हर line पर timestamp prefix रख सकते हैं, ताकि आप उस पल पर लौट सकें जब कोई line बोली गई थी।
किसी खास भाषा में ट्रांसक्रिप्ट कैसे request करें?
comma से अलग की गई language priority list भेजें, जिसमें asr और asr-<code> entries हों। caption match सीधे लौटता है; जब कैप्शन हों पर list से कोई match न करे, तो request AI transcription पर चलती रहती है और 202 job लौटाती है, और 404 उपलब्ध भाषाओं के साथ सिर्फ तब लौटता है जब speech recognition की इजाज़त न हो।
कैसे पता चले कि asynchronous ट्रांसक्रिप्ट तैयार है?
उसी credential के साथ GET /v1/transcript/job/{id} को तब तक poll करें जब तक वह success या failed न बता दे, या server-sent updates के लिए GET /v1/transcript/job/{id}/events subscribe करें। job query job fail होने पर भी 200 लौटाती है, इसलिए HTTP code की बजाय status और error fields पढ़ें।
क्या transcript.im API batch extraction support करता है?
हाँ। एक batch URLs की list, कोई playlist या channel लेता है, हर item की status track करता है, और items को एक-एक page में लौटाता है।
कौन-कौन से export formats डाउनलोड कर सकता हूँ?
पूरा हुआ batch txt, csv, json, srt, vtt या zip के रूप में export होता है; एक saved ट्रांसक्रिप्ट txt, srt, vtt, json या md के रूप में डाउनलोड होता है।
saved ट्रांसक्रिप्ट कहाँ रहते हैं?
account की Library में saved ट्रांसक्रिप्ट और batch records /v1/library के तहत रहते हैं। इसमें list, read, download, related और delete routes होते हैं, और इसकी reads सिर्फ account तक सीमित रहती हैं और कभी नई extraction शुरू नहीं करतीं।
YouTube captions endpoint क्या लौटाता है?
GET /v1/youtube/captions किसी वीडियो के caption-track metadata के साथ caption text लौटाता है। यह कभी speech-recognition job शुरू नहीं करता; जब यह requiresAsync बताए, तो transcription चलाने के लिए POST /v1/transcript call करें।
transcript.im API errors और rate limits कैसे बताता है?
Extraction और validation errors में code और message वाला object होता है; authentication flat 401 लौटाता है, और rate limiting flat 429 के साथ Retry-After और X-RateLimit-* headers लौटाता है ताकि client सही तरीके से back off कर सके।
अपने product में ट्रांसक्रिप्ट जोड़ें
एक API key बनाएँ, कोई वीडियो लिंक या local file भेजें, और ट्रांसक्रिप्ट को JSON या plain text में पढ़ें।