
REST API
面向视频和音频的转录 API
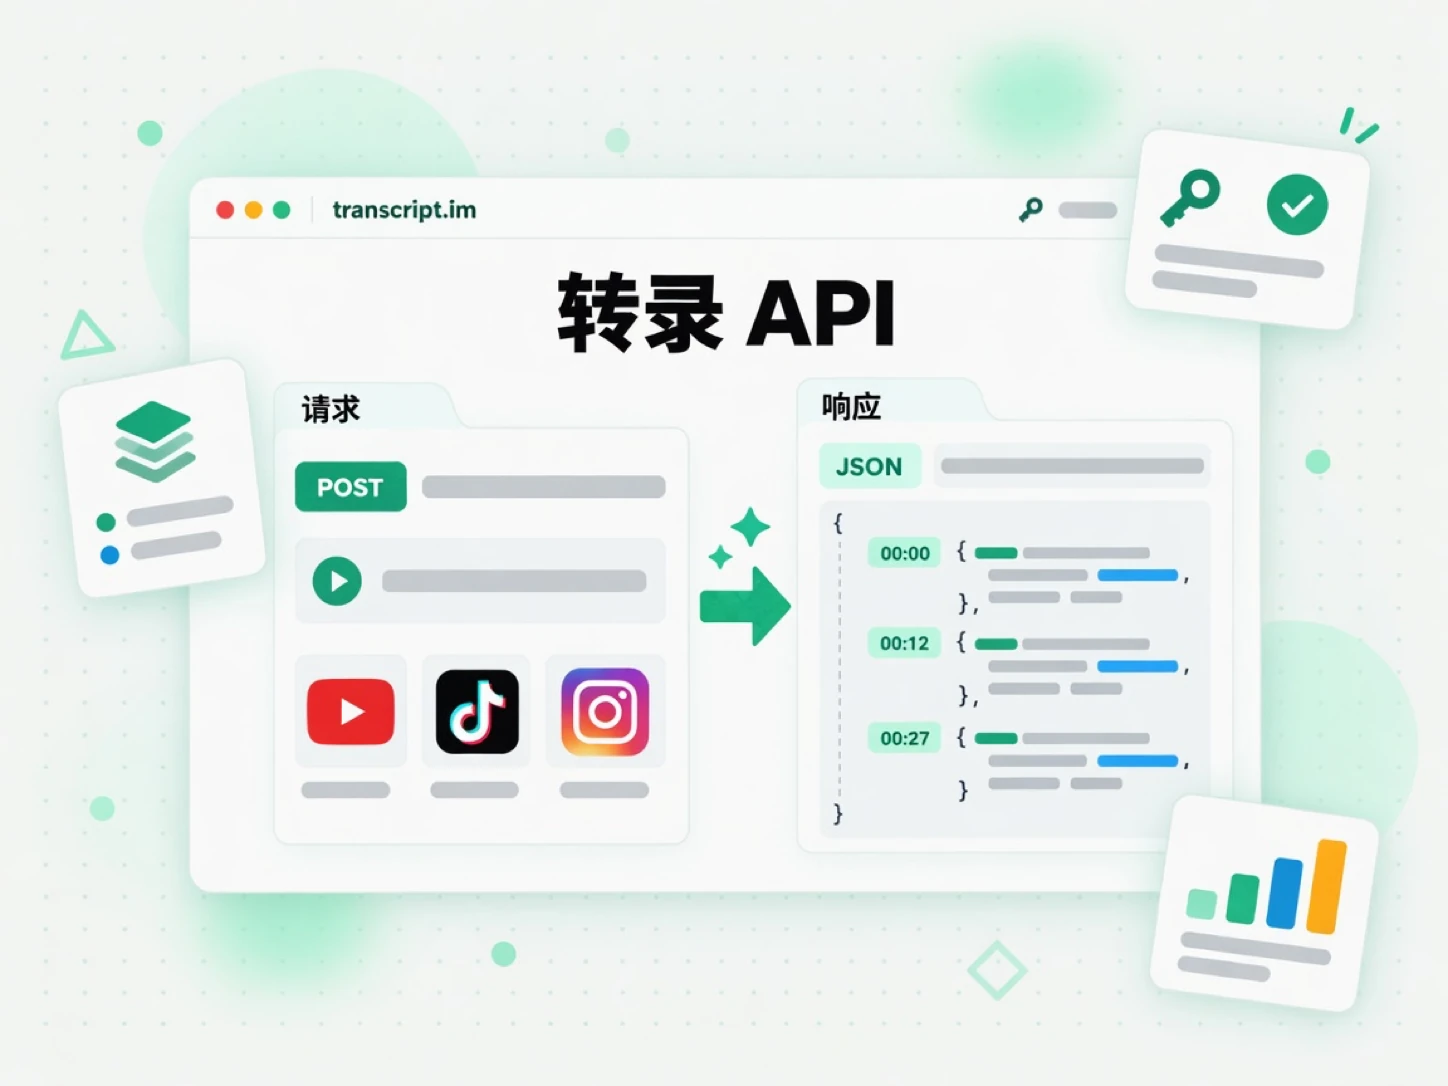
transcript.im 把驱动产品的那条提取流水线以带版本的转录 API 开放出来。发送一个视频或音频 URL,就能拿回带时间戳的文本,格式为 JSON 或纯文本,平台由系统自动识别。已有字幕优先使用;视频没有字幕时,由 AI 转写音频,结果以异步方式返回。
- 一个
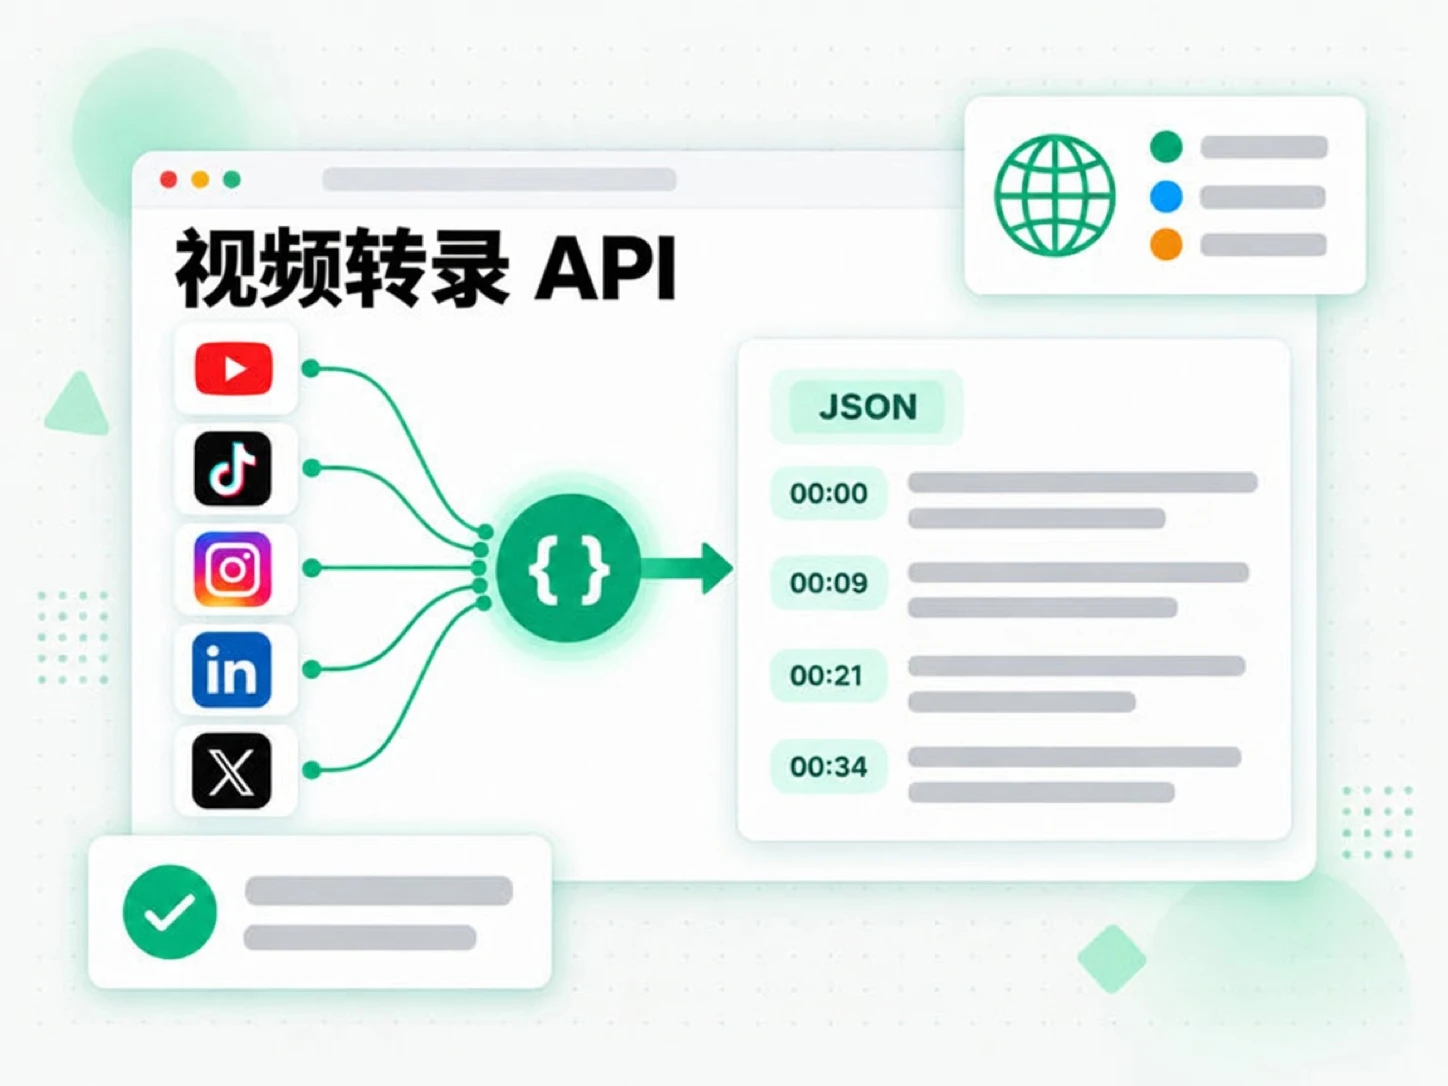
url既接受完整链接也接受短链接,并自动识别 YouTube、TikTok、Instagram、LinkedIn 和 Twitter/X;YouTube 还支持直接传视频 id,已知来源时也可以用platform加externalId指定。 - 优先使用字幕;视频没有字幕时由 AI 转写人声,本地文件上传则一律走语音识别。
format=json返回带时间戳的分段,format=text返回可直接粘贴的纯文本。- 批量提取支持 URL 列表、播放列表和频道。
- 批量导出支持 txt、csv、json、srt、vtt、zip;已保存的转录可下载为 txt、srt、vtt、json 或 md。
- 已保存的转录存放在账户资料库中,YouTube 发现能力覆盖搜索、视频、频道、上传、播放列表和字幕。
- 完整契约以 OpenAPI 文档形式公开。
transcript.im API 能做什么
transcript.im API 把公开的视频或音频链接转化成带时间戳的转录文本,你的产品可以读取、存储、搜索,或送入模型。你发送一个 URL;API 解析平台,查找创作者已有的字幕轨,返回每一行都带时间戳的文字。当视频完全没有字幕时,API 不会停在错误上——它会改用 AI 转写人声,让同一个请求照样产出文本。
- 一次请求,真实文本——解析一个链接,返回带时间戳的转录分段或纯文本。
- 字幕优先,AI 其次——有创作者字幕就用,没有就转写音频。
- ASR 默认异步——拿到 job id 后可以轮询长时间转写而不会阻塞。
- 感知语言——请求语言优先级,并读回 API 实际解析出的语言。
- 平台无关——调用方不需要知道视频托管在哪里。
一个转录 API,覆盖五大平台
YouTube
任何公开的 YouTube 视频、Shorts 或直播录像都能转录,优先使用创作者字幕,字幕缺失时用 AI 转写。YouTube 也是拥有完整发现能力的平台——搜索、视频、频道、上传、播放列表和字幕——可与转录本身一起使用。一个频道的积压内容或一个播放列表会变成一批带时间戳的转录,而单个链接则返回可搜索的易读文本。
TikTok
公开 TikTok 视频的转录,优先使用字幕,语音识别作为兜底。粘贴视频链接,即可把口播内容读成干净、带时间戳的文本,方便二次利用、翻译或引用。同一次调用既能处理短视频也能处理较长的上传,所以趋势、教程和出镜口播都会以文本形式返回。
公开 Instagram Reels 和视频帖子的转录。Instagram 没有可读取的字幕轨,因此提取走异步语音识别:提交链接、轮询任务,准备好后取回文本。这样即使平台从未把讲话发布成文字,一个 Reel 也能被引用和搜索。
公开 LinkedIn 视频帖子的转录,优先使用字幕,语音识别作为兜底。结果带时间戳返回,因此一场演讲、一段产品短片或一次会议录像都会变成可搜索、可引用、可复用的文本。你可以从网络研讨会录像里提取论点,或把创始人的动态变成一份可编辑的草稿。
Twitter/X
公开 X 视频帖子的转录。X 没有可读取的字幕轨,因此提取走异步语音识别:提交链接、轮询任务,取回可搜索的带时间戳文本。你可以准确引用一段视频,或在帖子被编辑或删除前存档其口播内容。
一次转录请求如何流转
一次调用就把链接或上传的文件从输入带到转录,API 会告诉你它走了哪条路径。
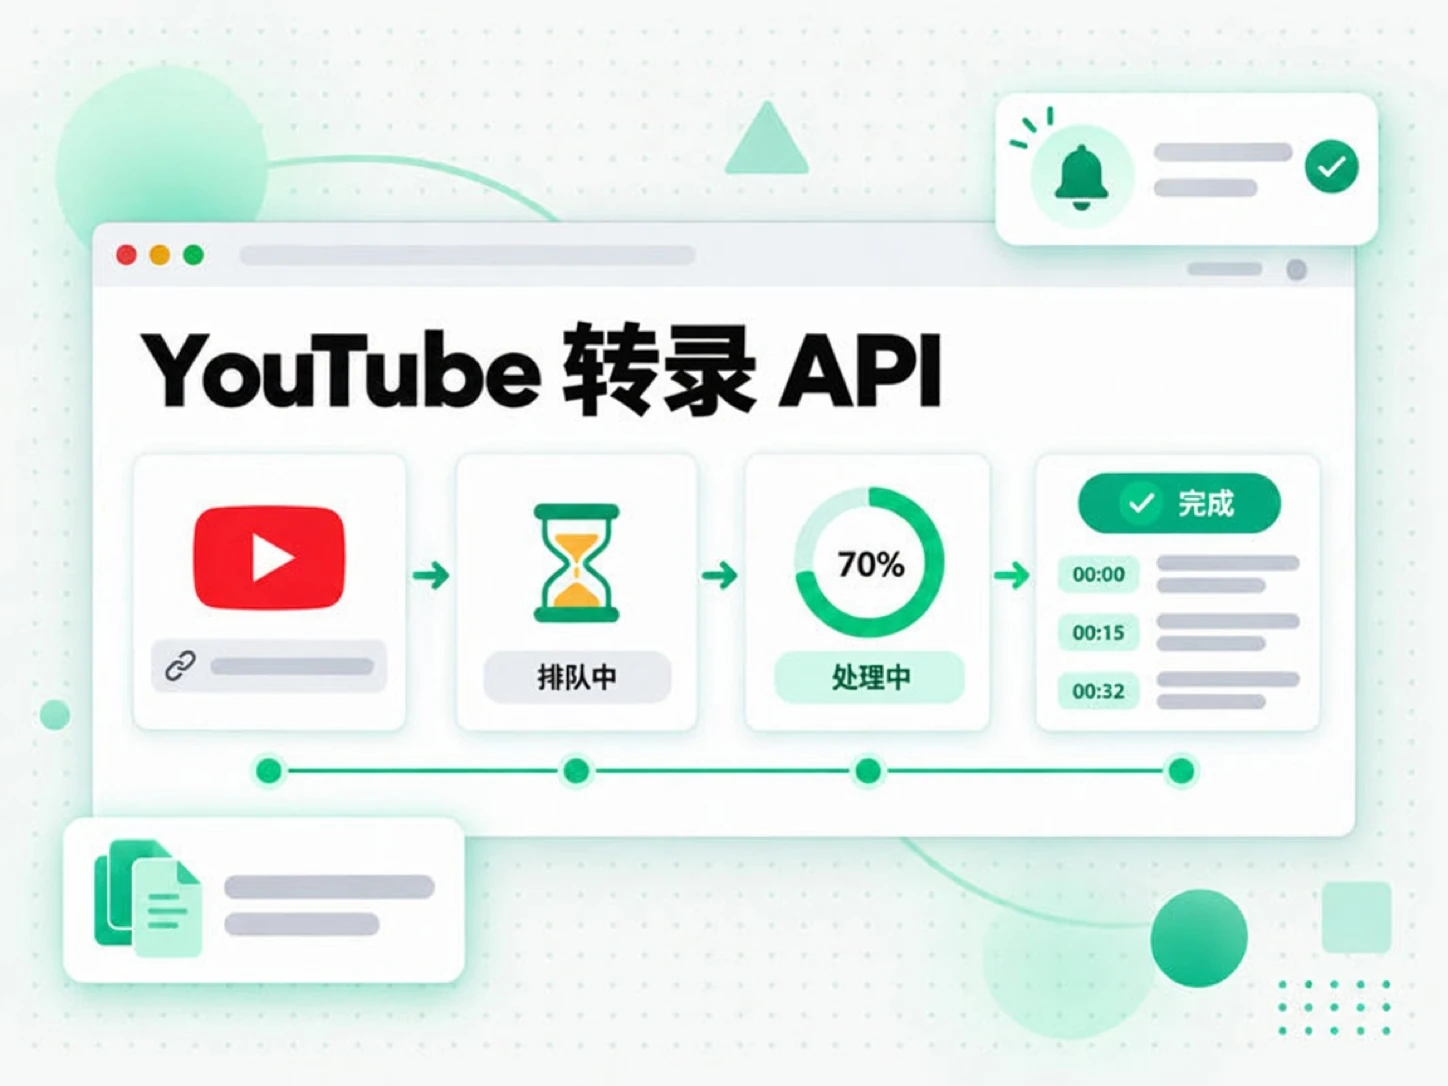
- 发送来源——提交
url,已知来源时传platform和externalId,或以multipart/form-data把文件上传到同一个端点。 - 命中字幕——当视频带有你列表中的某种语言字幕时,转录会直接随响应返回。
- 处理语言未命中——当存在字幕但没有一条匹配你的列表时,请求会继续走 AI 转写并返回
202和一个 job id;只有在调用方不允许使用语音识别时,才会返回带availableLanguages的404。 - 强制或回退到 ASR——显式的
asr条目、完全没有字幕轨的视频,或上传的文件,都会启动 ASR 任务并返回 job id。 - 轮询或订阅流——用
GET /v1/transcript/job/{id}读取任务直到成功或失败,或订阅其/events流接收服务端推送的进度。任务查询即使任务失败也会返回200,所以要根据status字段分支。 - 读取结果——完成的转录带有解析出的语言、时长、带时间戳的分段,以及按需返回的元数据,如标题、作者和发布日期。
- 安全重试——已经提取过的转录会直接从缓存返回,不再启动新任务,所以同一个来源可以再次请求。
- 先探查——
GET /v1/transcript/info会解析来源并列出它能提供的语言,供你在决定提取前判断。
202 和 job id,真正不存在的资源或不被允许的兜底则返回 404。文本准备好后,每条路径都返回同一种转录结构。批量提取与导出
真实工作很少只处理一个视频,因此 API 接受 URL 列表、播放列表或频道形式的批量任务。每个批量都跟踪自己的统计——有多少条待处理、多少条成功、多少条失败——并按页返回条目,长频道不会以一整块巨大的负载到达。
- 三种批量形态——
POST /v1/batch根据你发送的请求体接受 URL 列表、播放列表或频道。 - 独立状态——失败的链接会被单独标记,绝不会丢弃批量中的其余条目;失败条目可以用
/retry重试。 - 分页条目——用
GET /v1/batch/{batchId}读取批量,然后跟随返回的 page token 获取剩余条目。 - 实时进度——每次轮询都返回更新后的计数,调用方可以展示长任务完成了多少。
- 按你的格式导出——从
/export把完成的批量下载为txt、csv、json、srt、vtt或zip。
srt 和 vtt 导出可以直接放进编辑器或播放器。对归档来说,csv、json 和 zip 让整座录像库作为一个语料可供搜索。这些格式与单条转录的响应保持一致,所以能处理单条结果的调用方,已经知道如何读取批量。账户资料库中已保存的转录
提取与存储是两回事:转录一旦被保存,就成为账户资料库的一部分,而资料库正是你之后读取、搜索、下载和删除它的地方,无需重新执行提取。
- 列出已保存内容——
GET /v1/library/transcripts分页遍历账户的转录、批量记录和失败历史行,支持搜索、平台与语言筛选以及排序。 - 读取单条——
GET /v1/library/transcripts/{platform}/{externalId}按平台与外部 id 返回已保存的转录,或按你指定的语言返回。 - 下载——
/download路由把已保存的转录导出为txt、srt、vtt、json或md。 - 相关内容——
/related路由列出同一频道下其他已保存条目。 - 删除——
DELETE把条目从资料库移除,不会动到别人的副本。 - 限定账户的读取——资料库请求只返回该账户保存的内容,绝不启动新的提取,所以回看一条已保存的转录是读取,而不是又一个任务。
转录之外的 YouTube 发现能力
YouTube 是 API 还能回答转录周边问题的平台,使用与 YouTube Data API 相同的资源命名。
- 搜索——
GET /v1/youtube/search按查询找视频、频道或播放列表,返回游标分页结果。 - 视频——
GET /v1/youtube/videos返回视频详情,包括是否有可用字幕。 - 频道——
GET /v1/youtube/channels按 id 或@handle解析频道。 - 频道上传——
GET /v1/youtube/channels/{channelId}/videos遍历一个频道的上传。 - 播放列表条目——
GET /v1/youtube/playlists/{playlistId}/items遍历一个播放列表。 - 字幕——
GET /v1/youtube/captions返回视频的字幕轨元数据和字幕正文。它绝不启动语音识别任务:当它报告requiresAsync时,调用POST /v1/transcript来执行转写。
为生产环境而设计
接口面故意做得很小,服务真正在意的部分都有文档可依,而不是靠猜。
- 一个凭证——用 Bearer 令牌形式发送 API 密钥认证,或在脚本、服务器里用
X-API-Key。 - 带作用域的密钥——只授予调用方需要的作用域,
transcripts和batches分别覆盖提取与批量工作。 - 结构化错误——提取和校验失败返回带稳定
code与可读message的错误对象;认证 (401) 和限流 (429) 响应使用更简单的扁平错误体。 - 可执行的限制——被限流的请求返回
429和Retry-After,成功响应会带X-RateLimit-*头,让客户端能正确退避。 - 公开的契约——完整的 OpenAPI 文档支撑这套 API,你可以生成客户端、模拟服务端,或用 schema 校验真实响应。
- 面向智能体的兄弟入口——如果你的调用方是 AI 客户端而不是服务,同一个账户和工具也可以通过 transcript.im MCP 服务器访问。
相关工具
转录 API 常见问题
transcript.im API 是什么?
transcript.im API 是一个 REST 接口,把公开的视频或音频链接转化成带时间戳的转录文本,优先使用已有字幕,视频没有字幕时使用 AI 转写。
transcript.im API 支持哪些平台?
它会从你发送的链接识别平台,提取 YouTube、TikTok、Instagram、LinkedIn 和 Twitter/X 的转录。YouTube、TikTok 和 LinkedIn 优先使用字幕,以语音识别作为兜底;Instagram 和 X 没有字幕轨,会直接走语音识别。
视频没有字幕时会怎样?
当视频完全没有字幕轨时,API 会启动 ASR 任务并返回 job id;你轮询该任务直到转录准备好,所以请求不会因语音识别而阻塞。
可以转录本地的音频或视频文件吗?
可以。POST /v1/transcript 接受带 file 部分的 multipart/form-data 请求体,用它替代 URL。上传的文件会直接走语音识别,因此返回 202 任务——如果在等待预算内完成,则返回 200 结果。
transcript.im API 能在返回文本的同时带上时间戳吗?
可以。JSON 响应带有带时间戳的分段,文本响应可以保留每行的时间戳前缀,因此你可以回到某句话被说出的那一刻。
如何请求特定语言的转录?
发送一个逗号分隔的语言优先级列表,包含 asr 和 asr-<code> 条目。字幕命中会直接返回;当存在字幕但没有一条匹配列表时,请求会继续走 AI 转写并返回 202 任务,只有在不允许使用语音识别时,才会返回带可用语言的 404。
怎样知道异步转录已经准备好?
用同一个凭证轮询 GET /v1/transcript/job/{id},直到它报告成功或失败,或订阅 GET /v1/transcript/job/{id}/events 接收服务端推送的更新。任务查询在任务失败时也返回 200,所以请读取 status 和 error 字段,而不是 HTTP 状态码。
transcript.im API 支持批量提取吗?
支持。一个批量接受 URL 列表、播放列表或频道,跟踪每个条目的状态,并按页返回条目。
可以下载哪些导出格式?
完成的批量可导出为 txt、csv、json、srt、vtt 或 zip;单条已保存的转录可下载为 txt、srt、vtt、json 或 md。
已保存的转录放在哪里?
账户资料库就是已保存的转录和批量记录所在之处,位于 /v1/library 下。它提供列出、读取、下载、相关和删除路由,读取限定在账户范围内,绝不启动新的提取。
YouTube 字幕端点返回什么?
GET /v1/youtube/captions 返回视频的字幕轨元数据以及字幕正文。它绝不启动语音识别任务;当它报告 requiresAsync 时,调用 POST /v1/transcript 来执行转写。
transcript.im API 如何报告错误和限流?
提取和校验错误使用带 code 和 message 的对象;认证返回扁平的 401,限流返回扁平的 429,并带 Retry-After 和 X-RateLimit-* 头,让客户端能正确退避。