
Interview transcript opmaken: praktische opmaakgids
Leer de beste werkwijzen voor het opmaken van interviewtranscripten. Met sprekerslabels, tijdstempels, letterlijk versus opgeschoond en publicatietips.
Een transcript kan er af uitzien en toch bijna nutteloos zijn. De audio staat in de map, het automatische ondertitelbestand staat er ook, en toch moet iemand die rommel omzetten in iets wat een journalist kan citeren, een onderzoeker kan coderen, of een producer kan exporteren zonder de timing te breken. Daar begint de indeling van een interviewtranscript pas echt werk te doen, want hetzelfde interview kan worden gevormd tot heel verschillende opleveringen, afhankelijk van wie het daarna nodig heeft.
De eerste fout is lay-out behandelen als decoratie. Dat is het niet. Een degelijk kopblok, schone sprekerslabels, tijdstempels, aanwijzingen tussen haakjes en verstandige alinea's maken het transcript leesbaar in Word, overdraagbaar naar PDF en makkelijker te verplaatsen naar tekstexportformaten verderop in de keten. Daarom komen institutionele richtlijnen steeds weer op dezelfde basis uit: marges van 1 inch, lettergrootte 12 punten, links uitgelijnd en zichtbare paginamarkeringen in archiveringsworkflows. Als je een referentiepunt wilt voor de presentatie van gestructureerde rapporten voordat je je eigen template bouwt, is het ook handig om professionele rapportformaten te bekijken, zodat je ziet hoe een documentaire structuur verandert hoe een bestand wordt gelezen.
Voor teams die vanuit audio beginnen in plaats van vanuit een gepolijst bestand, kan een snelle opnameworkflow helpen voordat het opruimen begint. Een praktisch startpunt is de workflow voor audiotranscriptie; leg daarna de transcriptstructuur over de draft heen in plaats van vorm en inhoud tegelijk te willen bedenken.
Waarom de indeling van een interviewtranscript al belangrijk is voordat je opneemt
Een interview van 90 minuten belandt als één audiobestand en een ruwe dump van automatische ondertitels in een gedeelde map. Tegen de ochtend wordt van een junior editor verwacht dat die bruikbare citaten eruit haalt, namen bewaart en het bestand consistent genoeg maakt zodat niemand het twee keer hoeft te ontcijferen. Dat is het punt waarop lay-out ophoudt cosmetisch te zijn en een bewerksysteem wordt.
De snelste manier om tijd te verliezen is eerst transcriberen en later formatteren. Een lang transcript achteraf herwerken betekent elke sprekersbeurt, elk tijdstempel en elke notitie over pauzes of overlap aanraken. Een vastgezet template bespaart dat opruimwerk. Het houdt ook één interview bruikbaar voor heel verschillende uitvoer, want een citaatbestand voor een redactie, een transcript voor kwalitatieve codering, een archiefkopie en een ondertitelconcept hebben niet dezelfde dichtheid aan detail nodig.
Een beslissing over lay-out begint bij het gebruik verderop.
Een transcript voor codering heeft consistente sprekersbeurten nodig en een structuur die analisten kunnen scannen. Een archieftranscript heeft herkomst en behoudend letterlijk gebruik nodig. Een gepubliceerd artikel heeft leesbaarheid nodig. Een ondertitel- of captionworkflow heeft meer timingdiscipline nodig dan literaire schuring. Bouw de lay-out rond de taak, en je vermindert herzieningen. Je voorkomt ook dat je één huisstijl naar elk project kopieert.
Voor teams die met audio beginnen in plaats van met een gepolijst bestand, kan een snelle opnameworkflow helpen voordat het opruimen begint. Een praktisch startpunt is de workflow voor audiotranscriptie; leg daarna de transcriptstructuur over de draft heen in plaats van vorm en inhoud tegelijk te willen bedenken. Als je een referentie nodig hebt voor hoe een bestand op de pagina leest, is het ook handig om professionele rapportformaten te bekijken voordat je je eigen template vastlegt.
Het kopblok verdient ook vroeg aandacht, want het zet het bestand klaar voor later gebruik. Ik beschouw het als onderdeel van het transcript, niet als een begeleidende notitie. Een schoon transcript begint meestal met titel en metadata en gaat dan over in de dialoog.
Een degelijke institutionele gids van het American Folklife Center geeft een nuttige basis voor oral-historybestanden. Die schrijft marges van 1 inch voor, 12-punts Times New Roman, links uitgelijnd, geen inspringingen bij sprekers, en geen gebogen aanhalingstekens in het definitieve bestand. Paginanummers komen onderaan gecentreerd, en niet op de omslag- of voorwoordpagina's.
Die regels staan er niet alleen voor de stijl. Ze houden het transcript leesbaar in Word, stabiel in PDF en makkelijker te verplaatsen naar archiefsystemen of tekstexportformaten zonder de uitlijning te breken. Voor een editor is dat de test.
De basisbouwstenen van een schoon interviewtranscript
Een schoon transcript begint meestal met een kopblok dat de basis vastlegt voordat de dialoog begint. Ik zou dat blok als essentiële metadata behandelen, want archieven en redactieteams vertrouwen er allebei op om het bestand later leesbaar te houden.
Een praktisch kopblok kan het volgende bevatten:
- Titel van het interview
- Datum
- Locatie of medium
- Naam van de interviewer
- Naam en rol van de geïnterviewde
- Opnameduur
De rest van het bestand werkt beter wanneer elke sprekerbeurt gemakkelijk te scannen is. Een degelijke institutionele gids van het American Folklife Center stelt dat oral-history-transcripten moeten beginnen met titel en metadata, met marges van 1 inch, Times New Roman van 12 punten, links uitgelijnd, zonder inspringing bij sprekers, zonder gekrulde aanhalingstekens, en met paginanummers onderaan gecentreerd en geen paginanummer op de omslag of de voorpagina's. Dezelfde soort documentaire structuur duikt op in archiefgidsen die vragen om namen, datums, locaties en versiebeheer voordat de dialoog begint, omdat die details indexering en latere citatie ondersteunen. Voor een volledige redactionele workflow komen de topplatforms voor het transcriberen van interviews vaak op dezelfde structurele keuzes uit in hun export- en bewerkingshulpmiddelen.
Sprekerlabels en plaatsing van tijdstempels
Sprekerlabels moeten consistent blijven. Drie veelvoorkomende vormen houden zich goed staande in de praktijk:
- Voornamen in ALL CAPS als je heel snel wilt kunnen scannen
- Rolabels zoals INTERVIEWER en SUBJECT wanneer anonimiteit belangrijk is
- Volledige naam bij de eerste vermelding, daarna alleen de achternaam wanneer archiveringsprecisie belangrijk is
Een aparte archiefgids voegt toe dat eerste vermeldingen volledige namen moeten gebruiken en dat later moet worden overgeschakeld op achternamen. Een andere transcriptiegids vereist dat tijdstempels minstens één keer per pagina en in real time verschijnen, met twee spaties na de tijdstempel voordat de tekst begint. Ik geef de voorkeur aan een tijdstempelregel boven een beurt voor bestanden die doorzoekbaar moeten zijn, maar inline tijdstempels werken wanneer je een strakkere leesflow wilt in Word of Google Docs.
Praktische regel: als je later nog gaat bewerken, zet tijdstempels op de plek waar ze het gemakkelijkst te scannen zijn en het minst snel per ongeluk worden verwijderd.
Non-verbale signalen en alineaonderbrekingen
Tussen haakjes geplaatste signalen moeten doelgericht blijven. Veelvoorkomende voorbeelden zijn [laughs], [pause], [unclear] en [00:42:15 crosstalk]. Ze doen ertoe wanneer een pauze de betekenis verandert of een overlap de toeschrijving beïnvloedt, maar ze mogen de pagina niet overspoelen alleen omdat de audio ze bevat.
Alineaonderbrekingen moeten beginnen bij het nieuwe sprekerlabel, niet met ingesprongen vervolgen. Dat houdt het bestand leesbaar na kopiëren en plakken in CMS-velden, ondertitelhulpmiddelen of tekstuele beoordelingssystemen. Een eenvoudig werkbestand kan er zo uitzien:
Projectinterview, 12 maart 2026, Zoom
Interviewer: Mia Chen
Gast: Jordan Lee, productmanager
00:01:12
MIA: Bedankt dat je erbij bent. Kun je me meenemen door de lancering?
00:01:16
JORDAN: Zeker. We hadden een krappe planning en het team was nog bezig met de definitieve scope. [pause]
00:01:24
MIA: Wat veranderde er als eerste?
Dat formaat is eenvoudig, maar het geeft redacteuren de ankerpunten die ze nodig hebben.
Letterlijk versus opgeschoonde transcripten
De nuttigste manier om over transcriptstijl na te denken is als een continuüm, niet als een tweedeling. Aan het ene uiterste staat strikt letterlijk (verbatim), dat valse starts, stopwoorden en gestotter behoudt. In het midden staat intelligent verbatim, dat wat rommel verwijdert maar de betekenis en het ritme van de spreker behoudt. Aan het andere uiterste staat een opgeschoonde leesbaarheidstranscript, dat de ideeën behoudt maar weglaat wat de pagina vertraagt.
| Oorspronkelijke gesproken uitwisseling | Letterlijke versie | Opgeschoonde versie |
|---|---|---|
| "Dus, eh, ik, ik denk dat we zo'n beetje, zeg maar, de deadline hebben gemist omdat de leverancier, eh, het bestandsformaat heeft gewijzigd." | Dus, eh, ik, ik denk dat we zo'n beetje, zeg maar, de deadline hebben gemist omdat de leverancier, eh, het bestandsformaat heeft gewijzigd. | Ik denk dat we de deadline hebben gemist omdat de leverancier het bestandsformaat heeft gewijzigd. |
| "Nee, ik bedoel, het team heeft het wel geprobeerd, maar we hadden de definitieve cijfers nog niet." | Nee, ik bedoel, het team heeft het wel geprobeerd, maar we hadden de definitieve cijfers nog niet. | Het team heeft het wel geprobeerd, maar we hadden de definitieve cijfers nog niet. |
Wanneer strikt letterlijk zijn waarde bewijst
Letterlijke transcripten zijn de veiligste keuze wanneer de formulering zelf het bewijsstuk is. Ze beschermen tegen claims van verzonnen citaten, behouden aarzelingen die relevant zijn in taalkundige of psychologische analyse, en houden beter stand bij juridische toetsing dan een gepolijste herschrijving. Ze blazen ook het woordenaantal op en lezen slecht op de pagina, dus ze zijn zelden de beste optie voor een publiekgericht artikel.
Opgeschoonde transcripten doen het tegenovergestelde. Ze zijn gemakkelijker te citeren in een gepubliceerd verhaal, gemakkelijker te scannen in een managementsamenvatting en meestal gemakkelijker voor toegankelijkheidsworkflows omdat de zinsbouw minder hakerig is. De afweging is het oordeel, want een redacteur moet beslissen welke stopwoorden ruis zijn en welke valse starts onzekerheid, nadruk of toon laten zien.
De ethische grens
Kwalitatief onderzoek, oral history en getuigenverklaringen rechtvaardigen vaak een letterlijker transcript. Journalistiek en contentmarketing hebben vaak eerst leesbaarheid nodig. Als je van plan bent een direct citaat te publiceren, schoon het dan niet op en presenteer het niet als letterlijk. Daar komen redacteuren in de problemen, omdat het publiek aanneemt dat de woorden precies zo zijn uitgesproken.
De zuiverste regel is simpel. Gebruik de versie die past bij het risico van het eindproduct. Als het bestand gecontroleerd kan worden, in een archief bewaard wordt of gebruikt wordt om een beslissing te verdedigen, bewaar dan meer van de gesproken textuur. Als het bestand bedoeld is om snel gelezen te worden door een klant, manager of lezer, kort het dan zorgvuldig in en leg de keuze vast in je huisstijl. Voor teams die een aparte opschoonronde willen, is de clean verbatim-workflow de plek waar dat redactionele oordeel een herhaalbaar proces wordt.
Een stijlgids kiezen en je conventies vastleggen
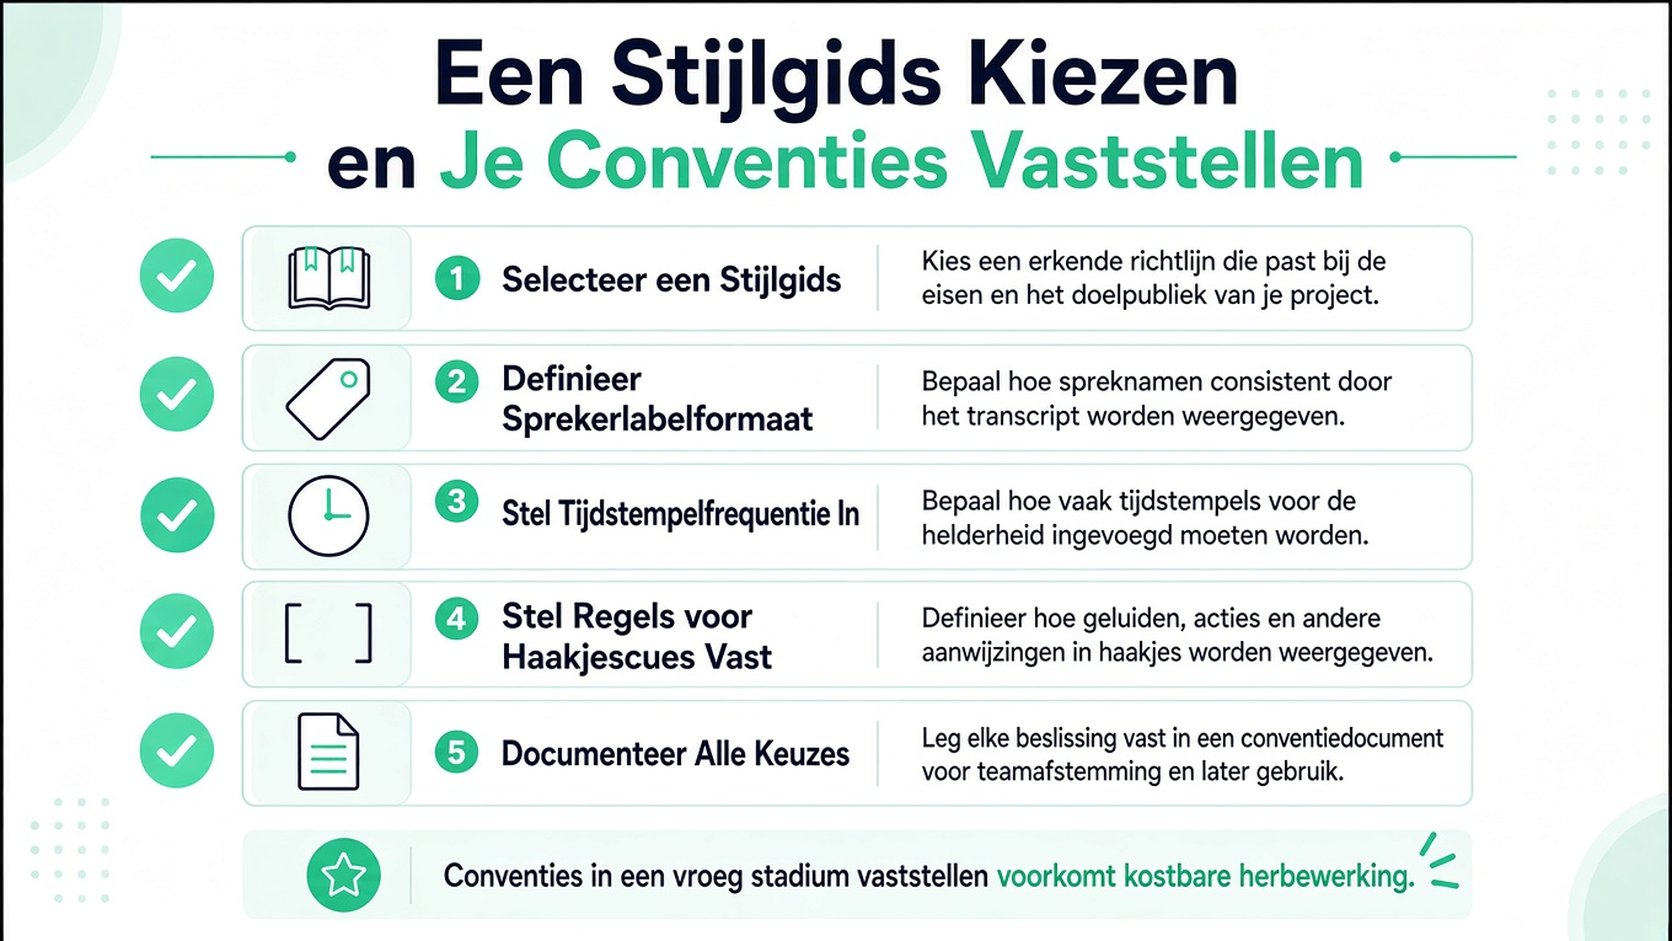
Een transcriptproject wordt makkelijker zodra je stopt met improviseren. Of je nu leent van AP, Chicago, APA of een eigen huisstijl, de gids zelf is minder belangrijk dan de consistentie die eruit volgt, want niemand wil twintig interviews opnieuw opmaken nadat de eerste redacteur merkt dat de sprekerlabels niet overeenkomen.
De beslissingen die eerst moeten worden vastgelegd
Voordat het transcriberen begint, leg je deze punten vast en schrijf je ze op in een conventieblad van één pagina:
- Formaat van sprekerlabels met één regel voor elk bestand
- Precisie van tijdstempels met één spatiepatroon
- Paralinguïstische signalen met één haakjesstijl
- Omgaan met stopwoorden met één standaard voor herhaling en valse starts
- Regels voor beletselteken en [onverstaanbaar] met één eenduidig gebruikspatroon
Dat blad moet met het project meereizen. Een transcriber, redacteur en reviewer moeten allemaal hetzelfde document kunnen openen en dezelfde logica zien.
Een schoon conventieblad vermindert ook de wrijving wanneer meerdere bestanden door dezelfde pijplijn gaan. Hetzelfde interview kan van een concepttranscript naar een citatenblad gaan, dan naar een CMS, en dan naar een ondertitelexport. Als het labelformaat halverwege verandert, beginnen de latere bestanden kleine fouten te erven die vervelend zijn om te repareren en makkelijk te missen.
Wat consistentie je oplevert
De archiveringsgidsen zijn hier nuttig omdat ze laten zien hoeveel werk er in eenvoudige consistentie gaat zitten. De ene universiteitsgids vraagt om namen van interviewer en geïnterviewde, datum, locatie en duur op de eerste pagina, met paginanummers op elke pagina. Een andere archiefgids vraagt om collectienummer, namen van vertellers, namen van interviewers en datum in de kop, en houdt daarna een consistente kop op latere pagina's. Die keuzes gaan net zozeer over controleerbaarheid als over uiterlijk, en dezelfde logica geldt in moderne redactieteams.
De sterkste teams discussiëren niet over de opmaak van elk bestand. Ze definiëren die één keer en handhaven die vervolgens. Dat is wat het transcript leesbaar houdt wanneer het van ruwe opname naar review gaat, en dat is wat voorkomt dat je redacteuren tijd verspillen aan vermijdbare opschoonwerk. De ingesloten video hieronder is nuttig als je een andere kijk wilt op setupdiscipline en softwareworkflow.
{% youtube id="rhEgDJT_2w0" /%}
Opmaak aanpassen voor onderzoek, archief, nieuws en ondertitels
Hetzelfde interview kan op vier verschillende plekken terechtkomen, en elk daarvan vraagt om een andere opmaak. Een codeertranscript heeft structuur nodig die analisten zonder wrijving kunnen taggen. Een archivetranscript heeft herkomstinformatie nodig die jaren later nog steeds logisch is. Een gepubliceerd interview heeft leesbare proza nodig. Een ondertitelbestand heeft timing nodig die past bij wat kijkers op het scherm kunnen bijhouden. Eén sjabloon dient zelden alle vier goed.
| Eindproduct | Sprekerlabel | Tijdstempels | Verbatim-niveau | Speciale functies |
|---|---|---|---|---|
| Kwalitatief onderzoek | Op rol gebaseerd of volledige namen | Frequent, consistent | Hoog, met niet-verbale signalen | Regelnummering, overlapmarkeringen, codeervriendelijke alinea's |
| Oral-history-archief | Volledige namen, daarna achternamen | Zichtbaar op elke pagina | Conservatief verbatim | Metadatakop, versiebeheer, herkomstgegevens |
| Gepubliceerd artikel | Volledige namen of rollen | Selectief | Opgeschoond voor leesbaarheid | Uitgelichte citaten, strakkere alinea-indeling, regels klaar voor toeschrijving |
| Ondertitelbestand | Rolaanduidingen of korte namen | Cue-in en cue-out exact | Ingekort voor leessnelheid | Controle op tekens per regel, weergavetiming, ondertitelexport |
Onderzoeks- en archiefbestanden doen verschillend werk
Een kwalitatief onderzoeker heeft een bestand nodig dat gescand, gecodeerd en vergeleken kan worden tussen interviews. Dat betekent meestal een consistente alinea-indeling, overlapmarkeringen en genoeg context om de betekenis te bewaren zonder de pagina vol ruis te zetten. Archiefteams willen een conservatiever verslag, omdat het transcript later geciteerd kan worden en namen, data en het oorspronkelijke spreekpatroon moet bewaren.
Redactie- en uitgeefworkflows vragen iets anders. Redacteuren hebben een transcript nodig dat prettig leest, met sprekerbeurten die makkelijk toe te schrijven zijn en alinea's die de pagina niet tegenwerken. Dat betekent vaak stopwoorden schrappen en de structuur strakker maken, terwijl het interview nauwkeurig genoeg blijft om te citeren. Ondertitels leggen een andere beperking op. Het bestand moet op het scherm passen, de leessnelheid respecteren en elke cue uitgelijnd houden met de gesproken regel.
Een eigen lay-out per workflow werkt beter dan één vaste opmaak
Teams verliezen tijd wanneer ze één lay-out forceren op elk gebruiksscenario. Codeurs hebben één versie nodig, archiefmedewerkers een andere, en video-editors willen vaak een ondertitel-export die een ander ritme volgt dan het gepubliceerde transcript. Eén bronbestand helpt nog steeds, maar de uitvoer moet meeveranderen met de taak die volgt.
Wanneer hetzelfde interview zowel een research-gecodeerde versie als een SRT-ondertitelbestand nodig heeft, helpt een werkruimte zoals transcript.im, omdat die het transcript van tijdstempels voorziet en je TXT en SRT uit dezelfde bron laat exporteren zonder het bestand handmatig opnieuw op te bouwen. Moet je eerst Video naar tekst omzetten, dan houdt diezelfde flow het transcript klaar voor latere omzettingen naar TXT, SRT of VTT, afhankelijk van of de volgende stap coderen, publiceren of ondertitelen is.
Schoonmaken, tijdstempelen en exporteren zonder de uitlijning te verstoren
Ruwe concepten gaan meestal op dezelfde plek mis: de tijdstempel wijst niet meer netjes naar de gesproken regel. Zodra die uitlijning afwijkt, breekt het ondertitelen, wordt het terugvinden van fragmenten rommelig en verliezen redacteuren hun vertrouwen in het bestand. De veiligste workflow is de originele timecode-kolom te bewaren terwijl je de tekst eromheen opschoont.
Een betrouwbare bewerkingsronde
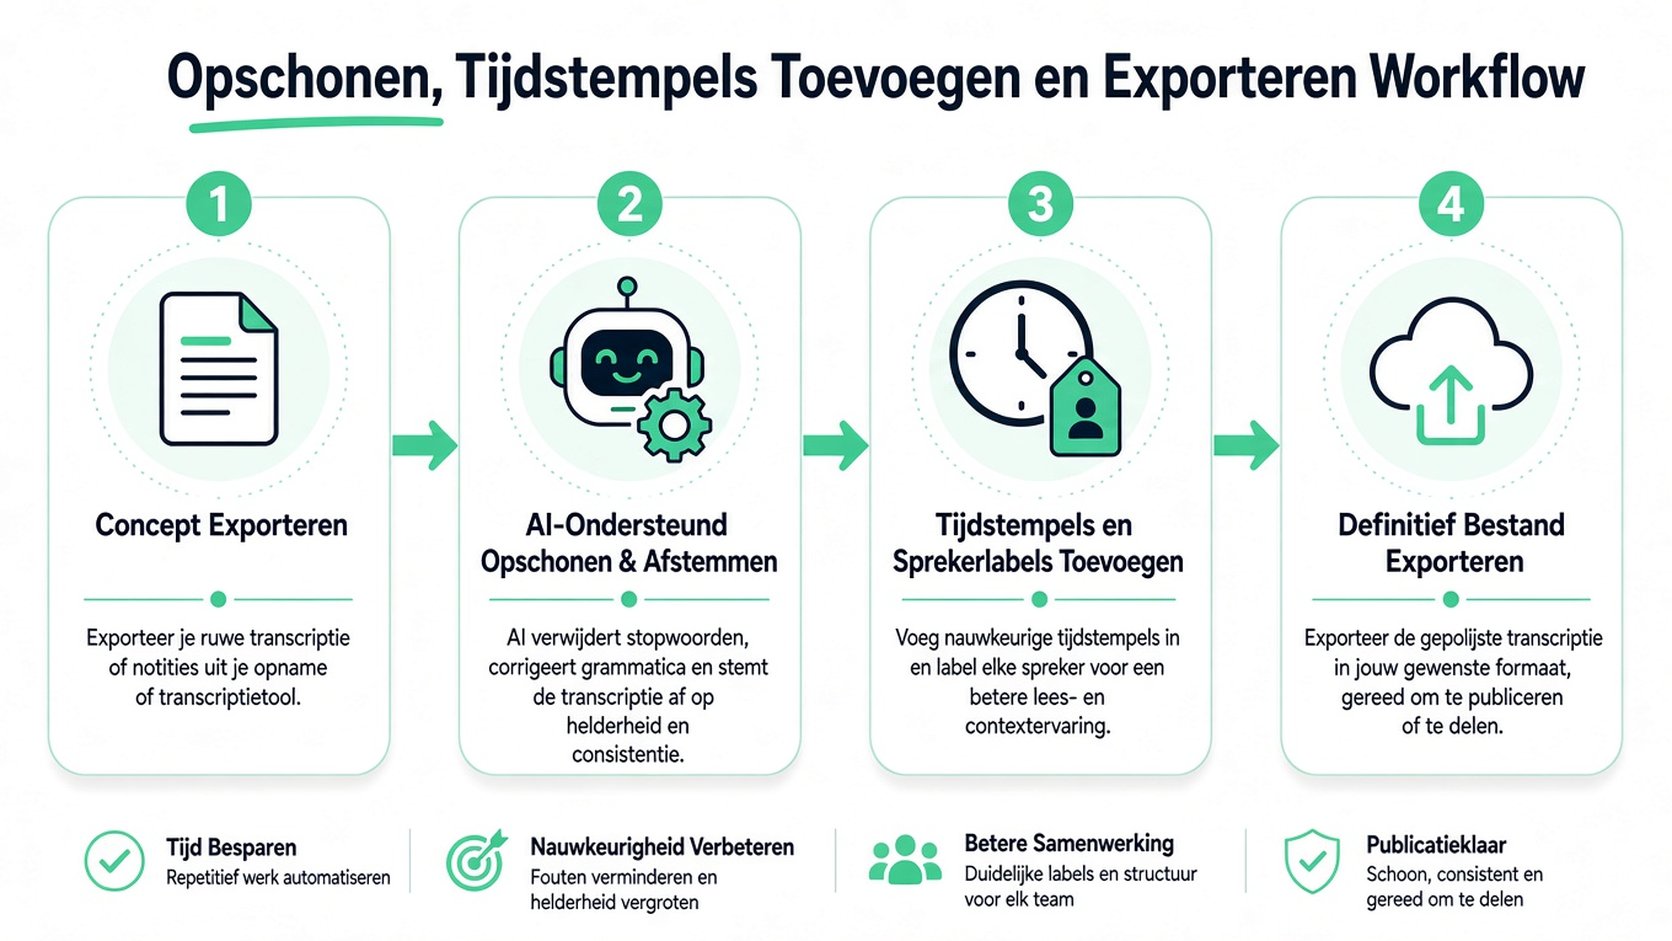
Begin met het exporteren van het automatische transcript met ingebedde tijdstempels. Doe daarna één opschoonronde die alleen stopwoorden verwijdert waar de leesbaarheid dat echt vereist, terwijl de originele tijdsstructuur intact blijft. Als je in een AI-ondersteunde tool werkt, beschouw het concept dan als het bronbestand en de opgeschoonde kopie als de presentatielaag.
Uitlijning is belangrijker dan elegantie. Een transcript dat prachtig leest maar naar de verkeerde audio wijst, is een slecht transcript.
Die uitlijningsregel geldt voor alle exporttypes. Word-bestanden zijn makkelijk te controleren, maar ze kunnen de structuur afvlakken als mensen kolommen verwijderen of tekst slordig herschikken. SRT en VTT behouden de timing van ondertitels, CSV helpt bij codeersoftware en spreadsheetreviews, en JSON is de gebruikelijke vorm wanneer teams transcriptgegevens via API's willen versturen. Het formaat dat je kiest, moet passen bij de volgende stap, niet alleen bij de huidige.
Controleer het bestand voordat het je handen verlaat
Een laatste steekproefcontrole tegen de audio is de tijd waard. Luister naar een paar lastige overgangen, bevestig dat sprekerlabels nog steeds kloppen, en controleer dat geen enkele opschoonronde de regel heeft verschoven waar een citaat begint. Als je een workflow gebruikt met vertaling, opschonen of batch-export, laat de bron met tijdstempels dan onaangeroerd, zodat latere versies nog steeds terug te herleiden zijn naar de oorspronkelijke spraak.
Voor teams die vóór de bewerkingsronde van audio naar een bruikbaar concept willen gaan, is de workflow voor audio naar tekst een praktisch startpunt. Het is veel makkelijker om de uitlijning te bewaren wanneer het eerste concept al de tijdsstructuur bevat die je nodig hebt.
Snelstartchecklist voor je volgende interviewtranscript
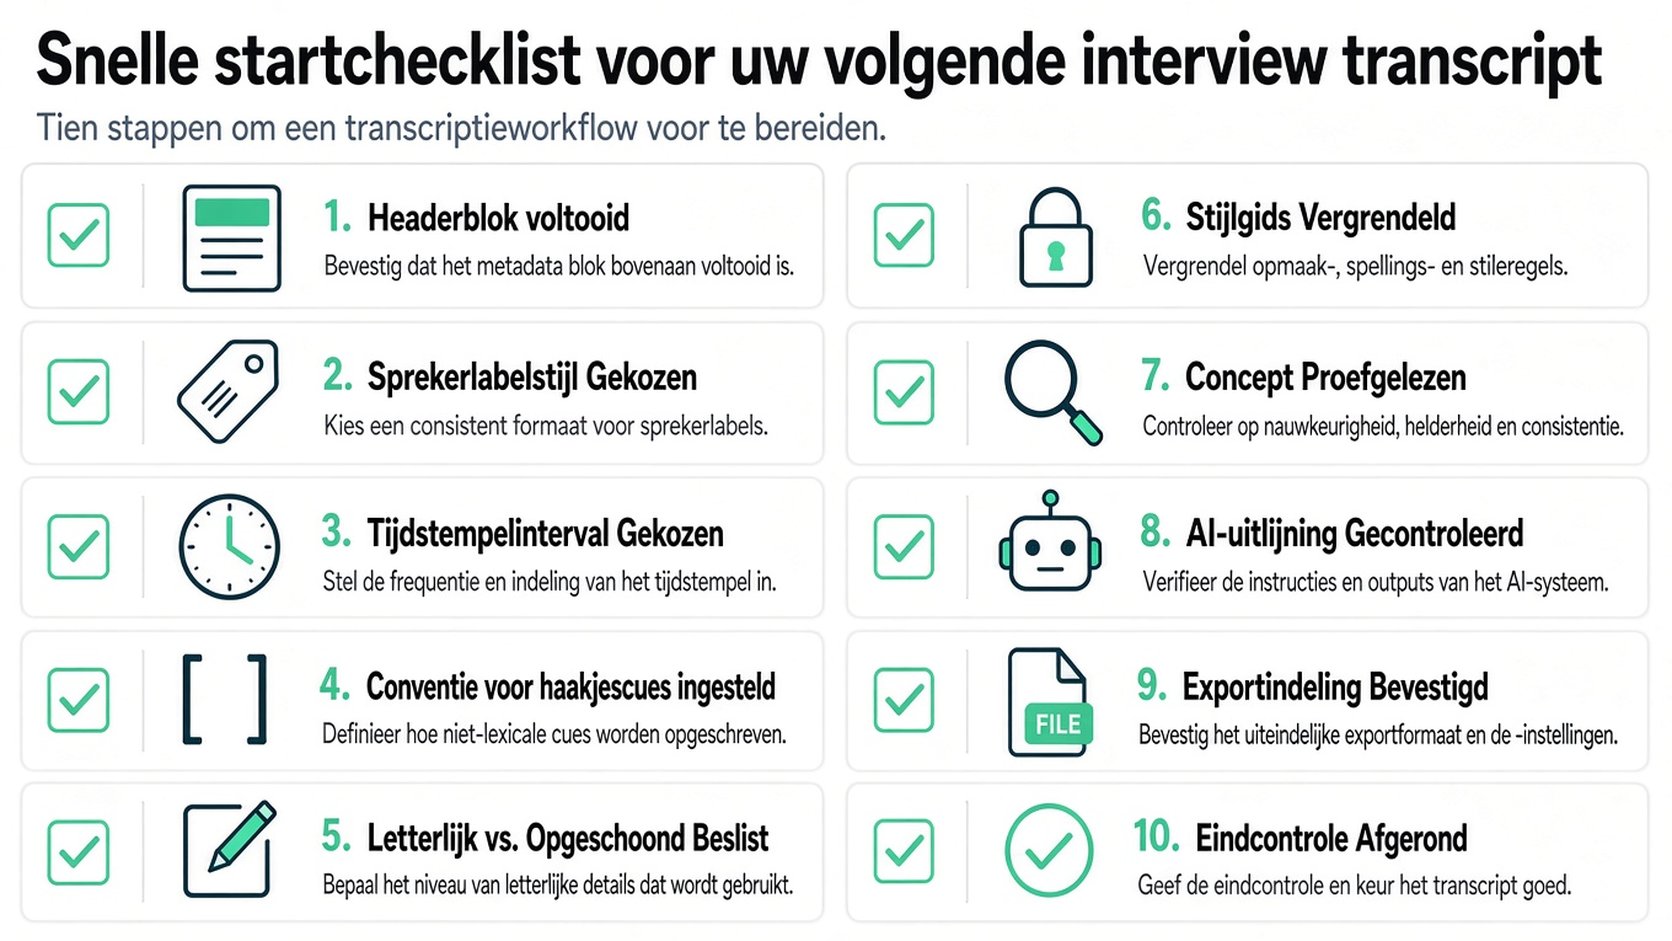
Gebruik dit als een invulblad van één pagina naast je transcriptietool.
- Vul het kopblok in met titel, datum, locatie of medium, interviewer, geïnterviewde en duur.
- Kies één stijl voor sprekerlabels en houd die ongewijzigd gedurende het hele project.
- Stel het tijdstempelinterval in en bepaal of het op een eigen regel staat of inline.
- Definieer regels voor cues tussen vierkante haken voor pauzes, gelach, overlap en onduidelijke audio.
- Bepaal letterlijk versus opgeschoond voordat het eerste concept wordt herzien.
- Zet de stijlgids vast die je volgt, zelfs als het een eigen huisstijl is.
- Controleer namen en jargon tegen de audio en eventuele bronnotities.
- Controleer de AI-uitlijning zodat tijdstempels nog steeds naar de juiste spraak wijzen.
- Bevestig het exportformaat voor Word, TXT, SRT, VTT, CSV of JSON.
- Doe een laatste controle van één kort gedeelte voordat je het volledige bestand vrijgeeft.
Een interview van 45 minuten verloopt meestal soepel als de volgorde stabiel is. Importeer de audio, genereer de eerste versie, pas de transcriptstijl toe, ruim de sprekerbeurten op, controleer de tijdstempels aan de hand van de opname en exporteer het definitieve bestand daarna in het formaat dat het volgende team nodig heeft. De lay-outkeuzes die er het meest toe doen, zijn de keuzes die je vastlegt voordat de revisie begint, niet nadat het bestand al door mappen verspreid is.
Wil je een werkruimte waarin transcripten leesbaar blijven, van tijdstempels voorzien zijn en makkelijker her te gebruiken zijn voor publicatie, onderzoek en ondertitelwerkstromen, bezoek dan Transcriberen en probeer het bij je volgende interview. Het helpt je audio en video om te zetten in gestructureerde tekst zonder vanaf een lege pagina te beginnen, zodat je minder tijd kwijt bent aan het repareren van de lay-out en meer tijd aan het gebruiken van het transcript.
Transcriberen
Zet elke video om in tekst
Plak een YouTube-, TikTok- of Instagram-link en lees het transcript, met tijdstempels op elke regel.
Exporteert als TXT, SRT of VTT.