
Clean transcript: een praktische gids voor verbatim transcriptie
Leer wat clean verbatim transcriptie betekent, hoe het verschilt van volledig verbatim en hoe je nauwkeurige, leesbare transcripten maakt voor elke workflow.
Je hebt een transcript voor je liggen, en het doet precies wat ruwe spraak doet. De spreker begint aan een gedachte, laat die vallen, komt erop terug, herhaalt een zin en laat een spoor van stopwoorden achter. Zo'n transcript is misschien trouw aan de opname, maar niet altijd trouw aan het werk dat je ermee moet doen.
Daar komt clean verbatim-transcriptie om de hoek kijken. Het zit in het midden van het spectrum: het houdt de betekenis van de spreker intact en haalt tegelijk de rommel weg die lezers afremt. De kunst is niet om spraak mooier te maken, maar om te bepalen welke ruis weg kan zonder het verslag te veranderen.
Waarom ruwe transcripten lezers afremmen
Een onderzoeker opent een automatisch gegenereerd interviewbestand en ziet het probleem meteen. Een deelnemer zegt: “Ik, uh, ik denk, ik denk dat we, we misschien, um, voor de tweede optie moeten gaan”, stopt midden in de zin en begint opnieuw. Een tweede spreker herhaalt dezelfde zin, en de tijdstempels lopen net genoeg uiteen om het fragment moeilijker terug te vinden.
Hetzelfde gebeurt bij klantgesprekken, teambijeenkomsten en marketingreviews. Het ruwe transcript bewaart de opname, maar de pagina leest nog steeds als spraak, niet als een document dat mensen kunnen scannen. Als het je werk is om te citeren, te vergelijken, thema's te taggen of notities te delen, besteed je je tijd dubbel: eerst om het transcript te maken en daarna om het bruikbaar te maken.
Praktische regel: Een transcript is alleen nuttig als een mens er sneller doorheen kan dan door de originele audio.
Spraak en lezen vragen om verschillende vormen. Gesproken taal bevat het opnieuw beginnen, overlappingen en verbale opvulling. Geschreven taal vraagt dat er genoeg van dat materiaal wordt weggehaald zodat de betekenis intact blijft, terwijl het oog verder kan zonder over elke valse start te struikelen. In die zin is clean verbatim een keuze tussen leesbaarheid en getrouwheid, en AI-workflows verschuiven waar die grens hoort te liggen. Een overzicht van de spraak-naar-tekstworkflow, Spraak naar tekst, laat zien hoe de opnamefase in het bredere proces past.
Voor onderzoekers en marketeers is het pijnpunt hetzelfde. Je hebt niet alleen de woorden nodig. Je hebt de woorden nodig in een vorm waarin je kunt zoeken, citeren, beoordelen en handelen zonder eerst met het transcript te worstelen.
Wat clean verbatim nu eigenlijk betekent
Clean verbatim-transcriptie behoudt de betekenis en bewoording van de spreker, maar haalt de mechanische ruis weg die geen semantische waarde toevoegt. Het doel is simpel: leesbaarheid zonder vervorming. Dat betekent dat je de echte ideeën, de nuanceringen, de verzachtende formuleringen en de toon behoudt, terwijl je stopwoorden, valse starts, herhalingen en fragmenten opruimt die de pagina alleen maar moeilijker leesbaar maken.
Wat wordt verwijderd en wat blijft
Een clean transcript is geen samenvatting. Het parafraseert niet en het herschrijft iemand niet tot gepolijst proza dat hij nooit heeft gebruikt. Het snoeit alleen de spreekgewoonten weg die lezers afremmen. Een nuttige vergelijking is een raam: het uitzicht blijft hetzelfde, maar de vlekken zijn verdwenen.
Een kort voorbeeld maakt de grens duidelijker:
Ruwe spraak: “Ik bedoel, ik was, uh, een beetje aan het denken dat we het, we het waarschijnlijk moesten uitstellen omdat de cijfers nog niet klaar waren.”
Clean verbatim: “Ik zat er een beetje aan te denken dat we het waarschijnlijk moesten uitstellen omdat de cijfers nog niet klaar waren.”
De tweede versie zegt hetzelfde. Ze haalt alleen de rommel weg die de boodschap niet verandert. Dat onderscheid is belangrijk bij ondertiteling, onderzoeksnotities en archieven waar lezers een trouwe weergave nodig hebben die toch prettig leest. Voor een verwante uitleg over het omzetten van gesproken materiaal in een leesbaar transcript is deze gids over het schrijven van een videotranscript een nuttige aanvulling.
Clean verbatim zit ook tussen twee andere uitersten in. Full verbatim houdt elke pauze en elke verspreking. Bewerkt proza vlakt de taal agressiever af en kan afdrijven naar een geschreven versie van de toespraak in plaats van de toespraak zelf. Clean verbatim houdt je dicht bij het origineel en maakt de pagina tegelijk bruikbaar.
De praktische grens
De eenvoudigste manier om clean verbatim te beoordelen is deze: als het weghalen van een woord verandert wat de spreker bedoelde, laat het dan staan. Als het alleen verandert hoe soepel de zin eruitziet, gaat het er waarschijnlijk uit. Die ene test houdt het werk gedisciplineerd en voorkomt dat het transcript een herschrijving wordt.
Clean verbatim versus full verbatim
Het verschil wordt snel duidelijk als je beide stijlen naast elkaar legt. Full verbatim behoudt het vocale gedrag van de spreker, terwijl clean verbatim de communicatieve bedoeling behoudt met de ruis eruit gefilterd.
| Volledig verbatim | Schoon verbatim | Toegepaste bewerking |
|---|---|---|
| “Ik, uh, ik denk dat we, we misschien moeten gaan voor, voor de tweede optie, want, um, de data was niet, niet klaar.” | “Ik denk dat we misschien voor de tweede optie moeten gaan, want de data was niet klaar.” | Vulwoorden en herhaalde woorden verwijderd |
| “De lancering was, was, was uitgesteld, en ik bedoel, we moesten, weet je, de tijdlijn opnieuw instellen.” | “De lancering was uitgesteld, en we moesten de tijdlijn opnieuw instellen.” | Herhaling en vulzinnen samengevat |
| “Ik begon te zeggen dat het budget in orde was, maar, uh, eigenlijk, nee, dat was het niet.” | “Ik begon te zeggen dat het budget in orde was, maar eigenlijk, nee, dat was het niet.” | Rommel van herstart verwijderd, correctie behouden |
| “We kwamen dinsdag bijeen en, [pauze], daarna hebben we de releasedatum verplaatst.” | “We kwamen dinsdag bijeen en, [pauze], daarna hebben we de releasedatum verplaatst.” | Een betekenisvolle pauzemarkering behouden |
Het doel van de vergelijking is niet om te zeggen dat de ene stijl in elk geval beter is. Het gaat erom dat ze verschillende leestaken dienen. Volledig verbatim helpt wanneer het exacte ritme van de spraak ertoe doet. Schoon verbatim helpt wanneer de lezer door de inhoud moet kunnen gaan zonder bij elke aarzeling te blijven hangen.
De schone versie mag nooit de betekenis van de spreker veranderen. Gebeurt dat wel, dan is de bewerking te ver gegaan.
Een transcription lead controleert elke regel meestal met dezelfde vraag: draagt dit woord betekenis, of hoort het gewoon bij de mechaniek van het spreken? Die vraag is wat opschonen onderscheidt van herschrijven.
De mechanische regels van schoon-verbatim-bewerking
De regels zijn smaller dan veel mensen denken. Schoon verbatim verwijdert vulwoorden zoals “um”, “uh” en “weet je” wanneer ze geen betekenis dragen, laat duidelijke valse starts weg, vat herhaalde woorden samen en laat materiaal dat de interpretatie zou veranderen intact. Getallen, namen, technische termen en vakjargon blijven zoals ze gesproken zijn, tenzij er een duidelijke transcriptiefout te corrigeren valt.
Wat je weglaat en wat je houdt
Hier is de eenvoudigste versie van de regels.
| Ruwe spraak | Schoon verbatim | Toegepaste regel |
|---|---|---|
| “Ik denk, uh, ik denk dat we moeten gaan.” | “Ik denk dat we moeten gaan.” | Herstart en vulwoord verwijderd |
| “Het, het rapport is klaar.” | “Het rapport is klaar.” | Herhaling samengevat |
| “Ik heb de data letterlijk zelf gedraaid.” | “Ik heb de data letterlijk zelf gedraaid.” | Beklemtoningswoord behouden |
| “We hebben de Q4-prognose nodig, [gelach], voor vrijdag.” | “We hebben de Q4-prognose nodig, [gelach], voor vrijdag.” | Non-verbale markering behouden |
| “Spreker A, um, kun je het sturen?” | “Spreker A, kun je het sturen?” | Vulwoord verwijderd, label behouden |
De grens van het opschonen is makkelijker te bewaken als je bedenkt dat interpunctie gecorrigeerd mag worden, maar dat de stem niet herschreven hoort te worden. Een gebroken zin kan leesbaar worden gemaakt, maar mag ineens niet klinken alsof iemand anders hem heeft geschreven. Als de oorspronkelijke spreker nonchalant, behoedzaam of onzeker klonk, moet het opgeschoonde transcript nog steeds zo aanvoelen.
Tijdstempels en sprekerlabels moeten ook consistent zijn. Eén richtlijn voor schoon verbatim adviseert om bij elke sprekerswisseling een tijdstempel toe te voegen, wat luisteraars helpt om snel terug in de opname te springen. Een andere transcriptiegids suggereert tijdstempels elke 30 tot 60 seconden voor de meeste interviews, maar het kernpunt is hetzelfde: tijdstempels zijn er om verificatie te ondersteunen, niet om de pagina te versieren (richtlijnen voor tijdstempels).
Voor een praktische workflow voor het bewerken is Clean transcript relevant, want het weerspiegelt hetzelfde idee: rommel verwijderen, betekenis behouden, de timingstructuur bewaren.
De test met één regel
Als het verwijderen van een woord de zekerheid, beklemtoning of bedoeling van de spreker verandert, blijft het staan. Dat is de hele test in één regel. Het weerhoudt een beginnende transcriptionist ervan om het transcript te “verbeteren” tot iets dat veiliger leest maar minder trouw is aan het oorspronkelijke gesprek.
Kiezen tussen schoon, bewerkt en intelligent verbatim
De juiste stijl hangt af van wie het leest en wat diegene ermee doet. Een schoon transcript past het beste wanneer de tekst geciteerd, doorzocht, gecodeerd of gearchiveerd wordt. Een bewerkt transcript gaat verder en leest meer als gepolijst schrijfwerk, terwijl intelligent verbatim tussen die twee in zit: het verzacht wat ruwe randjes zonder de spraak volledig te herschrijven.
| Criteria | Schoon verbatim | Bewerkt transcript | Intelligent verbatim |
|---|---|---|---|
| Leesbaarheid | Hoog | Zeer hoog | Hoog |
| Trouw aan de spraak | Hoog | Matig | Matig tot hoog |
| Typisch gebruik | Onderzoek, archieven, ondertitels | Artikelen, samenvattingen, publicatieklare tekst | Vergaderingen, webinars, interne samenvattingen |
| Geschikt voor vervolggebruik | Sterk voor citeren en analyse | Sterk voor gepolijst lezen | Sterk voor algemeen delen |
| Niveau van opschonen | Licht | Zwaarder | Tussenweg |
De beslisregel is eenvoudig. Als het transcript geciteerd of geanalyseerd kan worden, blijf dan dicht bij clean verbatim. Als het publiek alleen een vloeiend verhaal nodig heeft, ga dan richting edited. Als de klus er tussenin zit, is intelligent verbatim meestal de juiste keuze.
Een nuttig voorbeeld is vergadermateriaal. Een team wil misschien exacte besluiten, verantwoordelijken en toezeggingen, maar niet elke aarzeling in de ruimte. In dat geval kan intelligent verbatim goed werken, terwijl een onderzoeksinterview over gebruikersgedrag meestal de strakkere betrouwbaarheid van clean verbatim nodig heeft. Voor teams die workflowopties vergelijken, is deze pagina over notulen maken met AI een praktisch referentiepunt, omdat die in hetzelfde toepassingsgebied zit.
Een snel selectiefilter
Stel jezelf drie vragen voordat je begint.
- Gaat iemand dit citeren? Zo ja, blijf dan dichter bij clean verbatim.
- Gaat iemand dit als een document scannen? Zo ja, is edited misschien beter.
- Wordt dit gebruikt voor analyse of bewijs? Zo ja, bewaar dan meer van de oorspronkelijke spraak.
Die keuze bespaart later tijd. Een transcript dat vanaf het begin bij het gebruik past, heeft aan het eind meestal minder herwerk nodig.
Een praktische AI-ondersteunde opruimworkflow
Een ruw transcript is slechts een beginpunt. AI kan snel een concept maken, maar de eerste versie wisselt nog steeds met het accent van de spreker, de opnamekwaliteit en het soort inhoud dat wordt vastgelegd. Een onderzoeksstudie vond dat Whisper 72.5% perfecte of bijna perfecte transcripten opleverde, 22.3% met kleine afwijkingen of lichte fouten, en 5.2% met onvoldoende kwaliteit of grote fouten, terwijl de API van Google 36.7%, 43.3% en 20.0% in dezelfde categorieën liet zien. Die resultaten verklaren de afweging die clean verbatim van je vraagt: bewaar genoeg van de oorspronkelijke spraak om de betekenis te behouden, en schrap daarna alleen de ruis die het lezen moeilijker maakt.
Een controlecyclus in zes stappen
- Upload de bronaudio met sprekersdiarizatie ingeschakeld. Sprekersscheiding geeft je een schonere basis voordat de tekstopschoning begint.
- Genereer een bijna-clean verbatim concept, niet volledig verbatim. Die eerste versie moet lezen als een werkversie, niet als een gerechtelijk verslag.
- Controleer eigennamen, domeintermen en meertalige segmenten. AI vlakt namen en termen die ertoe doen vaak af.
- Pas de opschoonregels alinea voor alinea toe. Behandel elk blok op dezelfde manier, zodat het transcript een gelijkmatige stem houdt.
- Controleer tijdstempels met de audio-scrubber bij segmenten met weinig zekerheid. Als de uitvoer onzeker lijkt, bepaalt de opname wat blijft.
- Exporteer in twee formaten, één voor media en één voor analyse. Een .srt- of .vtt-bestand met tijdstempels werkt voor ondertitels, terwijl een schoon .docx- of .md-bestand makkelijker is voor review en codering.
{% youtube id="GNc6uJk3dP0" /%}
Als snelheid deel uitmaakt van de workflow, past deze gids over het stroomlijnen van de verwerkingssnelheid van AI goed naast de transcriptiestap. Snellere verwerking helpt alleen als de reviewstap gedisciplineerd blijft.
Laatste controles voor de export
- Sprekerslabels zijn consistent.
- De woordenlijst komt overeen met de projecttermen.
- De hardop-leesronde klinkt nog steeds als de oorspronkelijke spreker.
- Tijdstempels kloppen waar de opname van onderwerp of spreker wisselt.
Een sterke AI-ondersteunde workflow haalt het oordeel niet weg. Die geeft je een beter concept en laat je daarna je aandacht besteden waar die het meest telt.
Waar opschonen riskant of verkeerd wordt
Schoner is niet altijd beter. In sommige contexten haalt het verwijderen van aarzeling of herstarts betekenis weg die lezers nodig hebben. Daarom moet clean verbatim als standaard worden gezien, niet als doctrine.
In kwalitatief onderzoek kan een pauze duiden op reflectie, ongemak of onzekerheid. Als de interviewer bestudeert hoe mensen beslissingen nemen, kunnen die pauzes net zo belangrijk zijn als de woorden eromheen. In juridische en verklaringscontexten kan elke uiting op intentie worden onderzocht, dus te veel bewerken kan meer risico dan duidelijkheid opleveren. In onderzoeksjournalistiek kan een verspreking of zelfcorrectie deel uitmaken van wat een citaat relevant maakt.
Als het verwijderen van een woord verandert wat de lezer denkt over de gemoedstoestand van de spreker, laat het woord dan staan.
Dat principe komt ook terug in richtlijnen over clean verbatim en bewerkte transcripten, die waarschuwen tegen parafraseren, verkeerde toeschrijving of het wegsnijden van betekenisvolle dialoog. Een nuttige herinnering voor publicaties met veel op het spel is dat het transcript het verslag moet bewaren, niet alleen de schijn van verzorgdheid (richtlijnen clean vs edited).
Dezelfde voorzichtigheid komt terug in een andere referentie over het verschil tussen verbatim en clean verbatim, waar strikte nauwkeurigheid belangrijker is in juridische procedures en situaties waarin exacte details vereist zijn (verbatim en clean verbatim vergelijking). In zulke situaties kan een ontbrekende aarzeling of een verzachte onderbreking veranderen hoe een uitspraak later wordt geïnterpreteerd.
Voor bestanden die gevoelig zijn voor citaten of rechten is deze bron over copyrightclaims relevant, omdat die dicht bij dezelfde vraag staat: hoeveel aanpassing is nog trouw aan de bron. Het antwoord hangt af van het gebruiksscenario, niet van een universele opschoonregel.
Een checklist vóór export en beslissingsregels
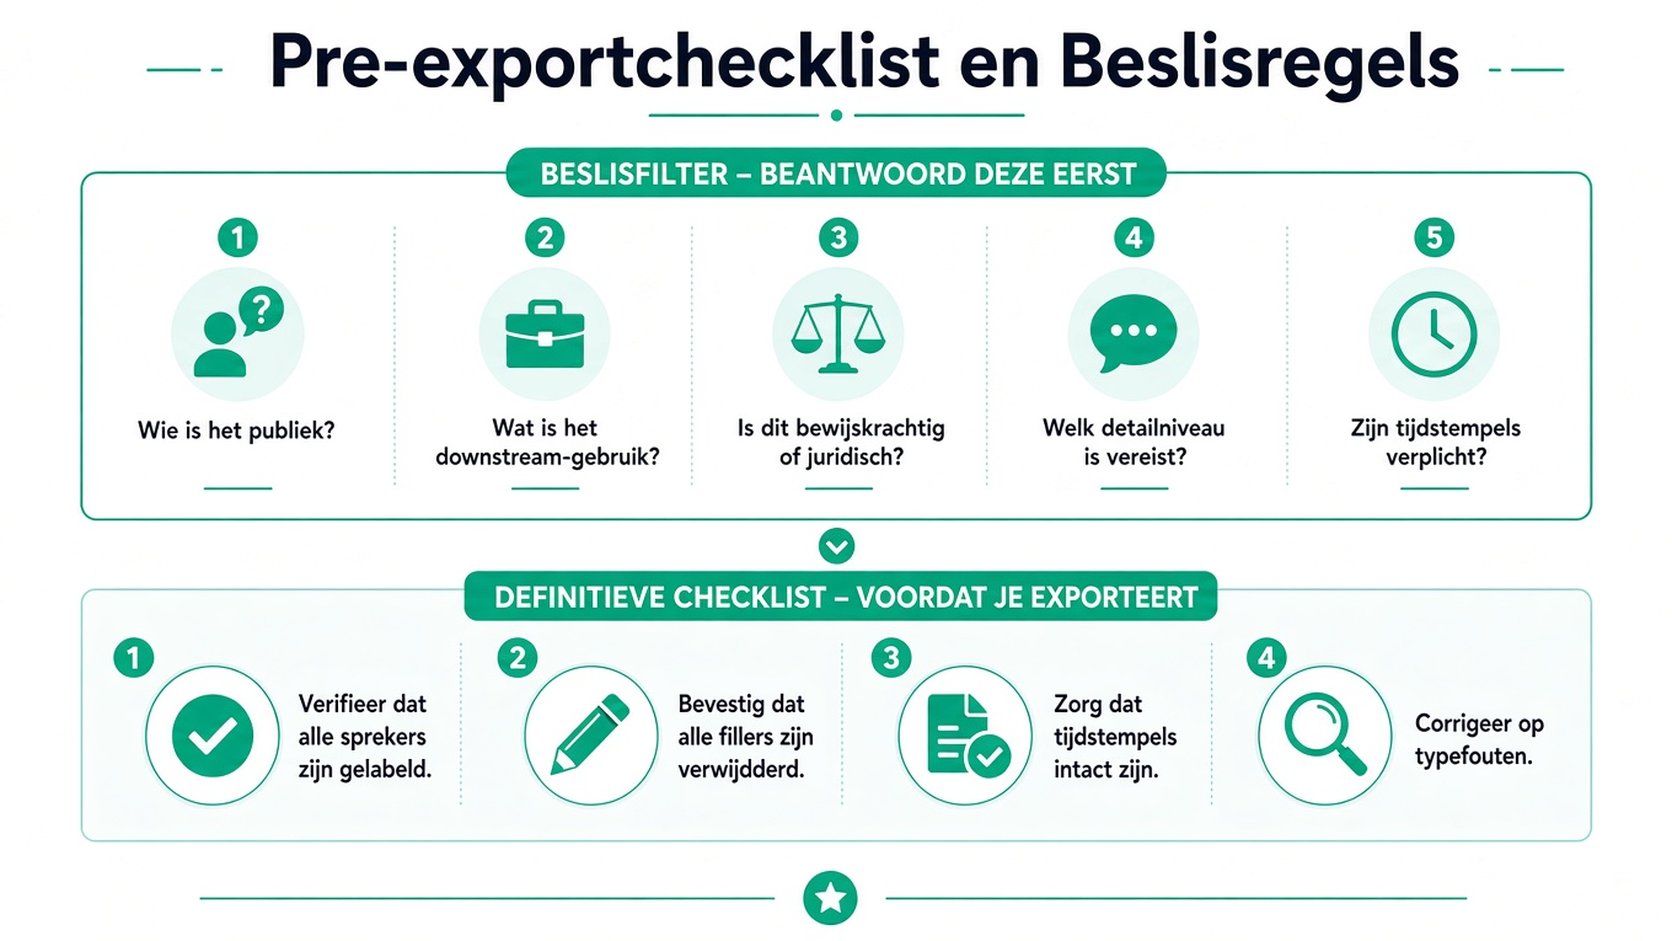
Voordat je iets opslaat, stel je vijf vragen. Wie is het publiek? Wat is het latere gebruik? Is dit bewijsmateriaal of juridisch? Hoeveel detail is nodig? Zijn tijdstempels verplicht? Die antwoorden bepalen of clean verbatim geschikt is, of dat je meer van de oorspronkelijke spraak moet bewaren.
Inhoudelijke integriteit
- Zijn alle sprekers consistent gelabeld?
- Zijn eigennamen gespeld zoals het projectwoordenboek voorschrijft?
- Zijn getallen, datums en technische termen bewaard zoals ze zijn uitgesproken?
- Blijven niet-Engelse termen intact, tenzij de workflow vertaling vereist?
Structurele integriteit
- Sluiten de tijdstempels aan bij sprekerswisselingen of het gekozen interval?
- Staan alinea-einden daar waar het onderwerp verandert, niet willekeurig?
- Zijn koppen of sprekerstags overal op dezelfde manier opgemaakt?
- Leest het transcript nog steeds als één samenhangend gesprek?
Opmaakintegriteit
- Wordt het bestand geëxporteerd in het formaat dat het publiek nodig heeft?
- Ondersteunt het leveringskanaal de gekozen tijdstempelstijl?
- Is de naamgevingsconventie duidelijk genoeg om versieverwarring te voorkomen?
- Zijn de toegangsinstellingen of deelopties correct voordat je verstuurt?
Voor ondertitelwerk en hergebruik van video past de YouTube subtitle generator natuurlijk in dezelfde beslisflow, omdat de opmaak van ondertitels afhangt van timing en leesbaarheid die samenwerken. Clean verbatim helpt daar, maar alleen wanneer de export overeenkomt met het uiteindelijke platform.
Clean verbatim is een serviceniveau, geen kwaliteitskeurmerk. Het doel is niet de soepelst mogelijke tekst, maar de exacte vorm van leesbaarheid die de taak vereist. Als het transcript gelezen, geciteerd, beoordeeld of gepubliceerd wordt, is de juiste mate van opschonen de mate die de betekenis behoudt en alleen de ruis verwijdert.
Als je een transcriptieworkflow wilt die de betekenis intact houdt en de tekst tegelijk makkelijker bruikbaar maakt, ga dan naar Transcriberen met transcript.im en probeer het bij je volgende interview, vergadering of videobestand. Het is gebouwd om spraak om te zetten in schone, van tijdstempels voorziene tekst, zodat je van ruwe audio naar een leesbaar transcript gaat zonder de structuur te verliezen die je nog nodig hebt.
Transcriberen
Zet elke video om in tekst
Plak een YouTube-, TikTok- of Instagram-link en lees het transcript, met tijdstempels op elke regel.
Exporteert als TXT, SRT of VTT.