
REST API
Transcript API voor video en audio
transcript.im biedt dezelfde extractiepijplijn die het product aandrijft aan als een transcript API met versiebeheer. Stuur een video- of audio-URL en ontvang tekst met tijdstempels terug, in JSON of platte tekst, waarbij het platform voor je wordt gedetecteerd. Bestaande ondertitels worden eerst gebruikt; heeft een video die niet, dan transcribeert AI de audio en wordt het resultaat asynchroon geleverd.
- Eén
urlaccepteert een volledige of verkorte link en detecteert YouTube, TikTok, Instagram, LinkedIn en Twitter/X; voor YouTube wordt ook een kaal video-id herkend, enplatformplusexternalIddekken een bron die je al kent. - Ondertitels worden eerst gebruikt; AI transcribeert de gesproken audio wanneer een video die niet heeft, en een upload van een lokaal bestand gaat altijd naar spraakherkenning.
format=jsongeeft segmenten met tijdstempels terug, terwijlformat=textplatte tekst teruggeeft die klaar is om te plakken.- Batch-extractie dekt URL-lijsten, playlists en kanalen.
- Batch-exports dekken txt, csv, json, srt, vtt en zip; een opgeslagen transcript download je als txt, srt, vtt, json of md.
- Opgeslagen transcripts staan in de Library van je account, en YouTube-discovery dekt zoeken, video's, kanalen, uploads, playlists en ondertitels.
- Het volledige contract is gepubliceerd als een OpenAPI-document.
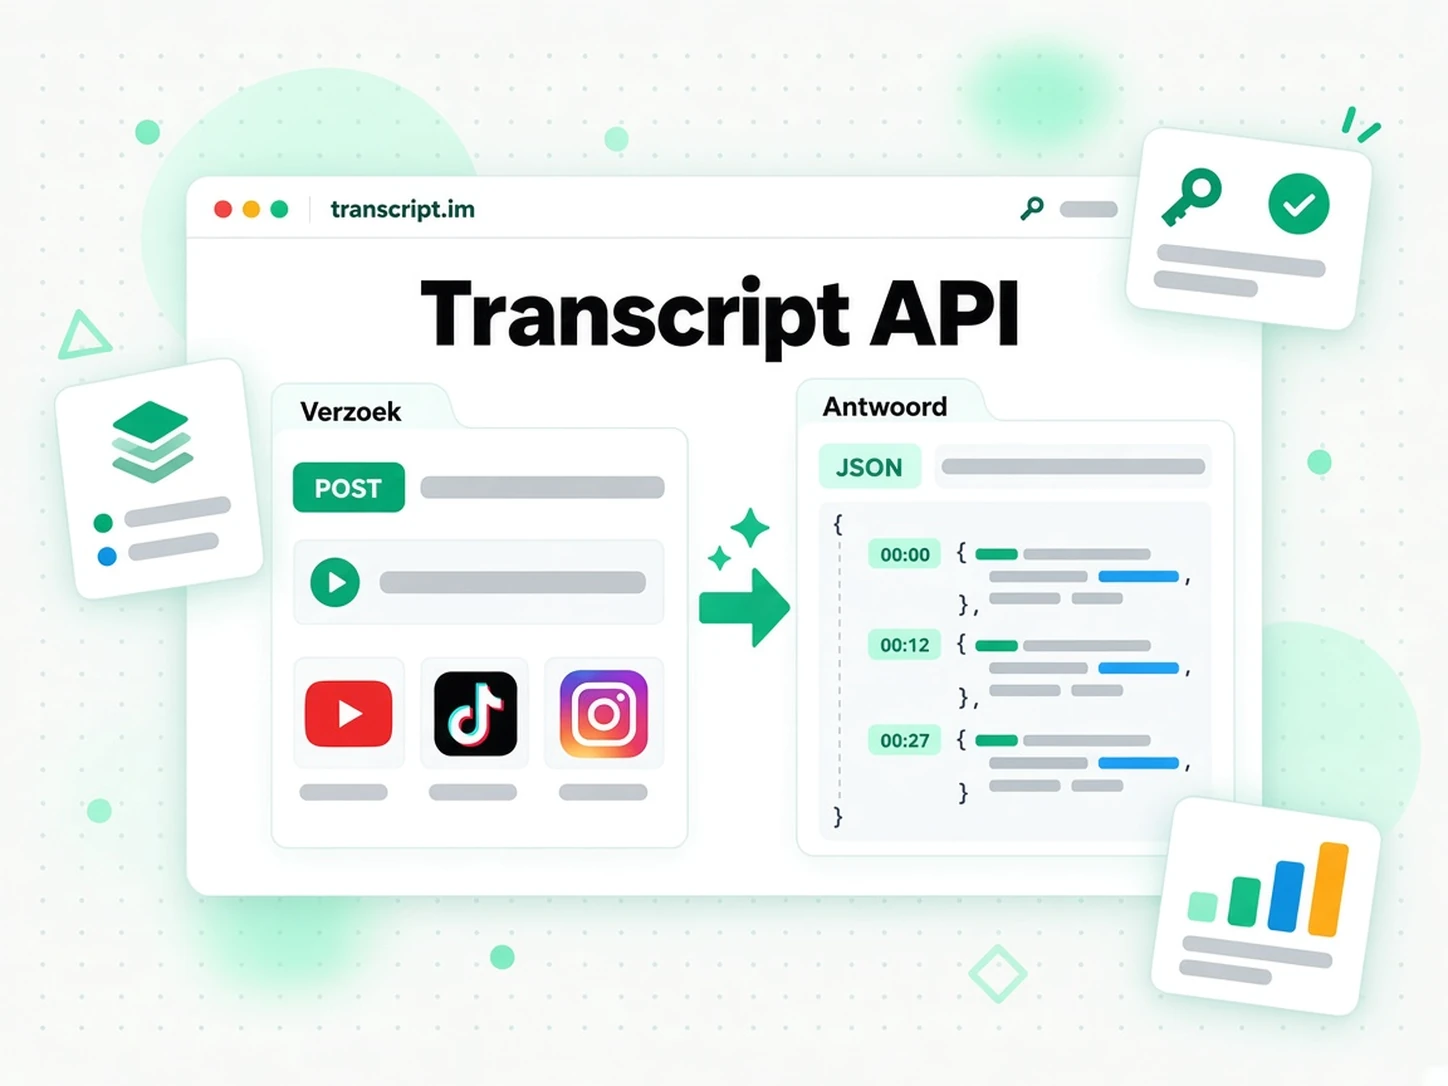
Wat de transcript.im API doet
De transcript.im API verandert een openbare video- of audiolink in een transcript met tijdstempels dat je product kan lezen, opslaan, doorzoeken of aan een model kan voeren. Je stuurt een URL; de API bepaalt het platform, zoekt naar de bestaande ondertiteltrack van de maker en geeft de geschreven tekst terug met een tijdstempel op elke regel. Heeft een video helemaal geen ondertitels, dan stopt de API niet bij een fout — hij valt terug op AI-transcriptie van de gesproken audio, zodat hetzelfde verzoek alsnog tekst oplevert.
- Eén verzoek, echte tekst — los een link op en krijg transcriptsegmenten met tijdstempels of platte tekst terug.
- Eerst ondertitels, dan AI — gebruik de track van de maker als die bestaat, transcribeer de audio als dat niet zo is.
- Standaard async voor ASR — met een job-id kun je een lange transcriptie pollen zonder te blokkeren.
- Taalbewust — geef een taalprioriteit op en lees de taal terug die de API heeft bepaald.
- Platformonafhankelijk — de aanroeper hoeft niet te weten waar de video wordt gehost.
Eén transcript-API voor vijf platforms
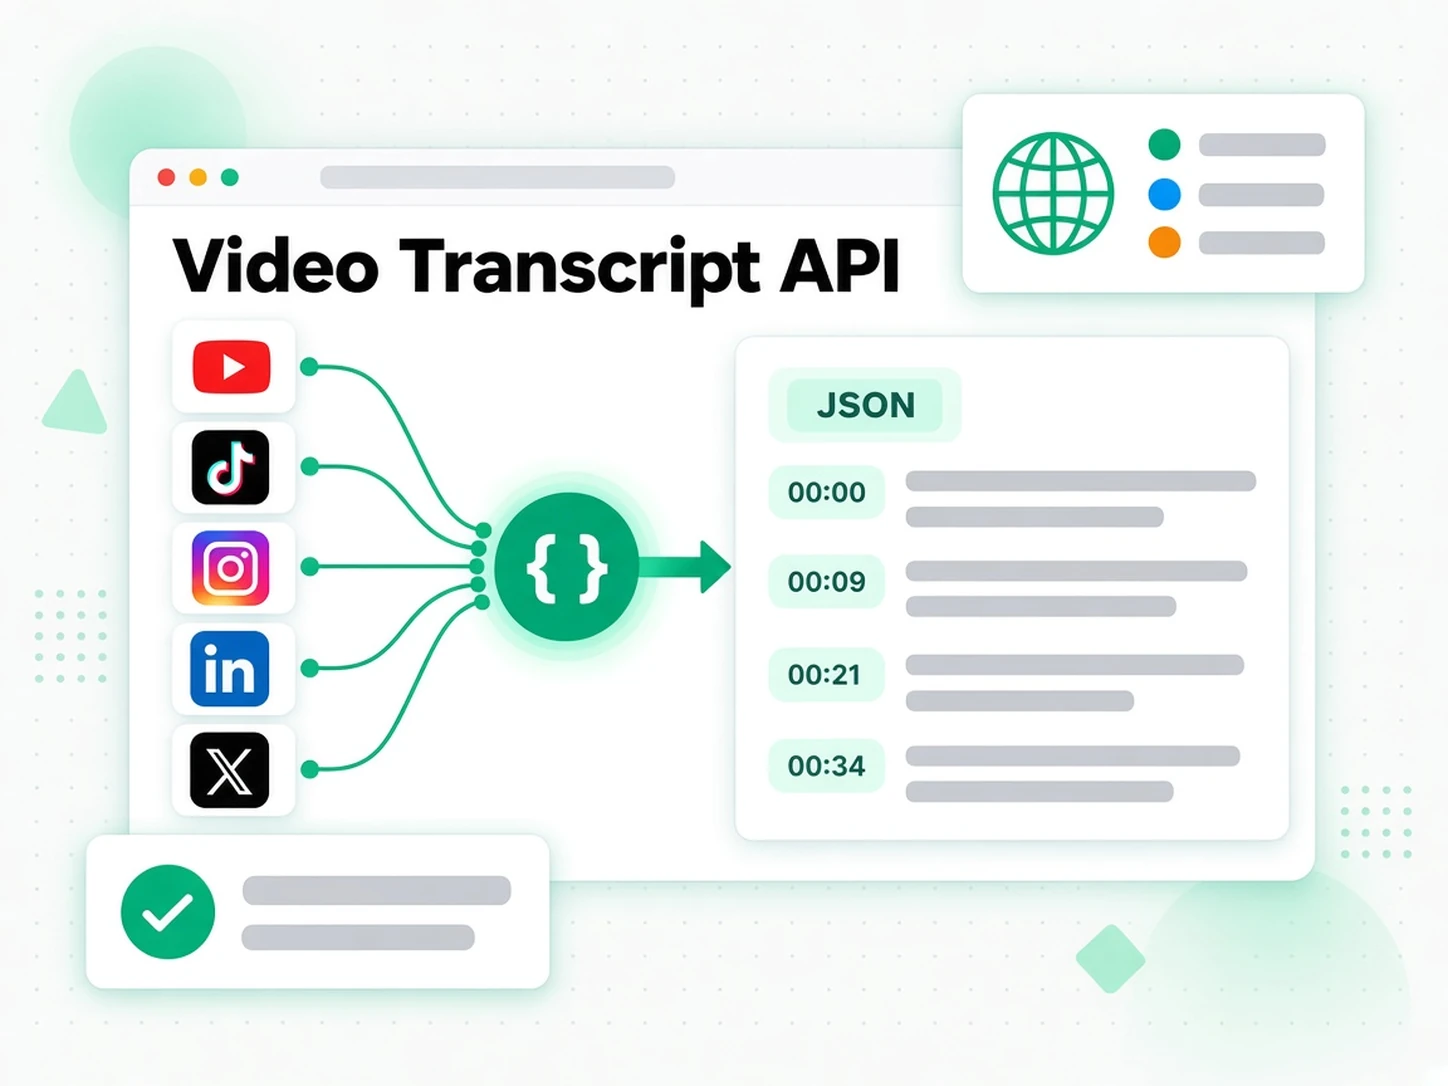
YouTube
Transcripten voor elke openbare YouTube-video, Short of live-opname, waarbij eerst de ondertitels van de maker worden gebruikt en AI-transcriptie als ondertitels ontbreken. YouTube is ook het platform met een volledig discovery-oppervlak — zoeken, video's, kanalen, uploads, playlists en ondertitels — beschikbaar naast het transcript zelf. Een kanaalbacklog of een playlist wordt een batch transcripten met tijdstempels, terwijl een enkele link terugkomt als leesbare, doorzoekbare tekst.
TikTok
Transcripten voor openbare TikTok-video's, waarbij ondertitels eerst worden gebruikt en spraakherkenning als terugvaloptie dient. Plak een videolink en lees de gesproken inhoud als schone tekst met tijdstempels die je kunt hergebruiken, vertalen of citeren. Dezelfde aanroep dekt zowel een korte clip als een langere upload, dus een trend, een tutorial en een talking-head-post komen allemaal als tekst terug.
Transcripten voor openbare Instagram Reels en videoposts. Instagram heeft geen ondertiteltrack om te lezen, dus extractie verloopt via asynchrone spraakherkenning: dien de link in, poll de taak en haal de tekst op zodra die klaar is. Zo wordt een Reel citeerbaar en doorzoekbaar, ook al heeft het platform de woorden nooit als tekst gepubliceerd.
Transcripten voor openbare LinkedIn-videoposts, waarbij ondertitels eerst worden gebruikt en spraakherkenning als terugvaloptie dient. Het resultaat komt terug met tijdstempels, dus een talk, een productclip of een opgenomen vergadering wordt doorzoekbare tekst die je kunt citeren en hergebruiken. Haal het betoog uit een webinaropname, of zet een update van een oprichter om in een concept dat je kunt bewerken.
Twitter/X
Transcripten voor openbare X-videoposts. X heeft geen ondertiteltrack om te lezen, dus extractie verloopt via asynchrone spraakherkenning: dien de link in, poll de taak en verzamel tekst met tijdstempels die je kunt doorzoeken. Citeer een video nauwkeurig, of archiveer de gesproken inhoud voordat de post wordt bewerkt of verwijderd.
Hoe een transcriptverzoek verloopt
Eén aanroep brengt een link of een geüpload bestand van invoer naar transcript, en de API vertelt je welk pad is gevolgd.
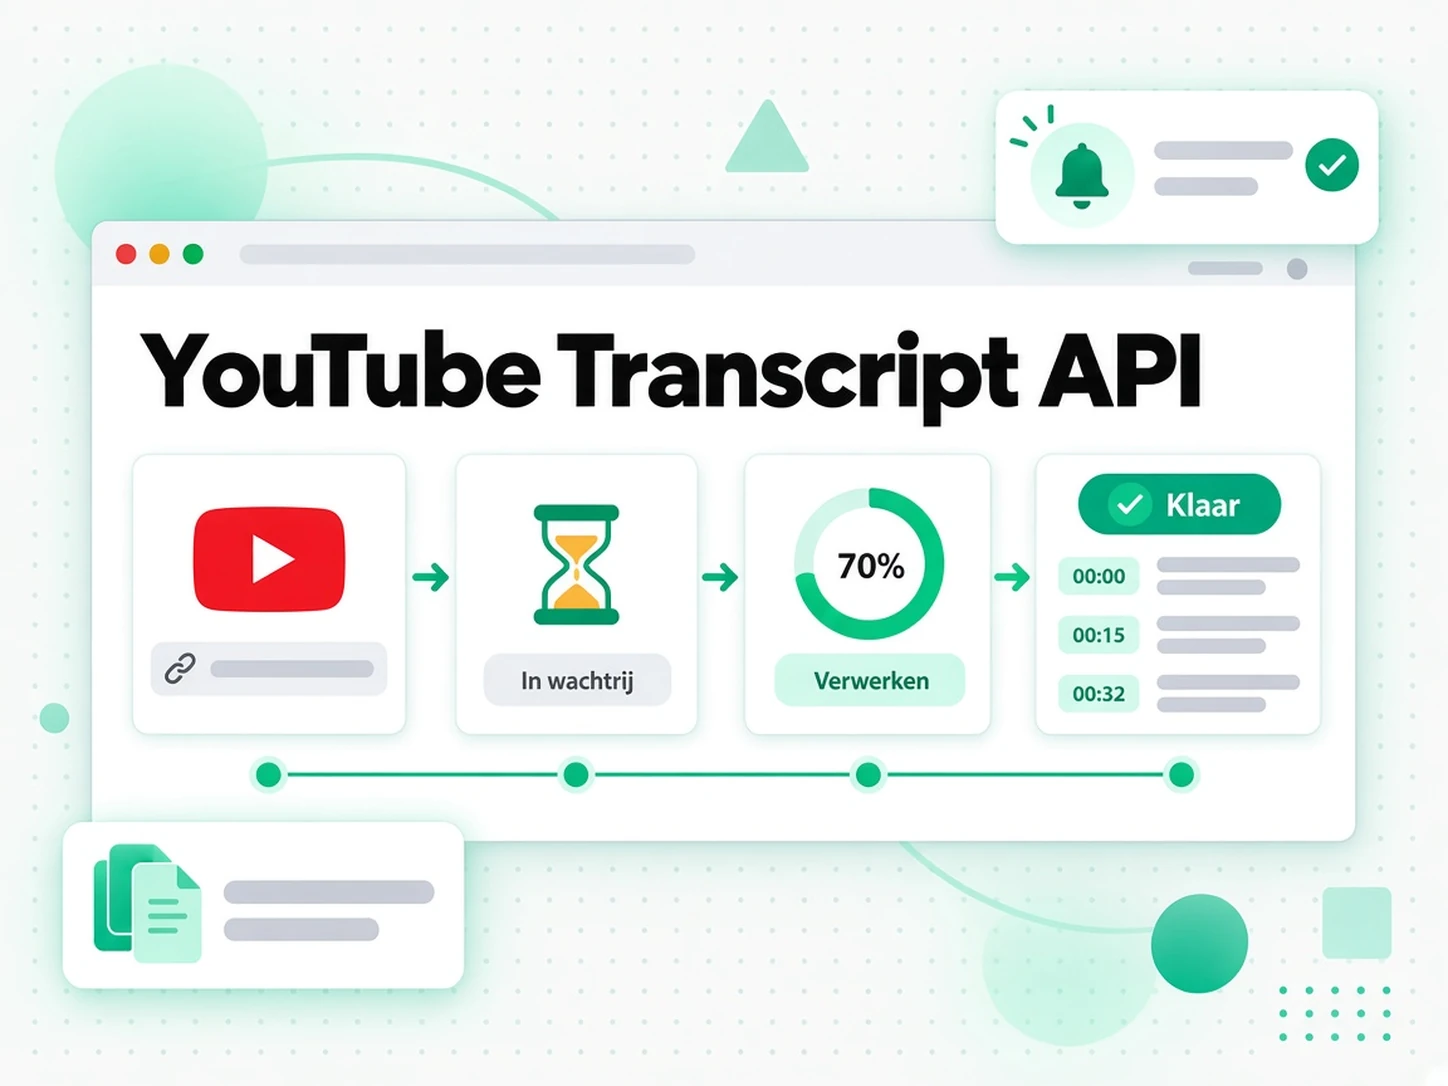
- Stuur de bron — post een
url, geefplatformenexternalIdmee als je ze al kent, of upload een bestand alsmultipart/form-datanaar hetzelfde endpoint. - Krijg een ondertitelmatch — als de video ondertitels heeft in een taal op jouw lijst, komt het transcript direct in het antwoord terug.
- Vang een taalmismatch op — bestaan er wel ondertitels maar past geen enkele bij jouw lijst, dan gaat het verzoek verder naar AI-transcriptie en krijg je
202met een job-id; een404metavailableLanguageskomt alleen terug als spraakherkenning niet is toegestaan voor de aanroeper. - Forceer ASR of val erop terug — een expliciete
asr-vermelding, een video zonder enkele ondertiteltrack of een geüpload bestand start een ASR-taak en geeft een job-id terug. - Poll of stream — lees de taak met
GET /v1/transcript/job/{id}tot die slaagt of mislukt, of abonneer je op de/events-stream voor server-sent voortgang. Een taakquery geeft200, zelfs bij een mislukte taak, dus vertak op het veldstatus. - Lees het resultaat — een afgerond transcript bevat de bepaalde taal, lengte, segmenten met tijdstempels en, indien opgevraagd, metadata zoals titel, auteur en publicatiedatum.
- Herhaal veilig — een transcript dat al is geëxtraheerd, wordt uit de cache geleverd in plaats van een nieuwe taak te starten, zodat dezelfde bron opnieuw kan worden opgevraagd.
- Inspecteer eerst —
GET /v1/transcript/infolost een bron op en somt de talen op die het kan leveren voordat je een extractie start.
202 met een job-id, en een echt ontbrekend bestand of een niet-toegestane terugval geeft 404. Elk pad levert dezelfde transcriptvorm zodra de tekst klaar is.Batch-extractie en exports
Echte workloads stoppen zelden bij één video, dus accepteert de API een batch als URL-lijst, playlist of kanaal. Elke batch houdt zijn eigen totalen bij — hoeveel items in behandeling zijn, hoeveel er zijn geslaagd en hoeveel er zijn mislukt — en levert items pagina voor pagina, zodat een lang kanaal niet als één enorm pakket binnenkomt.
- Drie batchvormen —
POST /v1/batchaccepteert een lijst URL's, een playlist of een kanaal, bepaald door de body die je stuurt. - Onafhankelijke status — een mislukte link wordt apart gemarkeerd en gooit nooit de rest van de batch weg; mislukte items kunnen opnieuw worden geprobeerd met
/retry. - Gepagineerde items — lees de batch met
GET /v1/batch/{batchId}en volg daarna de teruggegeven paginatoken voor de resterende items. - Live voortgang — elke poll geeft bijgewerkte aantallen terug, zodat een aanroeper kan tonen hoeveel van een lange run klaar is.
- Exporteer in jouw formaat — download een afgeronde batch via
/exportalstxt,csv,json,srt,vttofzip.
srt- en vtt-exports direct in een editor of speler. Voor een archief houden csv, json en zip een hele bibliotheek met opnames doorzoekbaar als één corpus. De formaten sluiten aan op de antwoorden voor één transcript, dus een consumer die één resultaat aankan, weet al hoe die een batch moet lezen.Opgeslagen transcripten in de accountbibliotheek
Extractie en opslag staan los van elkaar: een transcript wordt onderdeel van de accountbibliotheek zodra het is opgeslagen, en in de bibliotheek kun je het later lezen, doorzoeken, downloaden en verwijderen zonder de extractie opnieuw uit te voeren.
- Toon opgeslagen inhoud —
GET /v1/library/transcriptsbladert door de transcripten, batchrecords en mislukte-geschiedenisregels van het account, met zoeken, platform- en taalfilters en sortering. - Lees één item —
GET /v1/library/transcripts/{platform}/{externalId}geeft een opgeslagen transcript terug op basis van platform en external id, of voor de taal die je opgeeft. - Downloaden — de route
/downloadexporteert een opgeslagen transcript alstxt,srt,vtt,jsonofmd. - Gerelateerde inhoud — de route
/relatedsomt andere opgeslagen items van hetzelfde kanaal op. - Verwijderen —
DELETEhaalt een item uit de bibliotheek zonder andermans kopie aan te raken. - Leesacties binnen het account — een bibliotheekverzoek geeft alleen terug wat het account heeft opgeslagen en start nooit een nieuwe extractie, dus een opgeslagen transcript opnieuw bezoeken is een leesactie, geen nieuwe taak.
YouTube Discovery verder dan transcripten
YouTube is het platform waar de API ook de vragen rond een transcript beantwoordt, met dezelfde resourcenamen als de YouTube Data API.
- Zoeken —
GET /v1/youtube/searchvindt video's, kanalen of playlists op query en geeft met cursor gepagineerde resultaten terug. - Video's —
GET /v1/youtube/videosgeeft details van een video terug, waaronder of ondertitels beschikbaar zijn. - Kanalen —
GET /v1/youtube/channelslost een kanaal op via id of@handle. - Kanaaluploads —
GET /v1/youtube/channels/{channelId}/videosdoorloopt de uploads van een kanaal. - Playlistitems —
GET /v1/youtube/playlists/{playlistId}/itemsdoorloopt een playlist. - Ondertitels —
GET /v1/youtube/captionsgeeft de metadata van de ondertiteltrack en de ondertiteltekst van een video terug. Het start nooit een spraakherkenningstaak: meldt hetrequiresAsync, roep danPOST /v1/transcriptaan om de transcriptie uit te voeren.
Gebouwd voor productiegebruik
Het oppervlak is bewust klein, en de onderdelen die voor een service belangrijk zijn, zijn gedocumenteerd in plaats van geraden.
- Eén credential — authenticeer met een API key die als Bearer token wordt verzonden, of met
X-API-Keyvanuit een script of server. - Scoped keys — verleen alleen de scopes die een aanroeper nodig heeft, waarbij
transcriptsenbatchesextractie en batchwerk dekken. - Gestructureerde fouten — fouten bij extractie en validatie retourneren een foutobject met een stabiele
codeen een leesbaremessage; authenticatie (401) en rate-limit (429) responses gebruiken een eenvoudiger platte foutbody. - Bruikbare limieten — een rate-limited request retourneert
429metRetry-After, en succesvolle responses bevattenX-RateLimit-*headers zodat een client correct kan backoffen. - Een gepubliceerd contract — het volledige OpenAPI-document onderbouwt de API, zodat je een client kunt genereren, een server kunt mocken of echte responses kunt valideren tegen het schema.
- Een tegenhanger voor agents — hetzelfde account en dezelfde tools zijn bereikbaar via de transcript.im MCP server als jouw aanroeper een AI-client is in plaats van een service.
Gerelateerd
FAQ's over de Transcript API
Wat is de transcript.im API?
De transcript.im API is een REST-interface die een openbare video- of audiolink omzet in een transcript met tijdstempels, waarbij eerst bestaande ondertitels worden gebruikt en AI-transcriptie wanneer een video er geen heeft.
Welke platforms ondersteunt de transcript.im API?
Het haalt transcripts op van YouTube, TikTok, Instagram, LinkedIn en Twitter/X door het platform te herkennen aan de link die je verstuurt. YouTube, TikTok en LinkedIn gebruiken eerst ondertitels met spraakherkenning als terugvaloptie; Instagram en X hebben geen ondertitelspoor en gaan direct naar spraakherkenning.
Wat gebeurt er als een video geen ondertitels heeft?
Als een video helemaal geen ondertitelspoor heeft, start de API een ASR-taak en retourneert een job-id; je pollt die taak tot het transcript klaar is, zodat het request nooit blokkeert op spraakherkenning.
Kan ik een lokaal audio- of videobestand transcriberen?
Ja. POST /v1/transcript accepteert een multipart/form-data-body met een file-deel in plaats van een URL. Een geüpload bestand gaat direct naar spraakherkenning, dus het retourneert een 202-taak — of een 200-resultaat als het binnen het wachtbudget klaar is.
Kan de transcript.im API tijdstempels bij de tekst retourneren?
Ja. JSON-responses bevatten segmenten met tijdstempels en tekstresponses kunnen per regel een tijdstempel-voorvoegsel behouden, zodat je terug kunt springen naar het moment waarop een regel werd uitgesproken.
Hoe vraag ik een transcript in een specifieke taal aan?
Stuur een kommagescheiden prioriteitenlijst van talen, inclusief asr- en asr-<code>-vermeldingen. Een overeenkomst met ondertitels wordt direct geretourneerd; als er ondertitels bestaan maar geen enkele overeenkomt met de lijst, gaat het request verder naar AI-transcriptie en retourneert een 202-taak, en een 404 met de beschikbare talen wordt alleen geretourneerd wanneer spraakherkenning niet is toegestaan.
Hoe weet ik wanneer een asynchroon transcript klaar is?
Poll GET /v1/transcript/job/{id} met dezelfde credential tot deze success of failed meldt, of abonneer je op GET /v1/transcript/job/{id}/events voor server-sent updates. Een jobquery retourneert 200, zelfs als de taak is mislukt, dus lees de velden status en error in plaats van de HTTP-code.
Ondersteunt de transcript.im API batch-extractie?
Ja. Een batch accepteert een lijst met URL's, een afspeellijst of een kanaal, houdt de status van elk item bij en retourneert items pagina per pagina.
Welke exportformaten kan ik downloaden?
Een voltooide batch exporteert als txt, csv, json, srt, vtt of zip; een enkel opgeslagen transcript downloadt als txt, srt, vtt, json of md.
Waar staan opgeslagen transcripts?
De Library van het account is waar opgeslagen transcripts en batchrecords staan, onder /v1/library. Het biedt routes voor list, read, download, related en delete, en de reads zijn beperkt tot het account en starten nooit een nieuwe extractie.
Wat retourneert het YouTube-ondertitelendpoint?
GET /v1/youtube/captions retourneert de metadata van het ondertitelspoor van een video samen met de ondertiteltekst. Het start nooit een spraakherkenningstaak; wanneer het requiresAsync meldt, roep dan POST /v1/transcript aan om de transcriptie uit te voeren.
Hoe rapporteert de transcript.im API fouten en rate limits?
Fouten bij extractie en validatie gebruiken een object met een code en message; authenticatie retourneert een platte 401, en rate limiting retourneert een platte 429 met Retry-After plus X-RateLimit-* headers zodat een client correct kan backoffen.
Voeg transcripts toe aan je product
Maak een API key aan, stuur een videolink of een lokaal bestand en lees het transcript terug als JSON of platte tekst.