
REST API
API bản chép lời cho video và âm thanh
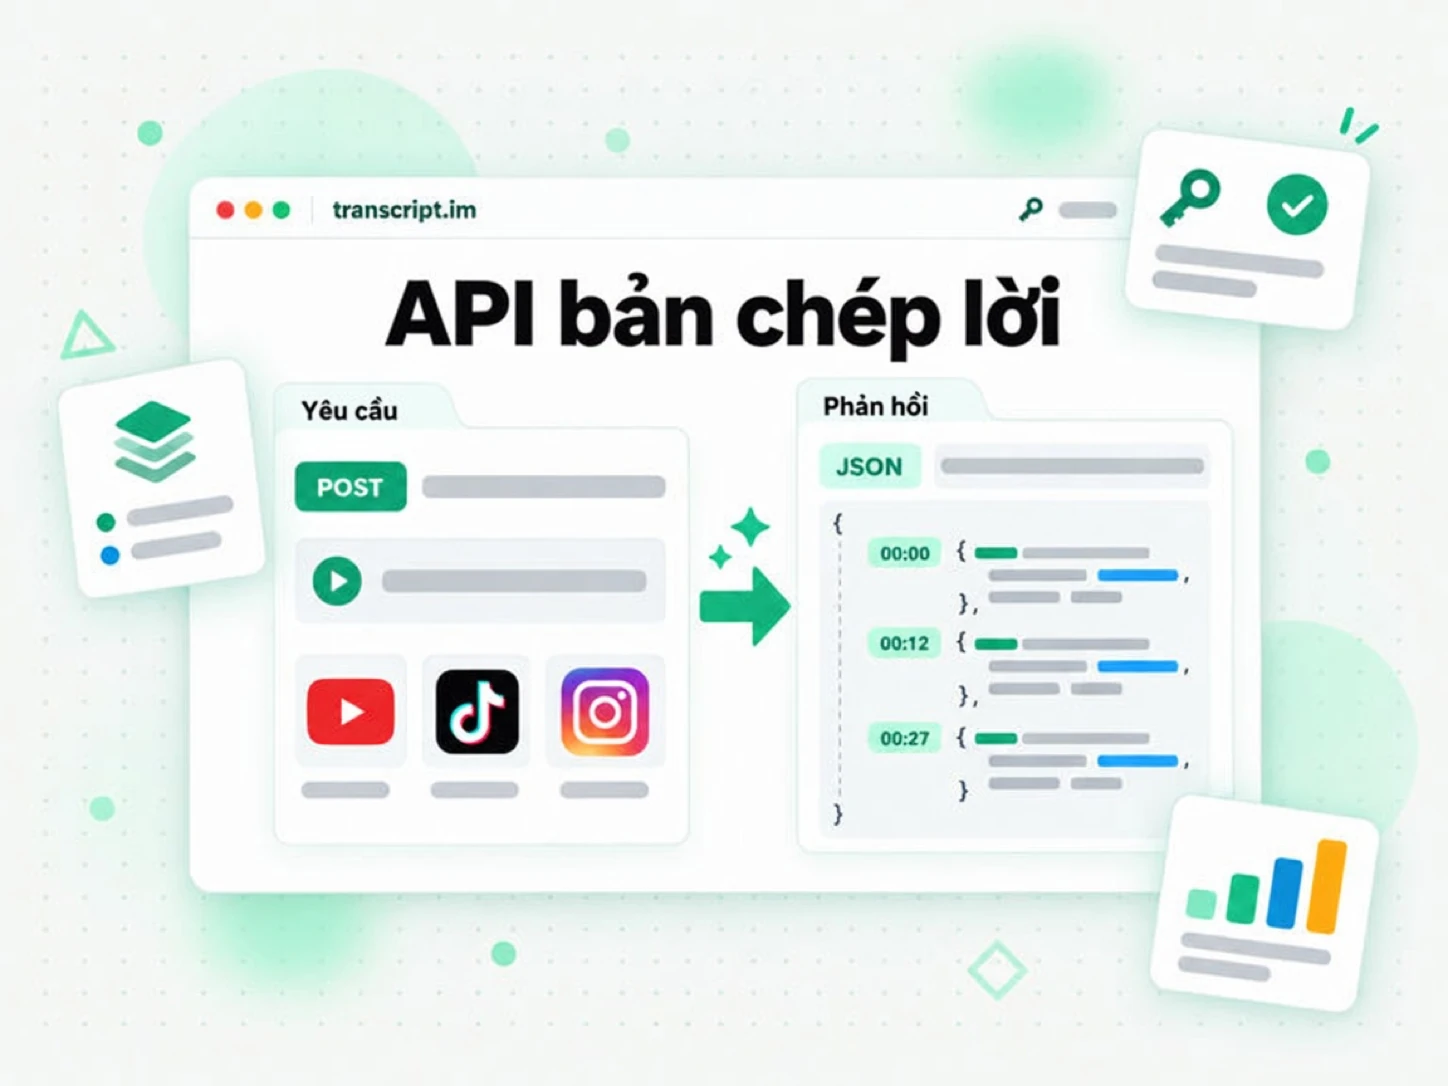
transcript.im mở ra dưới dạng API có phiên bản chính quy trình trích xuất đang vận hành sản phẩm. Gửi URL video hoặc âm thanh và nhận lại văn bản có dấu thời gian, ở dạng JSON hoặc văn bản thuần, với nền tảng được nhận diện tự động. Phụ đề sẵn có được dùng trước; khi video không có phụ đề, AI sẽ chép lời âm thanh và kết quả được trả về theo cách bất đồng bộ.
- Một
urlnhận cả liên kết đầy đủ lẫn liên kết rút gọn và nhận diện YouTube, TikTok, Instagram, LinkedIn và Twitter/X; với YouTube, id video trần cũng được nhận diện, và khi đã biết nguồn thì dùngplatformcùngexternalId. - Phụ đề được dùng trước; khi video không có phụ đề, AI chép lời âm thanh, còn tệp cục bộ khi tải lên luôn đi qua nhận dạng giọng nói.
format=jsontrả về các phân đoạn có dấu thời gian, cònformat=texttrả về văn bản thuần sẵn sàng để dán.- Trích xuất theo lô hỗ trợ danh sách URL, danh sách phát và kênh.
- Xuất theo lô hỗ trợ txt, csv, json, srt, vtt và zip; bản chép lời đã lưu tải xuống dưới dạng txt, srt, vtt, json hoặc md.
- Bản chép lời đã lưu nằm trong thư viện tài khoản, và khả năng khám phá YouTube bao gồm tìm kiếm, video, kênh, nội dung tải lên, danh sách phát và phụ đề.
- Toàn bộ hợp đồng được công bố dưới dạng tài liệu OpenAPI.
API transcript.im làm được gì
API transcript.im biến một liên kết video hoặc âm thanh công khai thành bản chép lời có dấu thời gian mà sản phẩm của bạn có thể đọc, lưu trữ, tìm kiếm hoặc đưa vào một mô hình. Bạn gửi URL; API phân giải nền tảng, tìm track phụ đề mà người sáng tạo đã có, và trả về văn bản kèm dấu thời gian trên mỗi dòng. Khi video hoàn toàn không có phụ đề, API không dừng ở lỗi: nó chuyển sang chép lời bằng AI cho phần âm thanh để cùng một yêu cầu vẫn tạo ra văn bản.
- Một yêu cầu, văn bản thật — phân giải một liên kết và trả về các phân đoạn bản chép lời có dấu thời gian hoặc văn bản thuần.
- Phụ đề trước, AI sau — dùng track của người sáng tạo khi có, chép lời âm thanh khi không có.
- Mặc định bất đồng bộ cho ASR — job id cho phép bạn hỏi thăm một bản chép lời dài mà không bị chặn.
- Nhận biết ngôn ngữ — yêu cầu thứ tự ưu tiên ngôn ngữ và đọc lại ngôn ngữ mà API đã phân giải.
- Không phụ thuộc nền tảng — bên gọi không cần biết video được lưu trữ ở đâu.
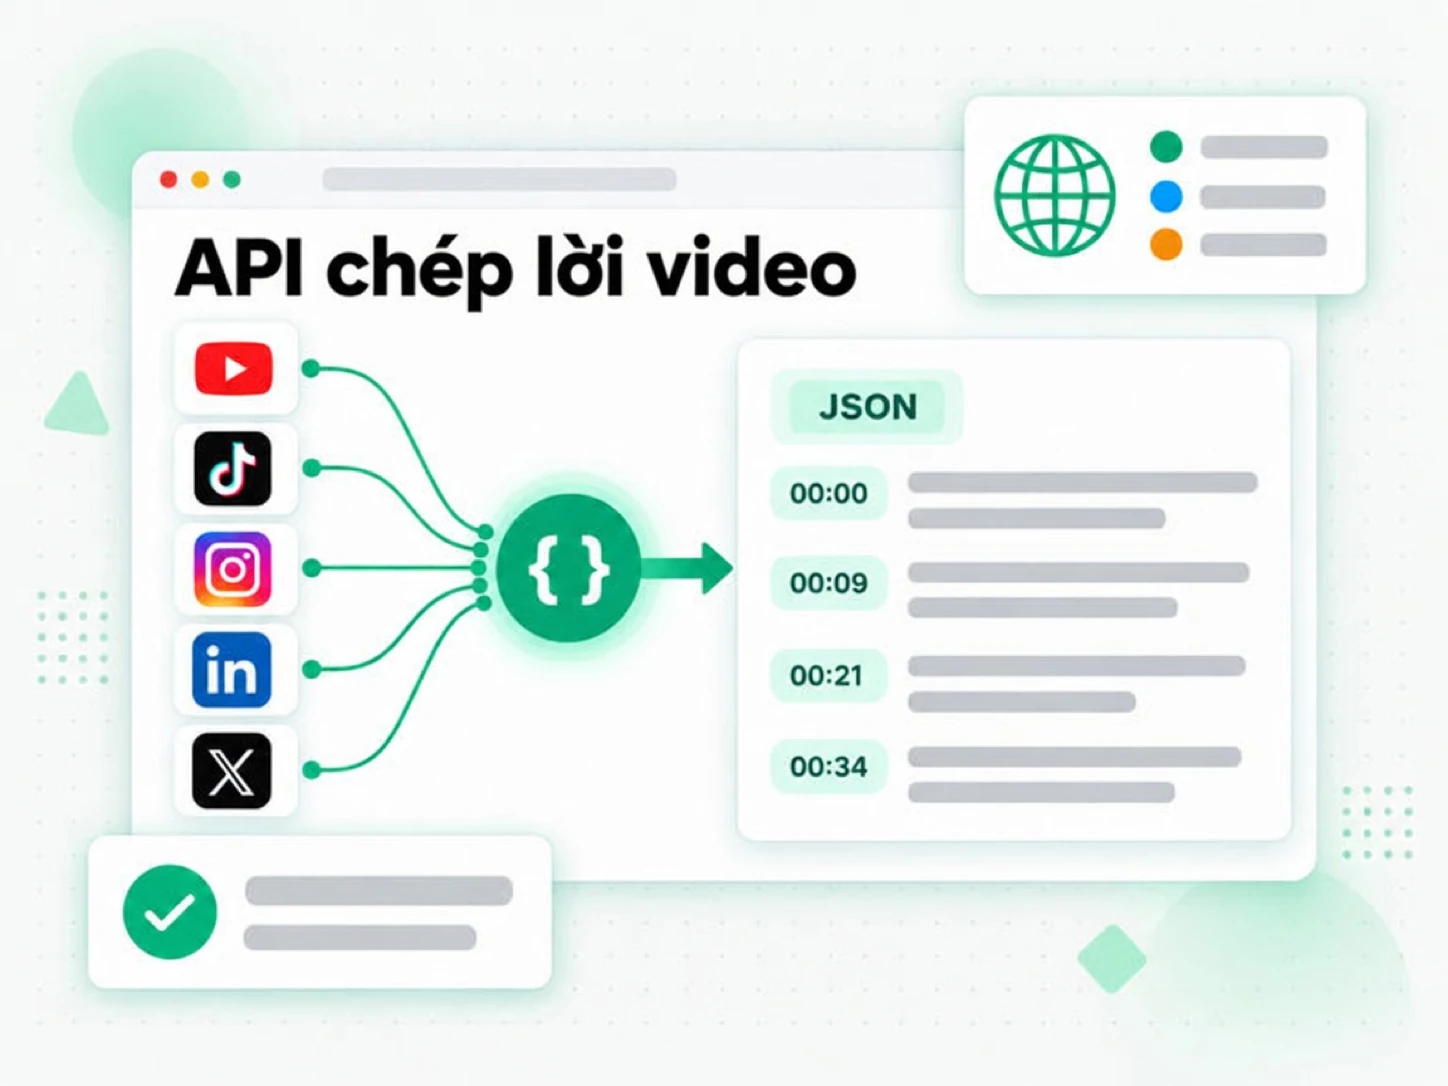
Một API bản chép lời cho năm nền tảng
YouTube
Bản chép lời cho mọi video YouTube công khai, Short hoặc bản ghi phát trực tiếp, dùng phụ đề của người sáng tạo trước và chép lời bằng AI khi thiếu phụ đề. YouTube cũng là nền tảng có bề mặt khám phá đầy đủ — tìm kiếm, video, kênh, nội dung tải lên, danh sách phát và phụ đề — dùng song song với chính bản chép lời. Nội dung tồn đọng của một kênh hoặc một danh sách phát trở thành một lô bản chép lời có dấu thời gian, còn một liên kết đơn trở về dưới dạng văn bản dễ đọc mà bạn có thể tìm kiếm.
TikTok
Bản chép lời cho video TikTok công khai, dùng phụ đề trước và nhận dạng giọng nói làm phương án dự phòng. Dán liên kết video và đọc nội dung được nói dưới dạng văn bản sạch, có dấu thời gian để bạn tái sử dụng, dịch hoặc trích dẫn. Cùng một lệnh gọi xử lý cả clip ngắn lẫn nội dung tải lên dài hơn, nên một xu hướng, một hướng dẫn và một video nói trước camera đều trở về dưới dạng văn bản.
Bản chép lời cho Reels và bài đăng video công khai trên Instagram. Instagram không có track phụ đề để đọc, nên trích xuất là nhận dạng giọng nói bất đồng bộ: gửi liên kết, hỏi thăm job và thu văn bản khi sẵn sàng. Điều đó khiến một Reel có thể trích dẫn và tìm kiếm được dù nền tảng chưa từng công bố lời nói của nó dưới dạng văn bản.
Bản chép lời cho bài đăng video công khai trên LinkedIn, dùng phụ đề trước và nhận dạng giọng nói làm phương án dự phòng. Kết quả trở về kèm dấu thời gian, nên một bài nói, một clip sản phẩm hay một cuộc họp được ghi lại trở thành văn bản có thể tìm kiếm, trích dẫn và tái sử dụng. Rút luận điểm từ bản ghi webinar, hoặc biến cập nhật của nhà sáng lập thành bản nháp bạn có thể chỉnh sửa.
Twitter/X
Bản chép lời cho bài đăng video công khai trên X. X không có track phụ đề để đọc, nên trích xuất đi qua nhận dạng giọng nói bất đồng bộ: gửi liên kết, hỏi thăm job và thu văn bản có dấu thời gian mà bạn có thể tìm kiếm. Trích dẫn video chính xác, hoặc lưu trữ nội dung lời nói trước khi bài đăng bị chỉnh sửa hoặc gỡ bỏ.
Một yêu cầu bản chép lời diễn ra thế nào
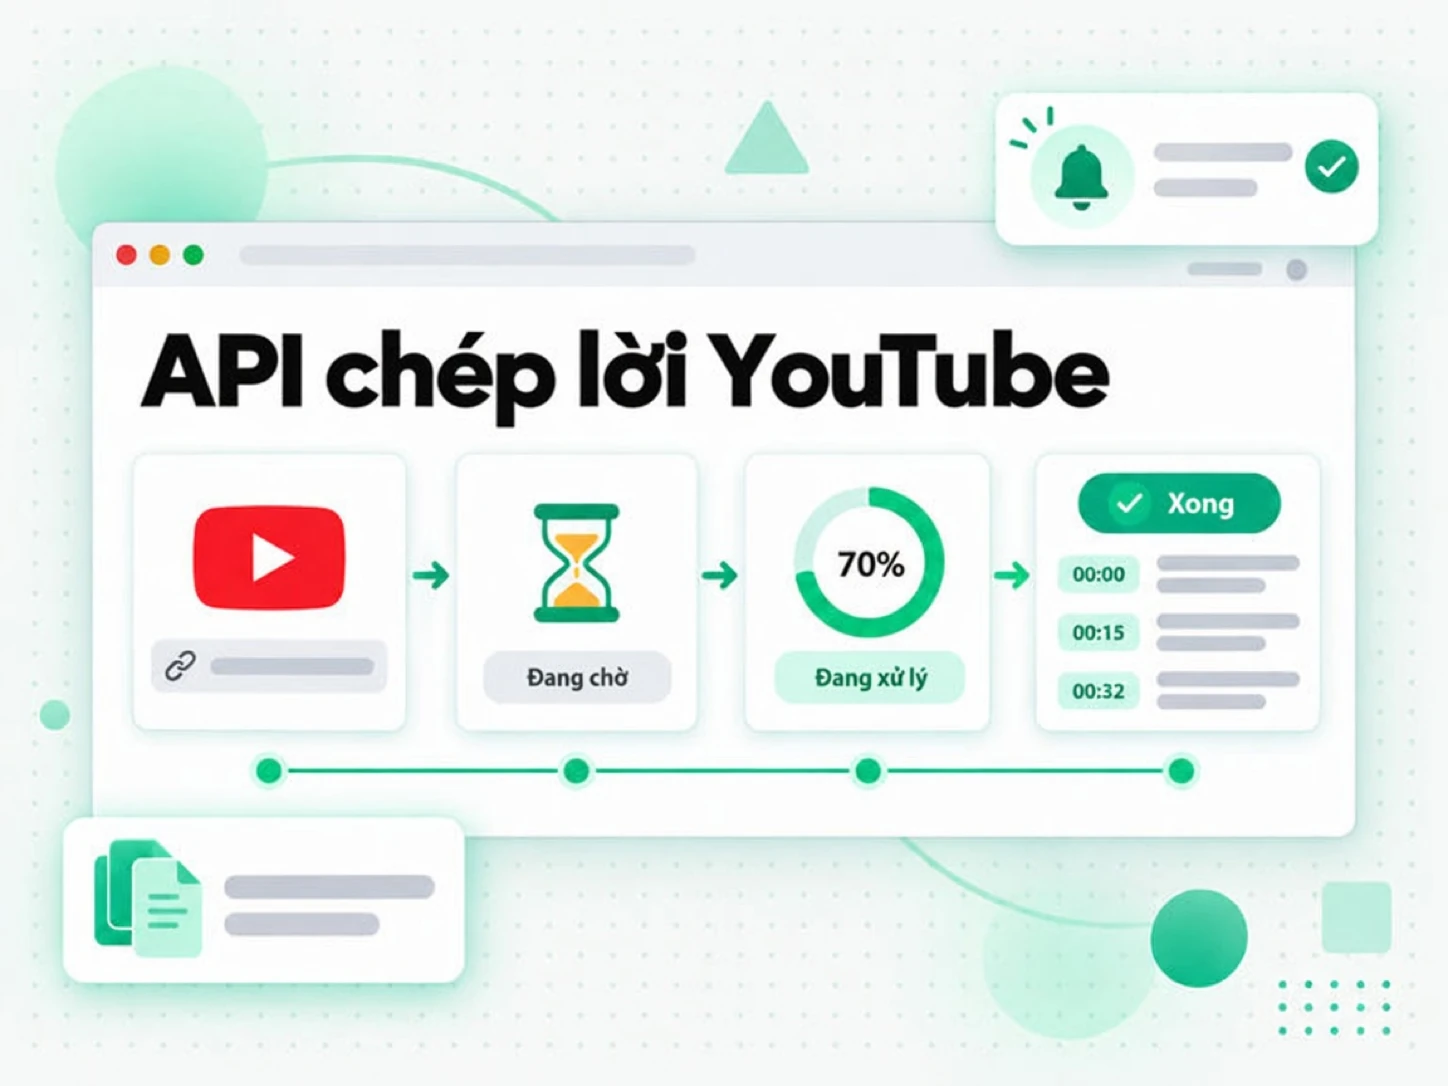
Một lệnh gọi duy nhất đưa liên kết hoặc tệp đã tải lên từ đầu vào đến bản chép lời, và API cho bạn biết nó đã đi theo đường nào.
- Gửi nguồn — gửi
url, truyềnplatformvàexternalIdkhi đã biết, hoặc tải tệp lên dưới dạngmultipart/form-datatới cùng endpoint. - Có phụ đề khớp — khi video mang phụ đề bằng một ngôn ngữ trong danh sách của bạn, bản chép lời trở về ngay trong phản hồi.
- Xử lý ngôn ngữ không khớp — khi có phụ đề nhưng không bản nào khớp danh sách của bạn, yêu cầu tiếp tục sang chép lời bằng AI và trả về
202kèm job id;404vớiavailableLanguageschỉ được trả về khi bên gọi không được phép dùng nhận dạng giọng nói. - Buộc hoặc dự phòng sang ASR — một mục
asrrõ ràng, video hoàn toàn không có track phụ đề, hoặc tệp đã tải lên sẽ khởi động job ASR và trả về job id. - Hỏi thăm hoặc truyền trực tiếp — đọc job bằng
GET /v1/transcript/job/{id}cho đến khi thành công hoặc thất bại, hoặc đăng ký luồng/eventsđể nhận tiến độ từ máy chủ. Truy vấn job trả về200ngay cả khi job thất bại, nên hãy rẽ nhánh theo trườngstatus. - Đọc kết quả — bản chép lời hoàn tất mang theo ngôn ngữ đã phân giải, độ dài, các phân đoạn có dấu thời gian và, khi được yêu cầu, siêu dữ liệu như tiêu đề, tác giả và ngày xuất bản.
- Lặp lại an toàn — bản chép lời đã trích xuất được phục vụ từ bộ nhớ đệm thay vì khởi động job mới, nên cùng một nguồn có thể được yêu cầu lại.
- Kiểm tra trước —
GET /v1/transcript/infophân giải một nguồn và liệt kê các ngôn ngữ nó có thể phục vụ trước khi bạn quyết định trích xuất.
202 kèm job id, còn tài nguyên thực sự thiếu hoặc phương án dự phòng không được phép trả về 404. Mọi đường đều trả về cùng một dạng bản chép lời khi văn bản sẵn sàng.Trích xuất theo lô và xuất tệp
Khối lượng công việc thực tế hiếm khi dừng ở một video, nên API nhận lô dưới dạng danh sách URL, danh sách phát hoặc kênh. Mỗi lô theo dõi tổng số riêng — bao nhiêu mục đang chờ, bao nhiêu thành công và bao nhiêu thất bại — và trả về các mục theo từng trang, nên một kênh dài không đến như một gói dữ liệu khổng lồ.
- Ba dạng lô —
POST /v1/batchnhận danh sách URL, danh sách phát hoặc kênh, tùy theo phần thân bạn gửi. - Trạng thái độc lập — một liên kết thất bại được đánh dấu riêng và không bao giờ bỏ phần còn lại của lô; các mục thất bại có thể thử lại bằng
/retry. - Mục phân trang — đọc lô bằng
GET /v1/batch/{batchId}, rồi theo page token được trả về để lấy các mục còn lại. - Tiến độ trực tiếp — mỗi lần hỏi thăm trả về số đếm cập nhật, nên bên gọi có thể cho biết một lần chạy dài đã xong đến đâu.
- Xuất theo định dạng của bạn — tải lô đã hoàn tất từ
/exportdưới dạngtxt,csv,json,srt,vtthoặczip.
srt và vtt đi thẳng vào trình biên tập hoặc trình phát. Với một kho lưu trữ, csv, json và zip giữ cả một thư viện bản ghi có thể tìm kiếm như một kho ngữ liệu duy nhất. Các định dạng khớp với phản hồi của bản chép lời đơn, nên một bên tiêu thụ xử lý được một kết quả đã biết cách đọc một lô.Bản chép lời đã lưu trong thư viện tài khoản
Trích xuất và lưu trữ là hai việc khác nhau: một bản chép lời trở thành một phần của thư viện tài khoản khi được lưu, và thư viện là nơi bạn đọc, tìm kiếm, tải xuống và xóa nó về sau mà không phải chạy lại trích xuất.
- Liệt kê nội dung đã lưu —
GET /v1/library/transcriptsphân trang qua bản chép lời của tài khoản, bản ghi lô và các dòng lịch sử thất bại, kèm tìm kiếm, bộ lọc nền tảng và ngôn ngữ, cùng sắp xếp. - Đọc một mục —
GET /v1/library/transcripts/{platform}/{externalId}trả về bản chép lời đã lưu theo nền tảng và id bên ngoài, hoặc theo ngôn ngữ bạn nêu. - Tải xuống — tuyến
/downloadxuất bản chép lời đã lưu dưới dạngtxt,srt,vtt,jsonhoặcmd. - Nội dung liên quan — tuyến
/relatedliệt kê các mục đã lưu khác từ cùng kênh. - Xóa —
DELETEđưa một mục ra khỏi thư viện mà không đụng đến bản sao của người khác. - Đọc giới hạn theo tài khoản — yêu cầu tới thư viện chỉ trả về những gì tài khoản đã lưu và không bao giờ khởi động trích xuất mới, nên xem lại một bản chép lời đã lưu là đọc, không phải một job khác.
Khám phá YouTube ngoài bản chép lời
YouTube là nền tảng mà API còn trả lời những câu hỏi quanh một bản chép lời, dùng cùng tên tài nguyên như YouTube Data API.
- Tìm kiếm —
GET /v1/youtube/searchtìm video, kênh hoặc danh sách phát theo truy vấn và trả về kết quả phân trang theo con trỏ. - Video —
GET /v1/youtube/videostrả về chi tiết một video, gồm cả việc có phụ đề hay không. - Kênh —
GET /v1/youtube/channelsphân giải một kênh theo id hoặc@handle. - Nội dung tải lên của kênh —
GET /v1/youtube/channels/{channelId}/videosduyệt nội dung tải lên của một kênh. - Mục trong danh sách phát —
GET /v1/youtube/playlists/{playlistId}/itemsduyệt một danh sách phát. - Phụ đề —
GET /v1/youtube/captionstrả về siêu dữ liệu track phụ đề và văn bản phụ đề của một video. Nó không bao giờ khởi động job nhận dạng giọng nói: khi báorequiresAsync, hãy gọiPOST /v1/transcriptđể chạy chép lời.
Được xây dựng cho môi trường sản xuất
Bề mặt được giữ nhỏ có chủ đích, và những phần quan trọng với một dịch vụ đều được ghi lại thay vì đoán.
- Một thông tin xác thực — xác thực bằng khóa API gửi dưới dạng token Bearer, hoặc bằng
X-API-Keytừ script hay máy chủ. - Khóa có phạm vi — chỉ cấp những phạm vi mà bên gọi cần, với
transcriptsvàbatchesbao phủ công việc trích xuất và theo lô. - Lỗi có cấu trúc — lỗi trích xuất và kiểm tra trả về một đối tượng lỗi với
codeổn định vàmessagedễ đọc; phản hồi xác thực (401) và giới hạn tần suất (429) dùng phần thân lỗi phẳng đơn giản hơn. - Giới hạn có thể xử lý — yêu cầu bị giới hạn tần suất trả về
429kèmRetry-After, và phản hồi thành công mang headerX-RateLimit-*để máy khách giảm tốc đúng cách. - Hợp đồng được công bố — tài liệu OpenAPI đầy đủ chống lưng cho API, nên bạn có thể tạo máy khách, giả lập máy chủ hoặc kiểm tra phản hồi thật theo lược đồ.
- Người anh em cho tác nhân — cùng tài khoản và công cụ có thể truy cập từ máy chủ MCP của transcript.im nếu bên gọi của bạn là máy khách AI thay vì một dịch vụ.
Công cụ liên quan
Câu hỏi thường gặp về API bản chép lời
API transcript.im là gì?
API transcript.im là một bề mặt REST biến liên kết video hoặc âm thanh công khai thành bản chép lời có dấu thời gian, dùng phụ đề sẵn có trước và chép lời bằng AI khi video không có phụ đề.
API transcript.im hỗ trợ những nền tảng nào?
Nó trích xuất bản chép lời từ YouTube, TikTok, Instagram, LinkedIn và Twitter/X bằng cách nhận diện nền tảng từ liên kết bạn gửi. YouTube, TikTok và LinkedIn dùng phụ đề trước với nhận dạng giọng nói làm phương án dự phòng; Instagram và X không có track phụ đề và đi thẳng vào nhận dạng giọng nói.
Điều gì xảy ra khi video không có phụ đề?
Khi video hoàn toàn không có track phụ đề, API khởi động job ASR và trả về job id; bạn hỏi thăm job đó cho đến khi bản chép lời sẵn sàng, nên yêu cầu không bao giờ bị chặn vì nhận dạng giọng nói.
Tôi có thể chép lời tệp âm thanh hoặc video cục bộ không?
Có. POST /v1/transcript nhận phần thân multipart/form-data với một phần file thay cho URL. Tệp tải lên đi thẳng vào nhận dạng giọng nói, nên trả về job 202 — hoặc kết quả 200 nếu hoàn tất trong ngân sách chờ.
API transcript.im có trả về dấu thời gian cùng văn bản không?
Có. Phản hồi JSON mang các phân đoạn có dấu thời gian và phản hồi văn bản có thể giữ tiền tố dấu thời gian trên mỗi dòng, nên bạn có thể quay lại thời điểm một câu được nói.
Làm sao yêu cầu bản chép lời bằng một ngôn ngữ cụ thể?
Gửi danh sách thứ tự ưu tiên ngôn ngữ phân tách bằng dấu phẩy, gồm các mục asr và asr-<code>. Phụ đề khớp được trả về trực tiếp; khi có phụ đề nhưng không bản nào khớp danh sách, yêu cầu tiếp tục sang chép lời bằng AI và trả về job 202, còn 404 kèm các ngôn ngữ có sẵn chỉ được trả về khi không được phép dùng nhận dạng giọng nói.
Làm sao biết bản chép lời bất đồng bộ đã sẵn sàng?
Hỏi thăm GET /v1/transcript/job/{id} bằng cùng thông tin xác thực cho đến khi nó báo thành công hoặc thất bại, hoặc đăng ký GET /v1/transcript/job/{id}/events để nhận cập nhật từ máy chủ. Truy vấn job trả về 200 ngay cả khi job thất bại, nên hãy đọc trường status và error thay vì mã HTTP.
API transcript.im có hỗ trợ trích xuất theo lô không?
Có. Một lô nhận danh sách URL, danh sách phát hoặc kênh, theo dõi trạng thái từng mục và trả về các mục theo từng trang.
Tôi có thể tải xuống những định dạng xuất nào?
Một lô đã hoàn tất xuất dưới dạng txt, csv, json, srt, vtt hoặc zip; một bản chép lời đã lưu tải xuống dưới dạng txt, srt, vtt, json hoặc md.
Bản chép lời đã lưu nằm ở đâu?
Thư viện tài khoản là nơi chứa bản chép lời đã lưu và bản ghi lô, nằm dưới /v1/library. Nó cung cấp các tuyến liệt kê, đọc, tải xuống, liên quan và xóa, và các lần đọc giới hạn theo tài khoản cũng như không bao giờ khởi động trích xuất mới.
Endpoint phụ đề YouTube trả về gì?
GET /v1/youtube/captions trả về siêu dữ liệu track phụ đề của một video cùng văn bản phụ đề. Nó không bao giờ khởi động job nhận dạng giọng nói; khi báo requiresAsync, hãy gọi POST /v1/transcript để chạy chép lời.
API transcript.im báo lỗi và giới hạn tần suất thế nào?
Lỗi trích xuất và kiểm tra dùng một đối tượng với code và message; xác thực trả về 401 phẳng, và giới hạn tần suất trả về 429 phẳng kèm Retry-After cùng header X-RateLimit-* để máy khách giảm tốc đúng cách.
Thêm bản chép lời vào sản phẩm của bạn
Tạo khóa API, gửi một liên kết video hoặc tệp cục bộ, rồi đọc bản chép lời về dưới dạng JSON hoặc văn bản thuần.