
REST API
API ถอดเสียงสำหรับวิดีโอและเสียง
transcript.im เปิดไปป์ไลน์การดึงข้อมูลตัวเดียวกับที่ขับเคลื่อนผลิตภัณฑ์ให้เป็น API ถอดเสียงแบบมีเวอร์ชัน ส่ง URL วิดีโอหรือเสียง แล้วรับข้อความพร้อมการประทับเวลากลับมาในรูปแบบ JSON หรือข้อความล้วน โดยระบบตรวจจับแพลตฟอร์มให้ คำบรรยายที่มีอยู่จะถูกใช้ก่อน เมื่อวิดีโอไม่มี AI จะถอดเสียงและส่งผลลัพธ์กลับแบบอะซิงโครนัส
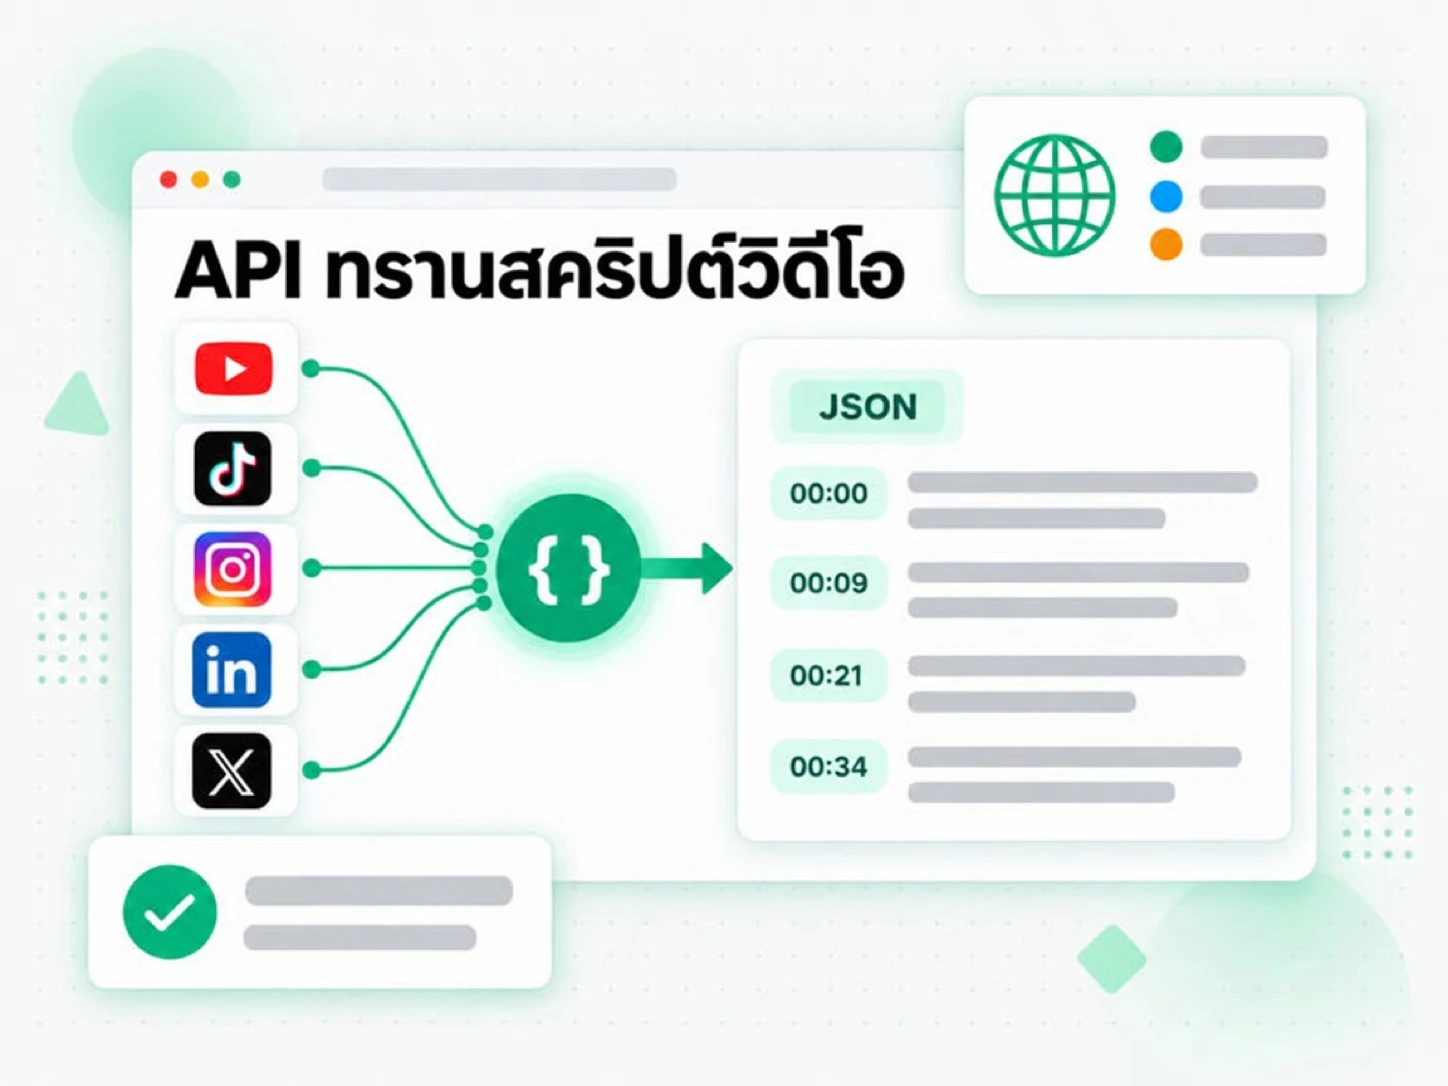
urlเดียวรับได้ทั้งลิงก์เต็มและลิงก์ย่อ และตรวจจับ YouTube, TikTok, Instagram, LinkedIn และ Twitter/X ให้ สำหรับ YouTube ยังรู้จัก video id เปล่า ๆ และเมื่อรู้แหล่งอยู่แล้วจะใช้platformคู่กับexternalIdได้- ใช้คำบรรยายก่อน เมื่อวิดีโอไม่มี AI จะถอดเสียงพูด และไฟล์ในเครื่องที่อัปโหลดจะผ่านการรู้จำเสียงเสมอ
format=jsonคืนเซกเมนต์พร้อมการประทับเวลา ส่วนformat=textคืนข้อความล้วนที่พร้อมนำไปวาง- การดึงแบบแบทช์รองรับรายการ URL เพลย์ลิสต์ และช่อง
- การส่งออกแบบแบทช์รองรับ txt, csv, json, srt, vtt และ zip ส่วนทรานสคริปต์ที่บันทึกไว้ดาวน์โหลดเป็น txt, srt, vtt, json หรือ md
- ทรานสคริปต์ที่บันทึกไว้อยู่ในไลบรารีของบัญชี และการค้นพบบน YouTube ครอบคลุมการค้นหา วิดีโอ ช่อง การอัปโหลด เพลย์ลิสต์ และคำบรรยาย
- สัญญาฉบับเต็มเผยแพร่เป็นเอกสาร OpenAPI
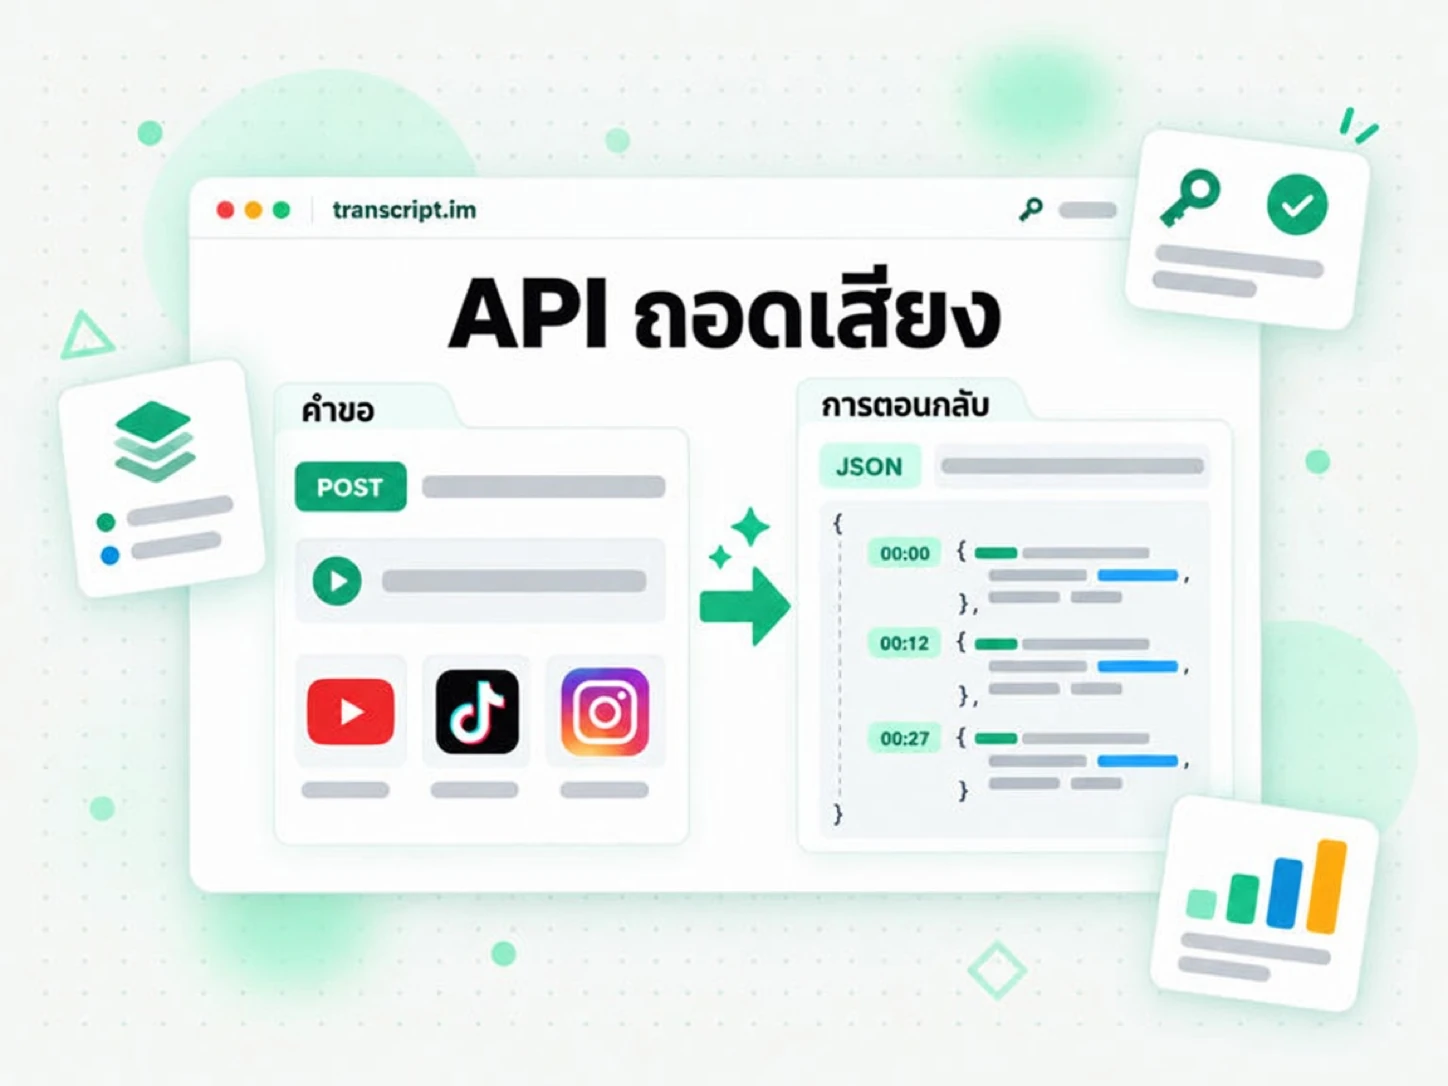
API ของ transcript.im ทำอะไรได้
API ของ transcript.im เปลี่ยนลิงก์วิดีโอหรือเสียงสาธารณะให้เป็นทรานสคริปต์พร้อมการประทับเวลาที่ผลิตภัณฑ์ของคุณอ่าน จัดเก็บ ค้นหา หรือส่งต่อให้โมเดลได้ คุณส่ง URL ระบบจะระบุแพลตฟอร์ม มองหาแทร็กคำบรรยายที่ครีเอเตอร์มีอยู่แล้ว และคืนข้อความที่เขียนพร้อมการประทับเวลาในทุกบรรทัด เมื่อวิดีโอไม่มีคำบรรยายเลย API จะไม่หยุดที่ข้อผิดพลาด แต่จะเปลี่ยนไปใช้การถอดเสียงด้วย AI เพื่อให้คำขอเดิมยังคงได้ข้อความกลับมา
- คำขอเดียว ได้ข้อความจริง — ระบุลิงก์แล้วคืนเซกเมนต์ทรานสคริปต์พร้อมการประทับเวลาหรือข้อความล้วน
- คำบรรยายก่อน AI ทีหลัง — ใช้แทร็กของครีเอเตอร์เมื่อมี และถอดเสียงเมื่อไม่มี
- ASR เป็นอะซิงโครนัสโดยค่าเริ่มต้น — job id ให้คุณสอบถามงานถอดเสียงยาวได้โดยไม่บล็อก
- รับรู้ภาษา — ขอลำดับความสำคัญภาษาแล้วอ่านภาษาที่ API ระบุกลับมา
- ไม่ผูกกับแพลตฟอร์ม — ผู้เรียกไม่จำเป็นต้องรู้ว่าวิดีโอถูกโฮสต์ที่ไหน
API ถอดเสียงเดียวสำหรับห้าแพลตฟอร์ม
YouTube
ทรานสคริปต์สำหรับวิดีโอ YouTube สาธารณะ Short หรือการบันทึกสด โดยใช้คำบรรยายของครีเอเตอร์ก่อนและใช้การถอดเสียงด้วย AI เมื่อไม่มีคำบรรยาย YouTube ยังเป็นแพลตฟอร์มที่มีพื้นผิวการค้นพบครบถ้วน — การค้นหา วิดีโอ ช่อง การอัปโหลด เพลย์ลิสต์ และคำบรรยาย — ใช้ร่วมกับตัวทรานสคริปต์ได้ งานค้างของช่องหรือเพลย์ลิสต์จะกลายเป็นแบทช์ทรานสคริปต์พร้อมการประทับเวลา ส่วนลิงก์เดียวจะกลับมาเป็นข้อความที่อ่านง่ายและค้นหาได้
TikTok
ทรานสคริปต์สำหรับวิดีโอ TikTok สาธารณะ โดยใช้คำบรรยายก่อนและใช้การรู้จำเสียงเป็นทางเลือกสำรอง วางลิงก์วิดีโอแล้วอ่านเนื้อหาที่พูดเป็นข้อความสะอาดพร้อมการประทับเวลาที่คุณนำไปใช้ซ้ำ แปล หรืออ้างอิงได้ คำขอเดียวกันครอบคลุมทั้งคลิปสั้นและไฟล์อัปโหลดที่ยาวกว่า เทรนด์ บทเรียน และวิดีโอที่มีคนพูดหน้ากล้องจึงกลับมาเป็นข้อความทั้งหมด
ทรานสคริปต์สำหรับ Reels และโพสต์วิดีโอสาธารณะบน Instagram Instagram ไม่มีแทร็กคำบรรยายให้อ่าน การดึงข้อมูลจึงเป็นการรู้จำเสียงแบบอะซิงโครนัส ส่งลิงก์ สอบถามงาน แล้วเก็บข้อความเมื่อพร้อม นี่ทำให้ Reel อ้างอิงและค้นหาได้ แม้แพลตฟอร์มจะไม่เคยเผยแพร่คำพูดเป็นข้อความ
ทรานสคริปต์สำหรับโพสต์วิดีโอสาธารณะบน LinkedIn โดยใช้คำบรรยายก่อนและใช้การรู้จำเสียงเป็นทางเลือกสำรอง ผลลัพธ์กลับมาพร้อมการประทับเวลา งานบรรยาย คลิปสินค้า หรือการประชุมที่บันทึกไว้จึงกลายเป็นข้อความที่ค้นหาได้และนำไปอ้างอิงหรือใช้ซ้ำได้ ดึงข้อโต้แย้งออกจากไฟล์บันทึกเว็บบินาร์ หรือเปลี่ยนอัปเดตของผู้ก่อตั้งให้เป็นฉบับร่างที่แก้ไขได้
Twitter/X
ทรานสคริปต์สำหรับโพสต์วิดีโอสาธารณะบน X X ไม่มีแทร็กคำบรรยายให้อ่าน การดึงข้อมูลจึงผ่านการรู้จำเสียงแบบอะซิงโครนัส ส่งลิงก์ สอบถามงาน แล้วเก็บข้อความพร้อมการประทับเวลาที่ค้นหาได้ อ้างอิงวิดีโอได้อย่างแม่นยำ หรือเก็บเนื้อหาที่พูดไว้ก่อนที่โพสต์จะถูกแก้ไขหรือลบ
คำขอถอดเสียงไหลอย่างไร
การเรียกครั้งเดียวพาลิงก์หรือไฟล์ที่อัปโหลดจากอินพุตไปจนถึงทรานสคริปต์ และ API จะบอกคุณว่าเลือกเส้นทางใด
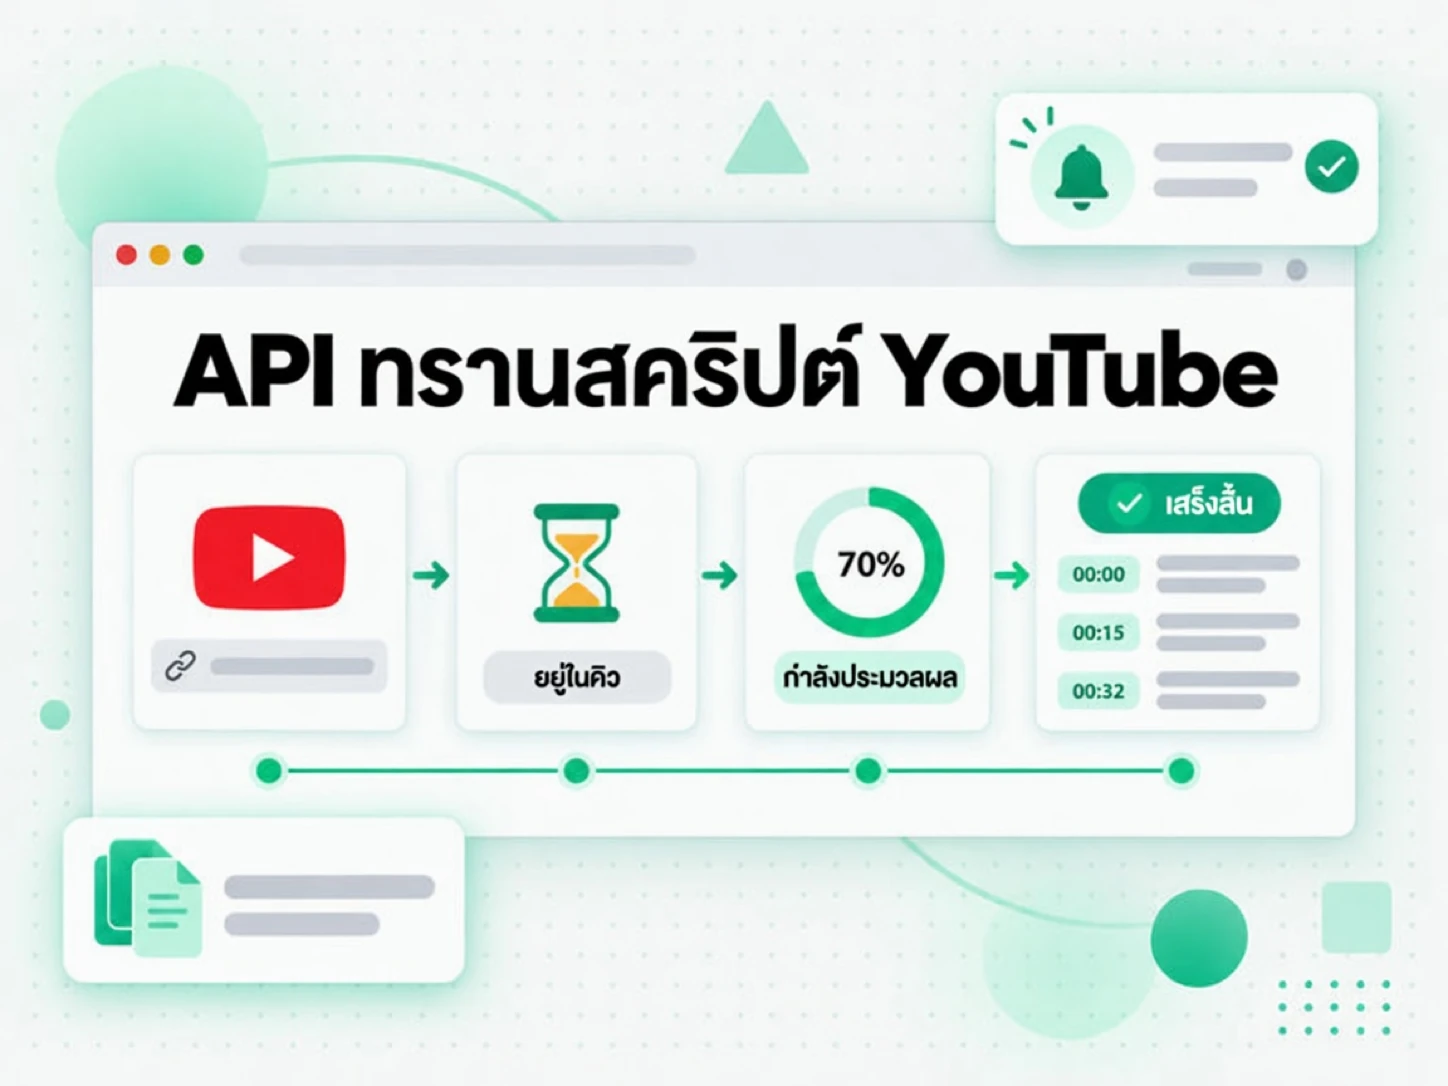
- ส่งแหล่งข้อมูล — ส่ง
urlส่งplatformและexternalIdเมื่อรู้อยู่แล้ว หรืออัปโหลดไฟล์เป็นmultipart/form-dataไปยังเอนด์พอยต์เดียวกัน - ได้คำบรรยายที่ตรงกัน — เมื่อวิดีโอมีคำบรรยายในภาษาที่อยู่ในรายการของคุณ ทรานสคริปต์จะกลับมาในคำตอบ
- จัดการภาษาที่ไม่ตรง — เมื่อมีคำบรรยายแต่ไม่มีอันใดตรงกับรายการของคุณ คำขอจะดำเนินต่อไปยังการถอดเสียงด้วย AI และคืน
202พร้อม job id ส่วน404ที่มีavailableLanguagesจะคืนเฉพาะเมื่อผู้เรียกไม่ได้รับอนุญาตให้ใช้การรู้จำเสียง - บังคับหรือถอยไปใช้ ASR — รายการ
asrที่ระบุชัด วิดีโอที่ไม่มีแทร็กคำบรรยายเลย หรือไฟล์ที่อัปโหลด จะเริ่มงาน ASR และคืน job id - สอบถามหรือสตรีม — อ่านงานด้วย
GET /v1/transcript/job/{id}จนสำเร็จหรือล้มเหลว หรือสมัครสตรีม/eventsเพื่อรับความคืบหน้าจากเซิร์ฟเวอร์ การสอบถามงานคืน200แม้งานจะล้มเหลว จึงให้แยกตามฟิลด์status - อ่านผลลัพธ์ — ทรานสคริปต์ที่เสร็จแล้วมีภาษาที่ระบุ ความยาว เซกเมนต์พร้อมการประทับเวลา และเมื่อขอ จะมีเมทาดาทาเช่นชื่อเรื่อง ผู้เขียน และวันที่เผยแพร่
- ทำซ้ำได้อย่างปลอดภัย — ทรานสคริปต์ที่ดึงไว้แล้วจะถูกส่งจากแคชแทนการเริ่มงานใหม่ จึงขอแหล่งเดิมซ้ำได้
- ตรวจดูก่อน —
GET /v1/transcript/infoระบุแหล่งข้อมูลและแสดงภาษาที่ให้บริการได้ ก่อนที่คุณจะตัดสินใจดึงข้อมูล
202 พร้อม job id ส่วนทรัพยากรที่ไม่มีจริงหรือทางเลือกสำรองที่ไม่ได้รับอนุญาตจะคืน 404 ทุกเส้นทางคืนรูปทรานสคริปต์เดียวกันเมื่อข้อความพร้อมการดึงแบบแบทช์และการส่งออก
งานจริงไม่ค่อยหยุดที่วิดีโอเดียว API จึงรับแบทช์เป็นรายการ URL เพลย์ลิสต์ หรือช่อง แต่ละแบทช์ติดตามยอดรวมของตัวเอง — มีกี่รายการที่รออยู่ สำเร็จกี่รายการ และล้มเหลวกี่รายการ — และคืนรายการทีละหน้า ช่องที่ยาวจึงไม่มาถึงเป็นเพย์โหลดก้อนมหึมา
- สามรูปแบบแบทช์ —
POST /v1/batchรับรายการ URL เพลย์ลิสต์ หรือช่อง ตามบอดี้ที่คุณส่ง - สถานะอิสระ — ลิงก์ที่ล้มเหลวจะถูกทำเครื่องหมายแยก และไม่ทิ้งส่วนที่เหลือของแบทช์ รายการที่ล้มเหลวลองใหม่ได้ด้วย
/retry - รายการแบบแบ่งหน้า — อ่านแบทช์ด้วย
GET /v1/batch/{batchId}แล้วตาม page token ที่คืนมาเพื่อดูรายการที่เหลือ - ความคืบหน้าแบบสด — การสอบถามแต่ละครั้งคืนจำนวนที่นับใหม่ ผู้เรียกจึงแสดงได้ว่าการทำงานยาว ๆ เสร็จไปเท่าไร
- ส่งออกในรูปแบบของคุณ — ดาวน์โหลดแบทช์ที่เสร็จแล้วจาก
/exportเป็นtxt,csv,json,srt,vttหรือzip
srt และ vtt ใช้กับโปรแกรมตัดต่อหรือเครื่องเล่นได้ทันที สำหรับการเก็บถาวร csv, json และ zip ทำให้คลังไฟล์บันทึกทั้งคลังค้นหาได้เป็นชุดข้อมูลเดียว รูปแบบสอดคล้องกับคำตอบของทรานสคริปต์เดี่ยว ผู้ที่จัดการผลลัพธ์หนึ่งรายการจึงอ่านแบทช์ได้อยู่แล้วทรานสคริปต์ที่บันทึกไว้ในไลบรารีของบัญชี
การดึงข้อมูลและการจัดเก็บเป็นคนละเรื่อง ทรานสคริปต์จะกลายเป็นส่วนหนึ่งของไลบรารีของบัญชีเมื่อถูกบันทึก และไลบรารีคือที่ที่คุณอ่าน ค้นหา ดาวน์โหลด และลบในภายหลังโดยไม่ต้องดึงข้อมูลใหม่
- แสดงเนื้อหาที่บันทึกไว้ —
GET /v1/library/transcriptsแบ่งหน้าผ่านทรานสคริปต์ของบัญชี บันทึกแบทช์ และแถวประวัติที่ล้มเหลว พร้อมการค้นหา ตัวกรองแพลตฟอร์มและภาษา และการจัดเรียง - อ่านรายการเดียว —
GET /v1/library/transcripts/{platform}/{externalId}คืนทรานสคริปต์ที่บันทึกไว้ตามแพลตฟอร์มและ id ภายนอก หรือตามภาษาที่คุณระบุ - ดาวน์โหลด — เส้นทาง
/downloadส่งออกทรานสคริปต์ที่บันทึกไว้เป็นtxt,srt,vtt,jsonหรือmd - เนื้อหาที่เกี่ยวข้อง — เส้นทาง
/relatedแสดงรายการอื่นที่บันทึกไว้จากช่องเดียวกัน - ลบ —
DELETEเอารายการออกจากไลบรารีโดยไม่แตะสำเนาของผู้อื่น - การอ่านที่จำกัดตามบัญชี — คำขอไปยังไลบรารีคืนเฉพาะสิ่งที่บัญชีบันทึกไว้ และไม่เริ่มการดึงข้อมูลใหม่เลย การกลับมาดูทรานสคริปต์ที่บันทึกไว้จึงเป็นการอ่าน ไม่ใช่การเริ่มงานใหม่
การค้นพบบน YouTube นอกเหนือจากทรานสคริปต์
YouTube คือแพลตฟอร์มที่ API ยังตอบคำถามรอบ ๆ ทรานสคริปต์ด้วย โดยใช้ชื่อรีซอร์สแบบเดียวกับ YouTube Data API
- การค้นหา —
GET /v1/youtube/searchค้นวิดีโอ ช่อง หรือเพลย์ลิสต์ตามคำค้น และคืนผลลัพธ์แบบแบ่งหน้าด้วยเคอร์เซอร์ - วิดีโอ —
GET /v1/youtube/videosคืนรายละเอียดของวิดีโอ รวมถึงว่ามีคำบรรยายให้ใช้หรือไม่ - ช่อง —
GET /v1/youtube/channelsระบุช่องด้วย id หรือ@handle - การอัปโหลดของช่อง —
GET /v1/youtube/channels/{channelId}/videosไล่ดูการอัปโหลดของช่อง - รายการในเพลย์ลิสต์ —
GET /v1/youtube/playlists/{playlistId}/itemsไล่ดูเพลย์ลิสต์ - คำบรรยาย —
GET /v1/youtube/captionsคืนเมทาดาทาแทร็กคำบรรยายและข้อความคำบรรยายของวิดีโอ ไม่เริ่มงานรู้จำเสียงเลย เมื่อรายงานrequiresAsyncให้เรียกPOST /v1/transcriptเพื่อถอดเสียง
สร้างมาเพื่องานโปรดักชัน
พื้นผิวมีขนาดเล็กโดยตั้งใจ และส่วนที่สำคัญต่อบริการก็มีเอกสารกำกับแทนการเดา
- ข้อมูลรับรองเดียว — ยืนยันตัวตนด้วยคีย์ API ที่ส่งเป็น Bearer token หรือด้วย
X-API-Keyจากสคริปต์หรือเซิร์ฟเวอร์ - คีย์แบบมีขอบเขต — ให้เฉพาะขอบเขตที่ผู้เรียกต้องใช้ โดย
transcriptsและbatchesครอบคลุมงานดึงข้อมูลและงานแบทช์ - ข้อผิดพลาดแบบมีโครงสร้าง — ความล้มเหลวในการดึงข้อมูลและตรวจสอบคืนออบเจกต์ข้อผิดพลาดที่มี
codeคงที่และmessageที่อ่านได้ ส่วนการตอบกลับเรื่องการยืนยันตัวตน (401) และการจำกัดอัตรา (429) ใช้บอดี้ข้อผิดพลาดแบบแบนที่ง่ายกว่า - ขีดจำกัดที่ลงมือได้ — คำขอที่ถูกจำกัดอัตราคืน
429พร้อมRetry-Afterและคำตอบที่สำเร็จมีเฮดเดอร์X-RateLimit-*ไคลเอนต์จึงถอยกลับได้ถูกต้อง - สัญญาที่เผยแพร่ — เอกสาร OpenAPI ฉบับเต็มรองรับ API คุณจึงสร้างไคลเอนต์ จำลองเซิร์ฟเวอร์ หรือตรวจสอบคำตอบจริงเทียบกับสคีมาได้
- พี่น้องสำหรับเอเจนต์ — บัญชีและเครื่องมือชุดเดียวกันเข้าถึงได้จากเซิร์ฟเวอร์ MCP ของ transcript.im หากผู้เรียกของคุณเป็นไคลเอนต์ AI ไม่ใช่บริการ
เครื่องมือที่เกี่ยวข้อง
คำถามที่พบบ่อยเกี่ยวกับ API ถอดเสียง
API ของ transcript.im คืออะไร
API ของ transcript.im คือพื้นผิว REST ที่เปลี่ยนลิงก์วิดีโอหรือเสียงสาธารณะให้เป็นทรานสคริปต์พร้อมการประทับเวลา โดยใช้คำบรรยายที่มีอยู่ก่อนและใช้การถอดเสียงด้วย AI เมื่อวิดีโอไม่มี
API ของ transcript.im รองรับแพลตฟอร์มใดบ้าง
ดึงทรานสคริปต์จาก YouTube, TikTok, Instagram, LinkedIn และ Twitter/X โดยตรวจจับแพลตฟอร์มจากลิงก์ที่คุณส่ง YouTube, TikTok และ LinkedIn ใช้คำบรรยายก่อนโดยมีการรู้จำเสียงเป็นทางเลือกสำรอง ส่วน Instagram และ X ไม่มีแทร็กคำบรรยายและไปที่การรู้จำเสียงโดยตรง
จะเกิดอะไรขึ้นเมื่อวิดีโอไม่มีคำบรรยาย
เมื่อวิดีโอไม่มีแทร็กคำบรรยายเลย API จะเริ่มงาน ASR และคืน job id คุณสอบถามงานนั้นจนทรานสคริปต์พร้อม คำขอจึงไม่ถูกบล็อกด้วยการรู้จำเสียง
ถอดเสียงจากไฟล์เสียงหรือวิดีโอในเครื่องได้ไหม
ได้ POST /v1/transcript รับบอดี้ multipart/form-data ที่มีส่วน file แทน URL ไฟล์ที่อัปโหลดจะไปที่การรู้จำเสียงทันที จึงคืนงาน 202 — หรือผลลัพธ์ 200 หากเสร็จภายในงบเวลารอ
API ของ transcript.im คืนการประทับเวลาพร้อมข้อความได้ไหม
ได้ คำตอบ JSON มีเซกเมนต์พร้อมการประทับเวลา และคำตอบข้อความเก็บคำนำหน้าการประทับเวลาต่อบรรทัดได้ คุณจึงย้อนกลับไปยังจังหวะที่ประโยคถูกพูดได้
จะขอทรานสคริปต์ในภาษาเฉพาะได้อย่างไร
ส่งรายการลำดับความสำคัญภาษาที่คั่นด้วยเครื่องหมายจุลภาค รวมรายการ asr และ asr-<code> คำบรรยายที่ตรงจะถูกคืนโดยตรง เมื่อมีคำบรรยายแต่ไม่มีอันใดตรงกับรายการ คำขอจะดำเนินต่อไปยังการถอดเสียงด้วย AI และคืนงาน 202 ส่วน 404 พร้อมภาษาที่ใช้ได้จะคืนเฉพาะเมื่อไม่ได้รับอนุญาตให้ใช้การรู้จำเสียง
จะรู้ได้อย่างไรว่าทรานสคริปต์แบบอะซิงโครนัสพร้อมแล้ว
สอบถาม GET /v1/transcript/job/{id} ด้วยข้อมูลรับรองเดิมจนรายงานว่าสำเร็จหรือล้มเหลว หรือสมัคร GET /v1/transcript/job/{id}/events เพื่อรับอัปเดตจากเซิร์ฟเวอร์ การสอบถามงานคืน 200 แม้งานจะล้มเหลว จึงอ่านฟิลด์ status และ error แทนรหัส HTTP
API ของ transcript.im รองรับการดึงแบบแบทช์ไหม
รองรับ แบทช์รับรายการ URL เพลย์ลิสต์ หรือช่อง ติดตามสถานะของแต่ละรายการ และคืนรายการทีละหน้า
ดาวน์โหลดรูปแบบการส่งออกใดได้บ้าง
แบทช์ที่เสร็จแล้วส่งออกเป็น txt, csv, json, srt, vtt หรือ zip ส่วนทรานสคริปต์ที่บันทึกไว้หนึ่งรายการดาวน์โหลดเป็น txt, srt, vtt, json หรือ md
ทรานสคริปต์ที่บันทึกไว้อยู่ที่ไหน
ไลบรารีของบัญชีคือที่ที่ทรานสคริปต์ที่บันทึกไว้และบันทึกแบทช์อยู่ ภายใต้ /v1/library โดยมีเส้นทางสำหรับแสดงรายการ อ่าน ดาวน์โหลด เกี่ยวข้อง และลบ และการอ่านจำกัดตามบัญชีและไม่เริ่มการดึงข้อมูลใหม่เลย
เอนด์พอยต์คำบรรยายของ YouTube คืนอะไร
GET /v1/youtube/captions คืนเมทาดาทาแทร็กคำบรรยายของวิดีโอพร้อมข้อความคำบรรยาย ไม่เริ่มงานรู้จำเสียงเลย เมื่อรายงาน requiresAsync ให้เรียก POST /v1/transcript เพื่อถอดเสียง
API ของ transcript.im รายงานข้อผิดพลาดและขีดจำกัดอัตราอย่างไร
ข้อผิดพลาดในการดึงข้อมูลและตรวจสอบใช้ออบเจกต์ที่มี code และ message การยืนยันตัวตนคืน 401 แบบแบน และการจำกัดอัตราคืน 429 แบบแบนพร้อม Retry-After และเฮดเดอร์ X-RateLimit-* เพื่อให้ไคลเอนต์ถอยกลับได้ถูกต้อง
เพิ่มทรานสคริปต์ให้ผลิตภัณฑ์ของคุณ
สร้างคีย์ API ส่งลิงก์วิดีโอหรือไฟล์ในเครื่อง แล้วอ่านทรานสคริปต์กลับมาเป็น JSON หรือข้อความล้วน