
Werken met video's in het Japans: een praktische gids
Leer Japanse video's met vertrouwen verwerken: taal detecteren, audio transcriberen, ondertitels vertalen met behoud van tijdstempels en de juiste tool kiezen.
Je hebt een Japanse YouTube-link openstaan, drie tools zijn al in gebruik, en geen enkele is het eens over wat de spreker heeft gezegd. De ene export mist regels, het ene transcript vlakt belangrijke woorden weg, en één ondertitelconcept leest prima tot je het probeert uit te lijnen met de audio. Dat is het gebruikelijke pijnpunt bij video in het Japans, en het is waarom een generieke workflow meestal uit elkaar valt nog voordat de ondertitels bestaan.
Japanse video vraagt om een weloverwogen aanpak, omdat de taal bij elke stap de opdracht verandert. De audio kan vol zitten met leenwoorden, eerbiedsvormen, afgekapte antwoorden en snel heen-en-weer gepraat die een gewone spraak-naar-tekstbewerking niet altijd netjes aankan. De tekstkant heeft ook zijn eigen regels, want Japanse ondertitels dragen vaak meer betekenis per teken, en de ruimte op het scherm is krapper dan veel Engelse editors verwachten.
Een goede workflow begint met vier stappen: detecteren, transcriberen, timing en vertalen. Sla je er één over, dan wordt de rest van het bestand moeilijker te vertrouwen. Voor een praktisch startpunt laat de Japanse transcriptwerkruimte zien wat voor structuur dit werk minder chaotisch maakt.
Waarom Japanse video een eigen workflow verdient
Een teamleider zet een link naar een Japans webinar van 30 minuten in een gedeeld document. De een haalt hem door een ondertitelsite, de ander probeert een algemene AI-tool, en een derde plakt de audio in een ondertiteleditor. Uiteindelijk zien alle drie de bestanden er anders uit, en geen ervan is zonder opschonen bruikbaar.
Die situatie ontstaat omdat Japanse video niet zomaar "video, maar dan in een andere taal" is. De bronaudio mengt vaak formele en informele spraak, voegt korte backchannels toe en leunt op context die een Engelstalige tool misschien wegvlakt. Het gevolg is dat transcriptie, ondertiteltiming en vertaling allemaal meer zorg nodig hebben dan een standaardworkflow in één ronde.
Ruwe video naar bruikbare tekst is geen rechte lijn
Een Japanse video doorloopt meestal een reeks als deze, ook als het team het zo niet noemt. Eerst controleert iemand welke taal de uitgever zegt dat het is. Daarna bevestigen ze hoe de audio klinkt. Vervolgens beslissen ze of ze bestaande ondertitels gebruiken of een nieuw transcript genereren. Pas dan vertalen, timen en exporteren ze.
Dat klinkt simpel, maar de breekpunten doen ertoe. Japanse ondertitels hebben vaak meer visuele ademruimte nodig, en vertaalde regels worden gemakkelijk te lang voor het oorspronkelijke cue-venster. Een workflow die die grenzen negeert, levert tekst op die er in een document prima uitziet en faalt zodra hij in een speler terechtkomt.
Praktische regel: behandel Japans als een getimede-tekstproject, niet als een vertaalklus met kopiëren en plakken.
Veel verwarring ontstaat doordat mensen aannemen dat ondertitels gewoon dialoog in een andere taal zijn. Dat zijn ze niet. Het is een gecomprimeerde leeservaring die aan bewegende video vastzit, en Japans maakt die compressie zichtbaarder omdat het schriftsysteem zelf veel informatie per teken draagt.
Ondertitels die op een pagina "kort" lijken, kunnen op het scherm toch druk aanvoelen.
Daarom blijft de rest van deze gids dicht bij de feitelijke mechanica. Als je de taal correct kunt detecteren, een schoon transcript kunt krijgen, de timing kunt behouden en de vertaalde cues leesbaar kunt houden, kun je hetzelfde proces hergebruiken voor lezingen, interviews, webinars en socialclips.
Vaststellen dat een video echt in het Japans is
De veiligste manier om Japans te herkennen is drie signalen samen te gebruiken, niet één gok. Metadata vertelt je wat de uitgever beweert. Het audiomonster vertelt je wat mensen zeggen. Het ondertitelspoor vertelt je wat een ander systeem of de uploader al als werktaal had behandeld.
Begin bij wat het platform en het bestand al zeggen
Kijk naar het taalveld als het platform dat toont. Controleer tags, beschrijvingen en eventueel geüploade ondertitelsporen. Vimeo, podcast-enclosures en metadata van lokale bestanden kunnen ook nuttige hints bevatten, zelfs als ze onvolledig zijn.
Speel dan een kort audiomonster af en laat een ASR-sonde de taal automatisch detecteren. Japans wordt meestal netjes herkend wanneer de spraak rechttoe rechtaan is. Problemen ontstaan wanneer het spoor schakelt tussen Japans en Engels, of wanneer een spreker veel leenwoorden en codeswitching gebruikt.
Inspecteer ten slotte eventuele bestaande ondertitels. Een ja-JP- of ja-CC-spoor is het sterkste signaal dat je kunt krijgen. Op YouTube laten automatische ondertitels voor Japans vaak bekende restjes achter, zoals spatiëring in volledige breedte of losse leestekens, wat nog steeds nuttig is omdat het bevestigt dat het systeem de audio al als Japans heeft behandeld.
Gebruik het sterkste signaal en documenteer daarna het randgeval
Als de drie controles overeenkomen, is de beslissing eenvoudig. Als metadata Engels zegt, maar de audiosonde en de ondertitels allebei Japans lijken, vertrouw dan op de audio en het ondertitelspoor in plaats van het label. De uitgever heeft de upload misschien verkeerd getagd, maar de gesproken inhoud is nog steeds wat je transcript moet weergeven.
Als de controles het niet met elkaar eens zijn, noteer dan de reden in je werkaantekeningen voordat je verdergaat. Dat is belangrijk omdat downstreamtools, redacteuren en reviewers allemaal baat hebben bij dezelfde taalveronderstelling. Een nette overdracht is beter dan een perfecte gok.
| Drie signalen om Japans in een video te detecteren | |||
|---|---|---|---|
| Signaal | Wat het controleert | Betrouwbaarheid | Wanneer je het kunt vertrouwen |
| Metadata | Taalvelden, tags, bestandsgegevens | Gemiddeld | Wanneer de uitgever zorgvuldig is |
| Audio-onderzoek | Wat de spreker daadwerkelijk zegt | Hoog | Wanneer het spraakfragment duidelijk is |
| Ondertitelspoor | Bestaande ja-JP- of ja-CC-tekst | Zeer hoog | Wanneer er al een ondertitelspoor bestaat |
Voor een bredere workflow om vast te leggen is Spraak naar tekst handig, omdat het uitgaat van de inhoud zelf in plaats van aan te nemen dat het label klopt.
Japans geluid betrouwbaar transcriberen
Het schoonste transcriptiepad hangt ervan af of er al ondertitels bestaan. Als dat zo is, gebruik ze dan eerst. Zo niet, genereer dan een transcript uit de audio. Dat klinkt vanzelfsprekend, maar voor Japans bespaart het veel herwerk, omdat bestaande getimede tekst vaak bruikbaarder is dan een ASR-concept.
Eerst ondertitels als het spoor er al is
Wanneer er een ja-JP-spoor bestaat, exporteer het dan en converteer het naar een schoon formaat met tekst en tijdstempels. Zowel TTML als WebVTT bevatten timing, en die timing moet intact blijven terwijl je de tekst opschoont. De eerste taak is niet om de formulering te “verbeteren”. Het is om ervoor te zorgen dat het transcript het hele audiospoor dekt zonder hiaten.
Die dekkingscontrole is belangrijker dan mensen verwachten. Een ondertitelbestand kan er verzorgd uitzien en toch beurtwisselingen, regieaanwijzingen of korte tussenwerpsels missen. Als je die hiaten vóór de vertaling opmerkt, voorkom je dat onvolledige tekst naar de volgende fase gaat.
Een schone workflow waarin ondertitels vooropstaan, bestaat meestal uit drie eenvoudige rondes:
- Extraheer het getimede spoor uit het bronplatform of -bestand.
- Normaliseer de tekst tot een leesbaar transcript met de tijdstempels er nog aan vast.
- Vergelijk de dekking met de audio, zodat ontbrekende segmenten vroeg opvallen.
Eerst ASR als er geen bruikbaar ondertitelspoor is
Als er geen ondertitels bestaan, gebruik dan spraak-naar-tekst op de audio zelf. Japans heeft over het algemeen baat bij modellen die goed omgaan met gesproken taal, omdat aannames in nieuwsredactiestijl afgekapte uitgangen, informele formuleringen en korte grammaticale partikels kunnen missen die van belang zijn voor de betekenis, zelfs wanneer ze zich niet netjes naar het Engels laten vertalen.
Voordat je de transcriptie start, geef je de engine de aangepaste woordenlijst die nodig is. Projectnamen, productnamen, achternamen en merktermenn helpen allemaal. Kies daarna zorgvuldig het uitvoerschrift. Kana kan beter zijn voor de ruwe vastlegging, terwijl kanji plus okurigana vaak natuurlijker leest voor beoordeling.
Als er meerdere sprekers zijn, is het de moeite waard om diarisatie in te schakelen. Zonder sprekersscheiding veranderen Japanse interviews en discussies heel snel in een muur van tekst. Controleer na de eerste ronde drie willekeurige minuten naast de originele audio. Die steekproef vangt de correcties op die steeds opnieuw terugkomen, vooral halfbrede cijfers, interpunctiedrift en weggelaten zinseindepartikels.
De workflow Video naar tekst voor Japanse video's is een goed voorbeeld van hoe een schone transcriptiewerkruimte die aanwijzingen georganiseerd kan houden, in plaats van dat je ze later met de hand opnieuw moet opbouwen.
Waarom Japanse ondertitels lastiger zijn dan Engelse
Japanse ondertitels vragen om een andere leesgewoonte dan Engelse. Het Engels leunt op woordgrenzen, spaties en een vertrouwd regelritme. Japans kan meer betekenis in minder zichtbare tekens proppen, waardoor een regel die op papier kort lijkt, op het scherm toch vol kan aanvoelen.
Tekendichtheid verandert alles
Een professionele Japanse stijlgids stelt de leessnelheid op 4,0 tekens per seconde en telt halfbrede tekens als 0,5 volgens OOONA's Japanse stijlgids. Die regel is nuttig omdat hij laat zien hoe Japanse ondertitels worden beoordeeld op visuele belasting, niet alleen op tekenaantal. Eén kanji kan veel betekenis dragen zonder veel ruimte in te nemen.
Netflix' richtlijnen voor Japanse getimede tekst geven hetzelfde beeld vanuit een andere hoek. Ze gebruiken een minimale ondertitelduur van 0,5 seconde per item, staan in SDH-contexten maximaal 7 tekens per seconde toe en beperken horizontale regels vaak tot ongeveer 13 volbrede tekens in hun Japanse stijlgids. De exacte getallen zijn minder belangrijk dan het principe. Ondertiteltiming moet het oog genoeg ruimte geven om te lezen voordat het beeld verdergaat.
Halfbrede en volbrede tekst zijn niet hetzelfde probleem
Generieke ondertiteltools missen dit vaak. Cijfers, haakjes, leestekens en verlengingstekens kunnen allemaal in halfbreedte of volle breedte voorkomen, en dat verandert hoe vol een cue aanvoelt. Een tekst die er in een teksteditor prima uitziet, kan er benauwd uitzien zodra hij in het ondertitelkader staat.
Engelse ondertitelaars tellen vaak woorden per regel. Japanse ondertitelaars moeten letten op tekendichtheid, symboolbalans en hoe lang de kijker nodig heeft om op elke cue te landen. Een ondertitel kan taalkundig correct zijn en toch moeilijk leesbaar als de visuele belasting te hoog is.
| Japanse versus Engelse ondertitelbeperkingen | ||
|---|---|---|
| Beperking | Japans | Engels |
| Leestempo | Ongeveer 4,0 tekens per seconde in OOONA's Japanse stijlgids | Vaak geregeld via woordritme in plaats van tekendichtheid |
| Regellengte | Ongeveer 13 tekens in volle breedte in Netflix' Japanse Timed Text Style Guide | Meestal bredere tekentellingen op het scherm |
| Symboolverwerking | Halfbreedte- en volle-breedtevormen veranderen de visuele dichtheid | Minder een lay-outprobleem |
| Tijdvenster | Korte cues vragen om zorgvuldig tempo | Timing blijft belangrijk, maar de visuele belasting is lichter |
Als een Japanse cue vol aanvoelt, maak hem korter voordat je het lettertype aanpast.
Die gewoonte loont. Een ondertitel die binnen het regelbudget blijft, is meestal makkelijker te lezen dan een die elk gesproken woord precies probeert te behouden.
Ondertitels vertalen zonder de timing te verliezen
Vertalen wordt makkelijker zodra je het ondertitelbestand niet meer als een gewoon document behandelt. Elke cue heeft al een starttijd, eindtijd en een beperkt leesvenster. De vertaling moet binnen dat venster passen, niet andersom.
Zet eerst de cuevensters vast
Laad het SRT- of WebVTT-bestand en houd de tijdstempels vast. SRT gebruikt een volgnummer, een begin- en eindtijdstempel en een of twee regels tekst. WebVTT gebruikt dezelfde basale logica van getimede cues, met tijdstempels gescheiden door punten in plaats van komma's zoals beschreven in deze gids over ondertitelformaten. De structuur is belangrijk omdat de timing de ondertitels gesynchroniseerd houdt.
Als een cue na de vertaling te lang is, kort je de formulering in of splits je de gedachte over twee cues. Is hij te kort, dan kun je wat ademruimte laten zodat de regel niet ongewoon snel voorbijflitst. Het belangrijkste is dat de oorspronkelijke timing stabiel blijft terwijl de tekst verandert.
Vertaal binnen het venster, niet erbuiten
Een leesbare ondertitelvertaling behoudt de betekenis zonder de kijker te dwingen het scherm opnieuw te lezen. Dat betekent zinsdelen vereenvoudigen, opvulling schrappen en het tekenbudget respecteren dat je in de vorige sectie al hebt gecontroleerd. Het betekent ook dat je het spelersformaat in het oog houdt, want sommige systemen verkiezen WebVTT terwijl andere SRT-sidecars verwachten.
Voor teams die sneller willen werken, kan een workflow die video's vertaalt met AI helpen om een eerste versie te maken, maar de timing heeft nog steeds een menselijke controle nodig vóór de export. Bij die controle vang je regels die technisch goed vertalen maar ongemakkelijk in het cuevenster vallen.
Voor een op Japans gerichte ondertitelopbouw is de YouTube subtitle generator voor Japanse clips een van de praktische routes die de timingstructuur zichtbaar houdt terwijl je werkt.
{% youtube id="VpDRJT0vSH8" /%}
Een tool kiezen die goed met Japans omgaat
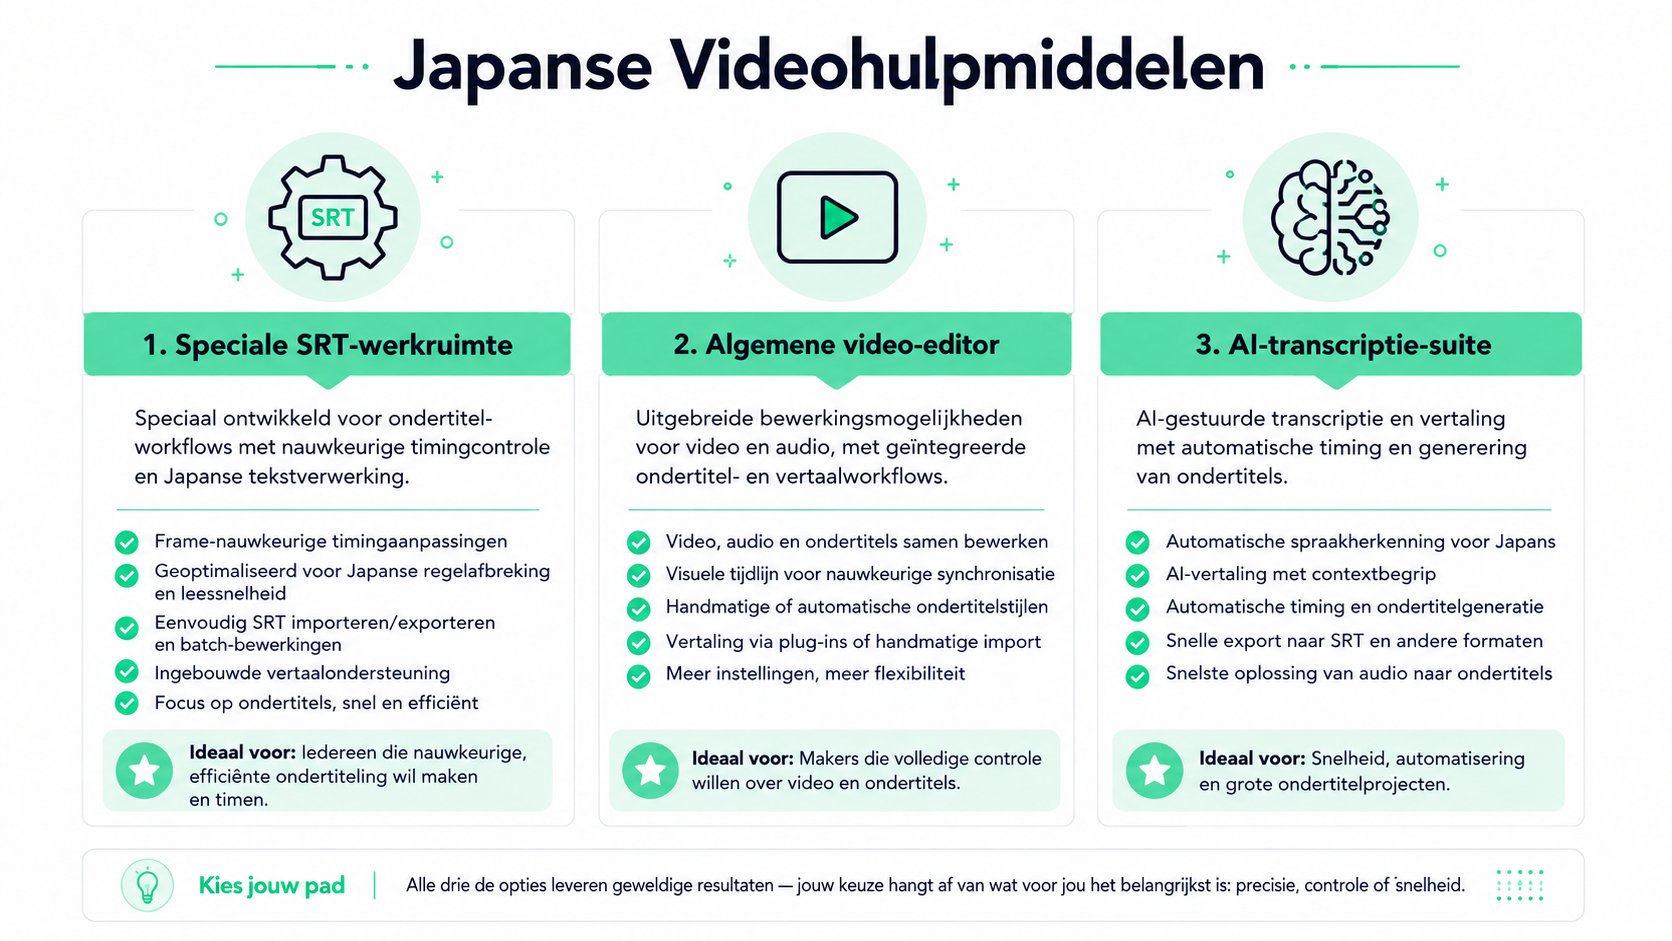
Drie toolpaden duiken steeds weer op voor video in het Japans. Het ene is een toegewijde transcriptiewerkruimte die getimede tekst bewerkbaar houdt. Het andere is handmatig ondertitelen in een algemene videobewerker. Het derde is een bredere AI-tool die transcriptie, vertaling en inbranden op één plek probeert te doen.
Stem de tool af op het eindproduct
Een toegewijde werkruimte is het meest logisch wanneer je SRT- of VTT-uitvoer nodig hebt, bewerkbare cues en een Japansbewuste opschoning. Dat is het pad dat mensen gebruiken wanneer ondertitels stroomafwaarts herbruikbaar moeten blijven, niet alleen één keer op één platform goed moeten uitzien.
Handmatig ondertitelen heeft nog steeds een plek. Het werkt goed voor korte clips, vooral wanneer een vloeiende reviewer ernaast zit en de regels met de hand kan timen. Het probleem is de inspanning, niet de theorie. Per regel tellen en timen wordt snel vervelend zodra de clip langer wordt.
Algemene AI-tools kunnen nuttig zijn voor ruwe concepten. Ze kunnen ook de timingstructuur afvlakken of de details verbergen die belangrijk zijn voor de Japanse leesbaarheid. Dat betekent dat je nog steeds zelf de regellengte, cueduur en het gedrag van leestekens controleert.
Gebruik de tool die het minste opruimwerk achterlaat
De beste beslisregel is simpel. Kies de werkruimte wanneer je bewerkbare ondertitels en Japans-specifieke QC nodig hebt. Kies handmatig ondertitelen wanneer de clip kort is en er een mens beschikbaar is. Kies een algemene AI-tool wanneer een concept voldoende is en je toch al verwacht het bestand later te herwerken.
Een webgebaseerde optie zoals Japanse ondertitelgenerator quso.ai kan handig zijn wanneer je snel een ondertitelronde wilt voor vergelijking, maar je moet de timing nog steeds zelf controleren als het uiteindelijke bestand leesbaar moet blijven. Dat is normaal. Japanse getimede tekst is kieskeurig, en de tool zou je de structuur moeten laten zien in plaats van die te verbergen.
Een herhaalbaar proces dat je kunt hergebruiken
Een goed Japans videoproces wordt makkelijker zodra je ophoudt alles vanaf nul te beslissen. Dezelfde volgorde werkt steeds opnieuw, of je nu een webinar, een lezing, een interview of een socialclip verwerkt.
Houd de volgorde vast
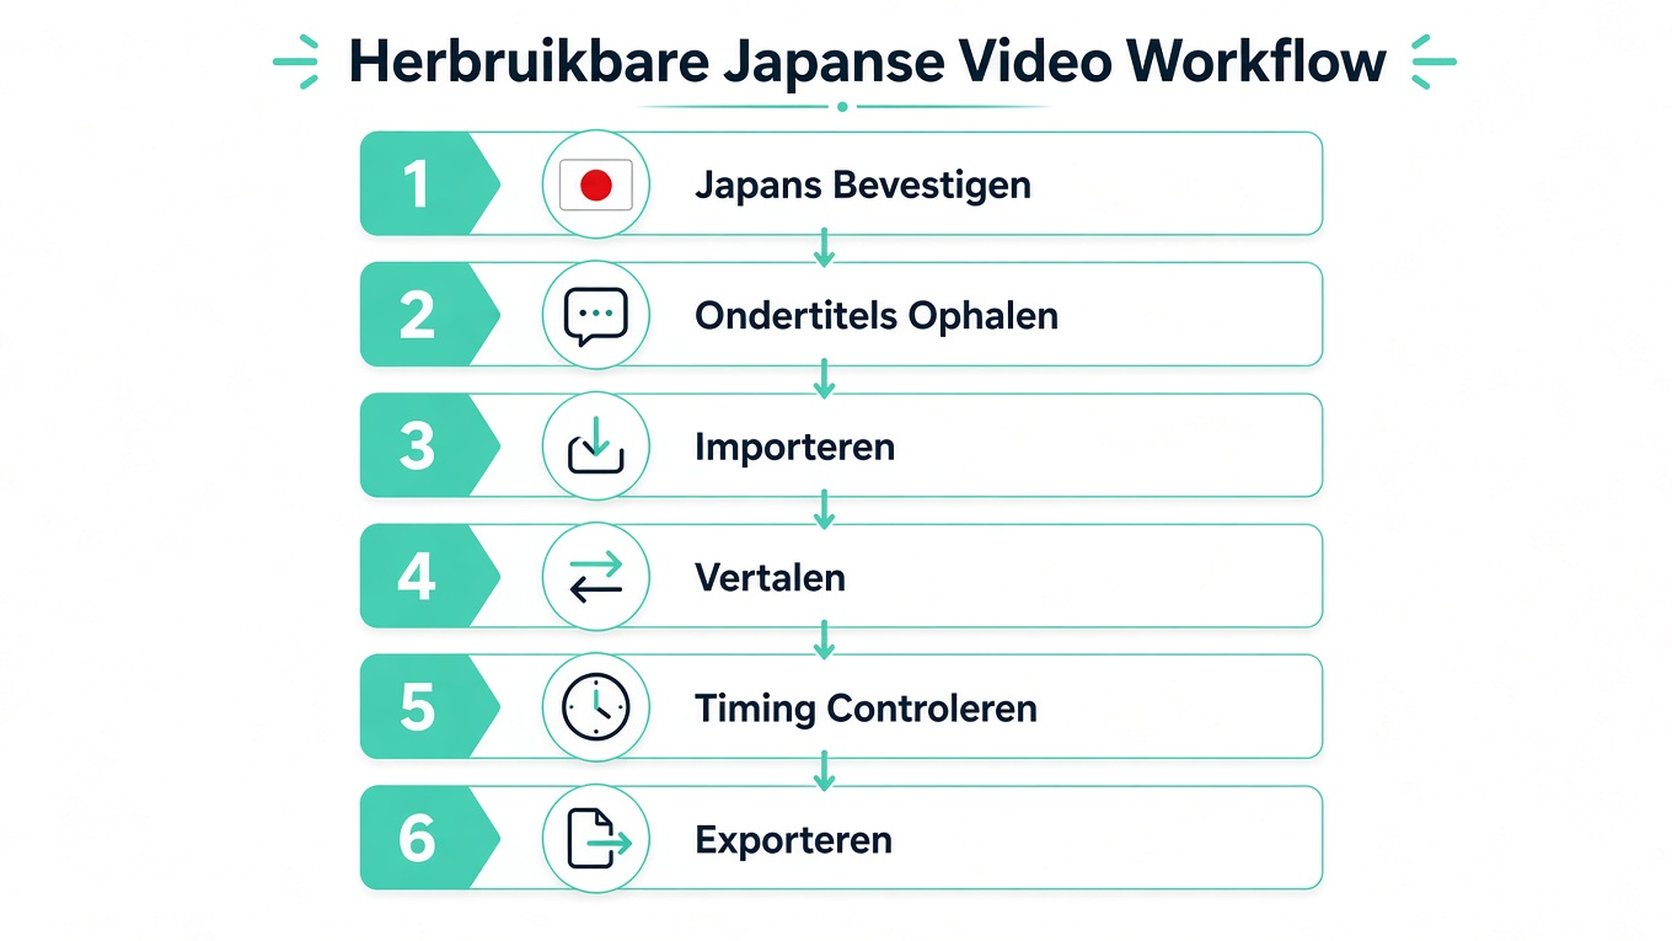
Begin met het bevestigen van Japans via metadata of een kort audiofragment. Haal vervolgens bestaande ondertitels op als die beschikbaar zijn, of voer ASR uit op schone audio als dat niet het geval is. Importeer de cues in een editor die rekening houdt met regels voor tekendichtheid, vertaal binnen het oorspronkelijke cuevenster en exporteer in het formaat dat de speler verwacht.
Voer na de export nog een laatste controle uit op half-width drift, romaji die doorsijpelt en te lange regels. Dat zijn de kleine Japans-specifieke problemen die de eerste opschoning vaak overleven, tenzij je er bewust naar zoekt.
Een eenvoudige rolverdeling helpt:
- Automatisering doet: taalherkenning, eerste transcriptie en conceptvertaling.
- Menselijke controle doet: cues strakker maken, culturele formuleringen en laatste timingcontroles.
- Exportlogica doet: SRT- of WebVTT-uitvoer, afhankelijk van de speler van bestemming.
De workflow voor video transcriberen past goed in dat patroon, omdat het transcript, tijdstempels en exportopties op één plek houdt. Dat maakt het volgende Japanse bestand makkelijker om te starten, omdat je een proces hergebruikt in plaats van er een te bedenken.
Als je nu met Japanse videoclips bezig bent, biedt transcript.im een manier om transcripts op te halen uit openbare links of uploads, tijdstempels intact te houden en die tekst naar vertaling of ondertitelopschoning te verplaatsen zonder het hele bestand handmatig opnieuw op te bouwen. Bezoek Transcriberen en probeer de workflow op je volgende Japanse video, vooral als je schone, herbruikbare getimede tekst nodig hebt in plaats van nog een ruwe versie.
Transcriberen
Zet elke video om in tekst
Plak een YouTube-, TikTok- of Instagram-link en lees het transcript, met tijdstempels op elke regel.
Exporteert als TXT, SRT of VTT.