
REST API
API di trascrizione per video e audio
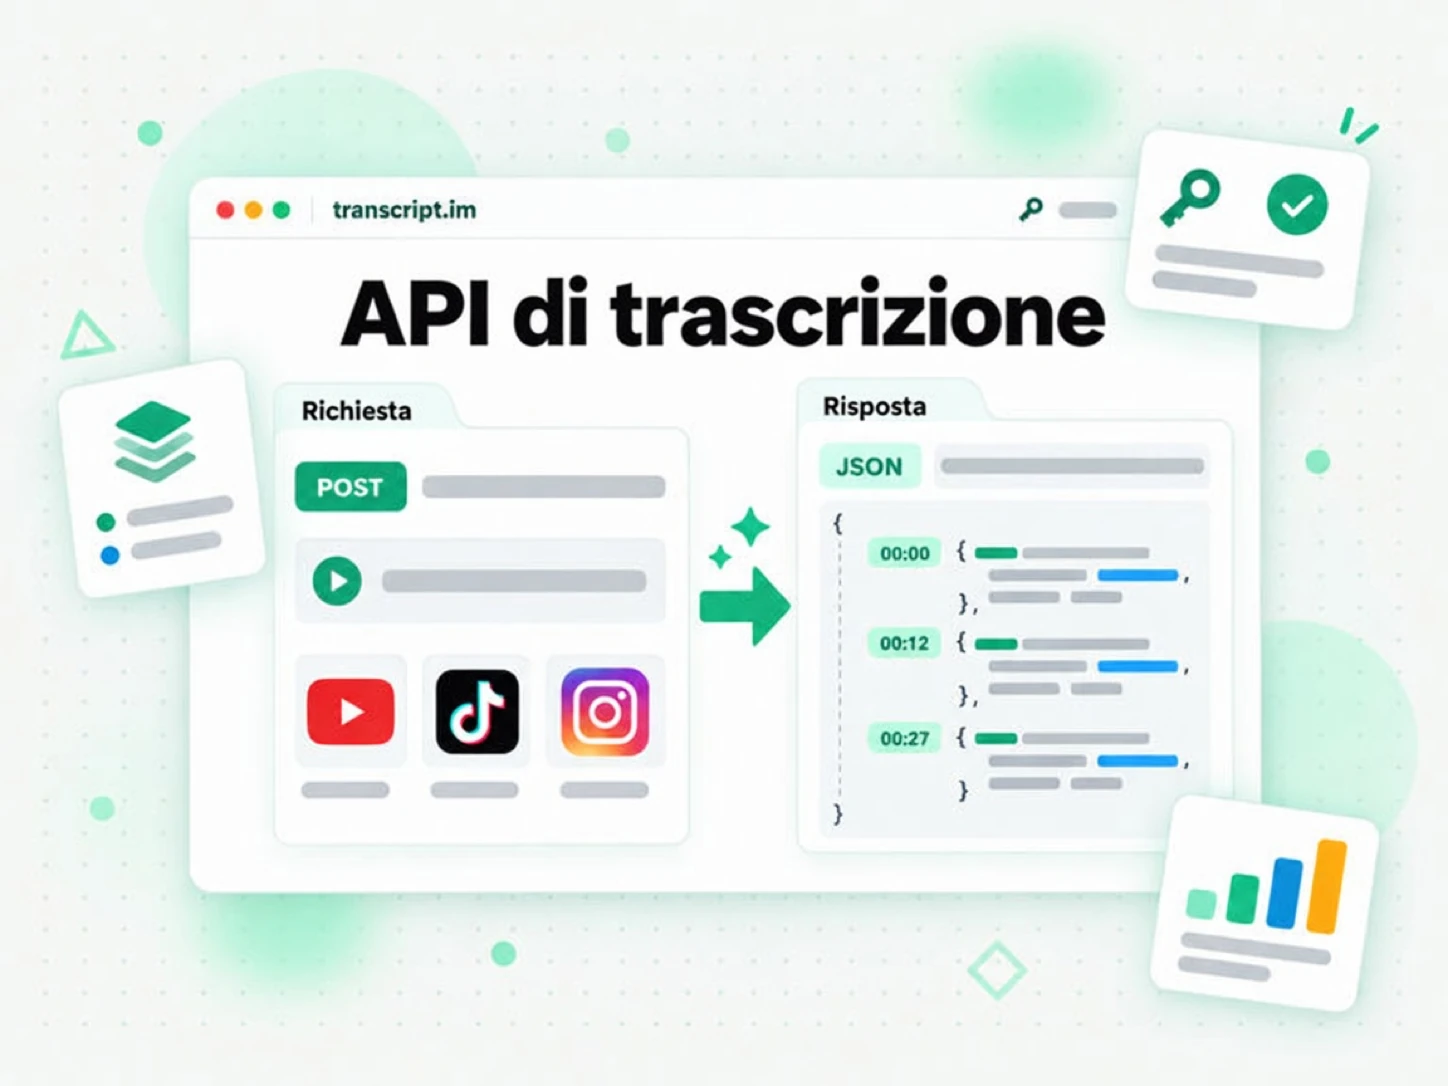
transcript.im espone come API versionata la stessa pipeline di estrazione che alimenta il prodotto. Invia un URL di video o audio e ricevi testo con timestamp, in JSON o testo semplice, con la piattaforma rilevata per te. I sottotitoli esistenti vengono usati per primi; quando un video non ne ha, l'IA trascrive l'audio e il risultato viene consegnato in modo asincrono.
- Un solo
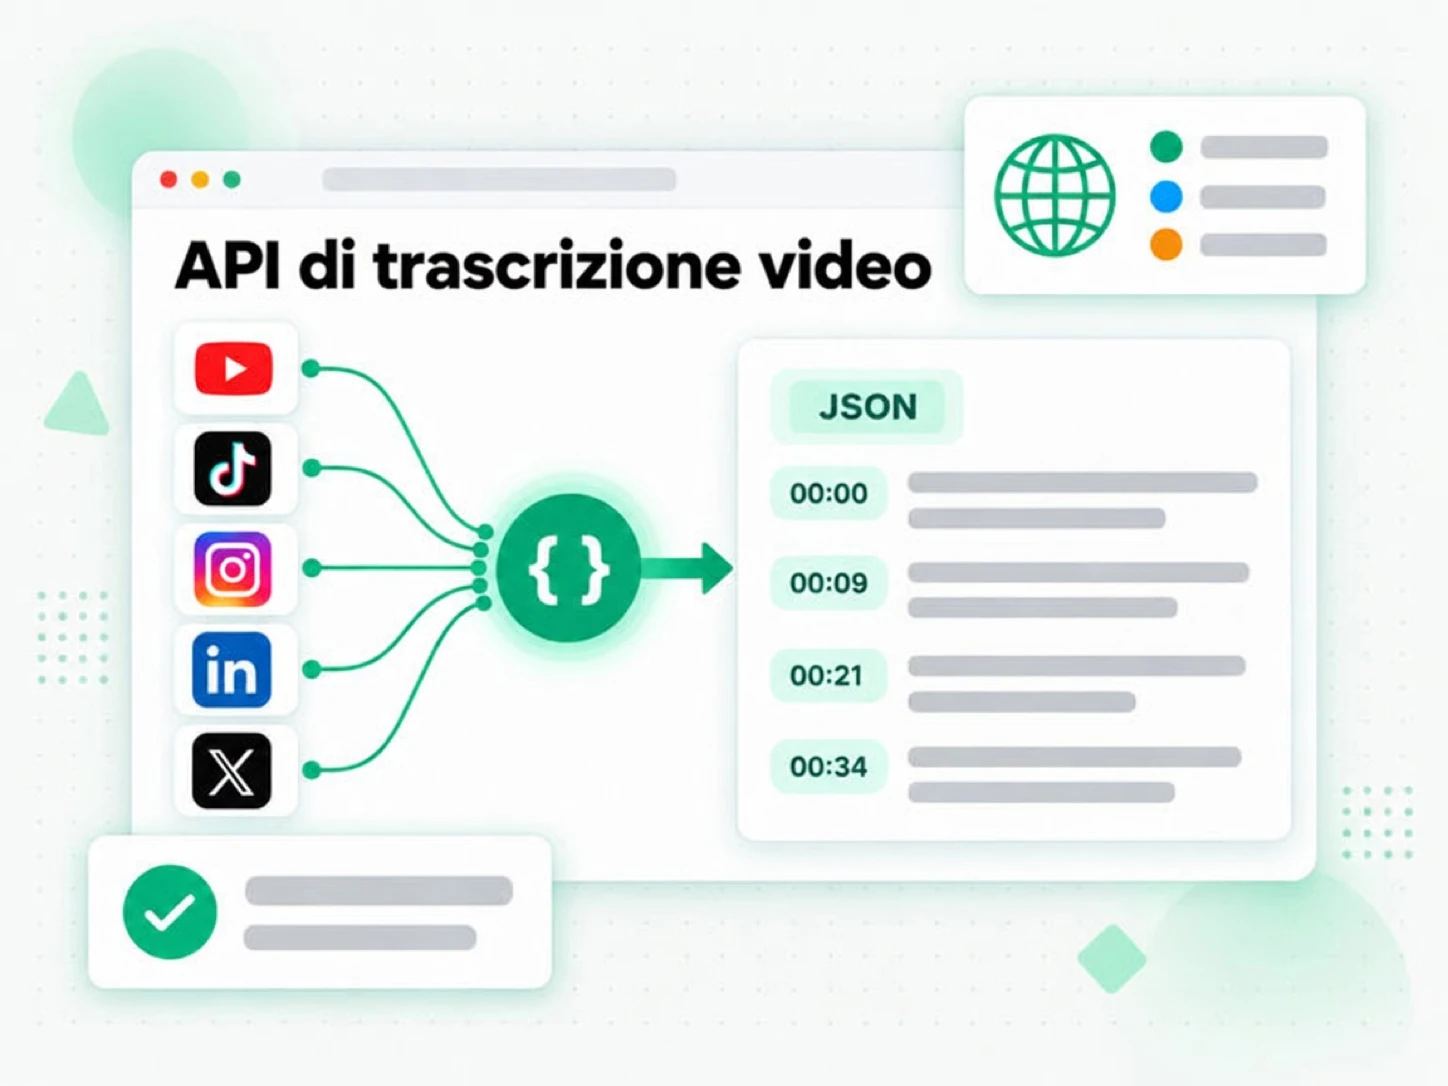
urlaccetta un link completo o breve e rileva YouTube, TikTok, Instagram, LinkedIn e Twitter/X; per YouTube viene riconosciuto anche un id video nudo, eplatformconexternalIdcoprono una fonte che già conosci. - I sottotitoli vengono usati per primi; quando un video non ne ha, l'IA trascrive l'audio, e un file locale caricato passa sempre dal riconoscimento vocale.
format=jsonrestituisce segmenti con timestamp, mentreformat=textrestituisce testo semplice pronto da incollare.- L'estrazione in batch copre elenchi di URL, playlist e canali.
- L'esportazione in batch copre txt, csv, json, srt, vtt e zip; una trascrizione salvata si scarica come txt, srt, vtt, json o md.
- Le trascrizioni salvate vivono nella libreria dell'account, e il rilevamento YouTube copre ricerca, video, canali, caricamenti, playlist e sottotitoli.
- Il contratto completo è pubblicato come documento OpenAPI.
Cosa fa l'API di transcript.im
L'API di transcript.im trasforma un link pubblico di video o audio in una trascrizione con timestamp che il tuo prodotto può leggere, archiviare, cercare o passare a un modello. Tu invii un URL; l'API risolve la piattaforma, cerca la traccia di sottotitoli già presente del creator e restituisce il testo scritto con un timestamp su ogni riga. Quando un video non ha alcun sottotitolo, l'API non si ferma a un errore: ripiega sulla trascrizione IA dell'audio parlato, così la stessa richiesta produce comunque testo.
- Una richiesta, testo reale: risolvi un link e restituisci segmenti di trascrizione con timestamp o testo semplice.
- Prima i sottotitoli, poi l'IA: usa la traccia del creator quando esiste, trascrivi l'audio quando non esiste.
- Asincrono per impostazione predefinita per l'ASR: un job id ti consente di interrogare una trascrizione lunga senza bloccare.
- Consapevole della lingua: richiedi una priorità di lingua e rileggi la lingua che l'API ha risolto.
- Indipendente dalla piattaforma: chi chiama non deve sapere dove è ospitato il video.
Una API di trascrizione per cinque piattaforme
YouTube
Trascrizioni per qualsiasi video pubblico di YouTube, Short o registrazione in diretta, usando prima i sottotitoli del creator e la trascrizione IA quando mancano. YouTube è anche la piattaforma con una superficie di rilevamento completa — ricerca, video, canali, caricamenti, playlist e sottotitoli — disponibile accanto alla trascrizione stessa. L'arretrato di un canale o una playlist diventa un batch di trascrizioni con timestamp, mentre un singolo link torna come testo leggibile che puoi cercare.
TikTok
Trascrizioni per video pubblici di TikTok, con i sottotitoli usati per primi e il riconoscimento vocale come ripiego. Incolla un link video e leggi il contenuto parlato come testo pulito e con timestamp che puoi riutilizzare, tradurre o citare. La stessa chiamata copre una clip breve e un caricamento più lungo, quindi un trend, un tutorial e un video di qualcuno che parla in camera tornano tutti come testo.
Trascrizioni per Reel e post video pubblici di Instagram. Instagram non ha una traccia di sottotitoli da leggere, quindi l'estrazione è riconoscimento vocale asincrono: invia il link, interroga il job e raccogli il testo quando è pronto. Così un Reel diventa citabile e cercabile anche se la piattaforma non ha mai pubblicato le sue parole come testo.
Trascrizioni per post video pubblici di LinkedIn, con i sottotitoli usati per primi e il riconoscimento vocale come ripiego. Il risultato torna con timestamp, quindi un intervento, una clip di prodotto o una riunione registrata diventa testo cercabile che puoi citare e riutilizzare. Estrai l'argomentazione dalla registrazione di un webinar o trasforma l'aggiornamento di un fondatore in una bozza che puoi modificare.
Twitter/X
Trascrizioni per post video pubblici di X. X non ha una traccia di sottotitoli da leggere, quindi l'estrazione passa dal riconoscimento vocale asincrono: invia il link, interroga il job e raccogli testo con timestamp che puoi cercare. Cita un video con precisione o archivia il suo contenuto parlato prima che il post venga modificato o rimosso.
Come scorre una richiesta di trascrizione
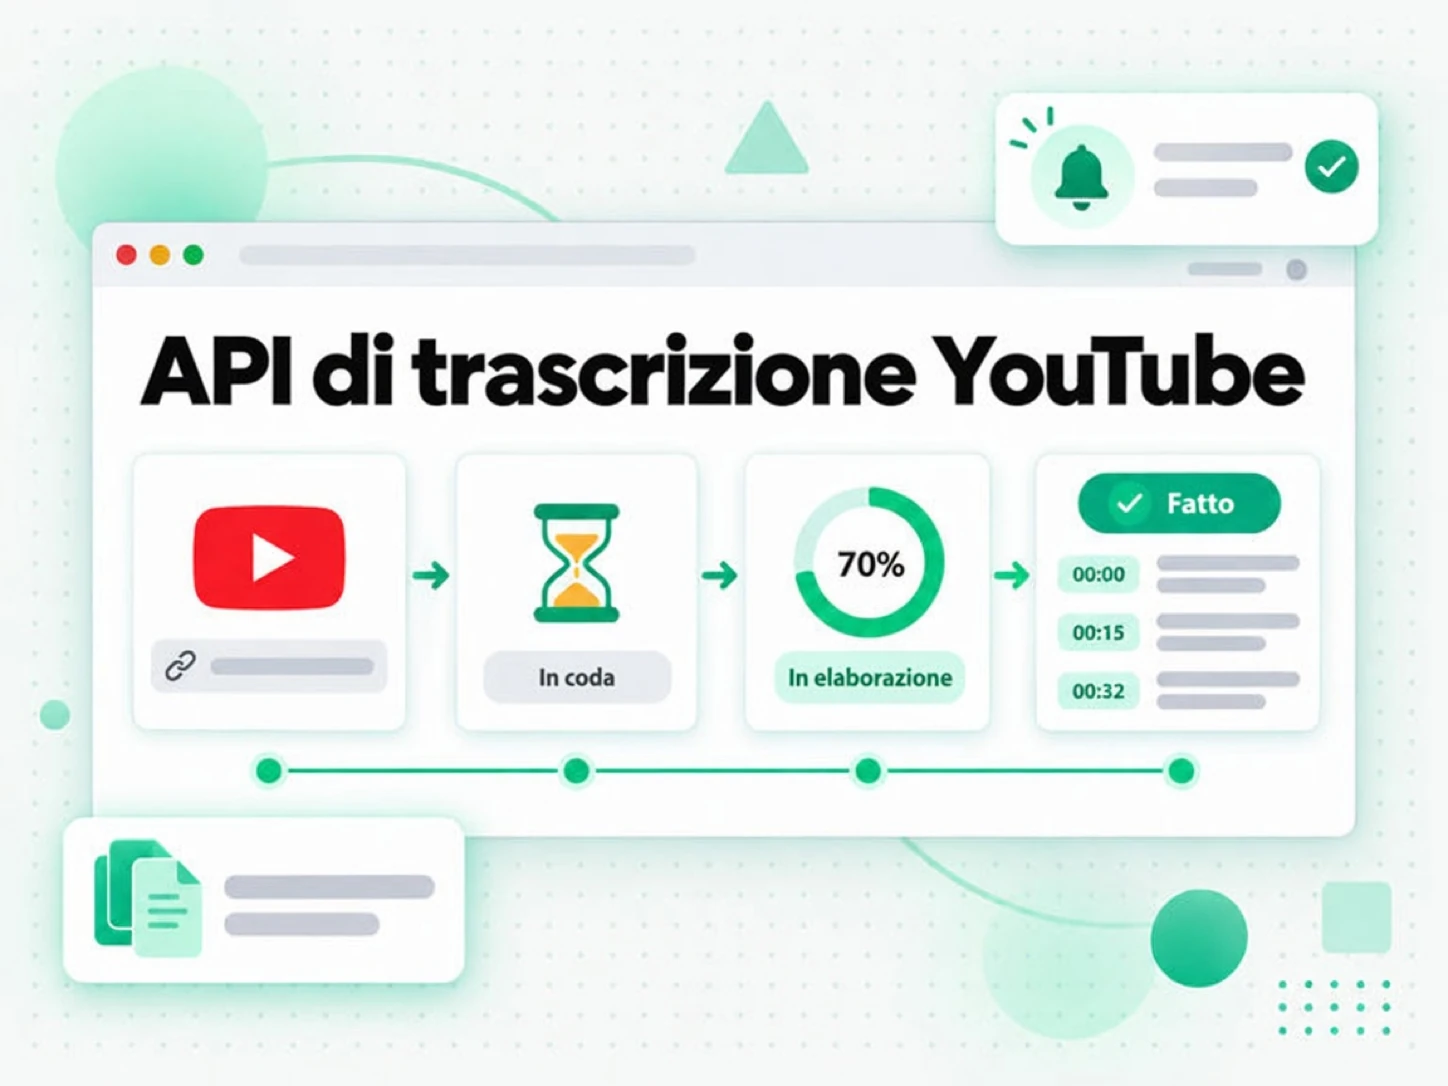
Una sola chiamata porta un link o un file caricato dall'input alla trascrizione, e l'API ti dice quale percorso ha seguito.
- Invia la fonte: pubblica un
url, passaplatformedexternalIdquando già li conosci, oppure carica un file comemultipart/form-dataverso lo stesso endpoint. - Ottieni una corrispondenza di sottotitoli: quando il video porta sottotitoli in una lingua della tua lista, la trascrizione torna nella risposta.
- Gestisci una lingua mancante: quando esistono sottotitoli ma nessuno corrisponde alla tua lista, la richiesta prosegue verso la trascrizione IA e restituisce
202con un job id; un404conavailableLanguagesviene restituito solo quando il riconoscimento vocale non è consentito per chi chiama. - Forza l'ASR o ripiega su di esso: una voce
asresplicita, un video senza alcuna traccia di sottotitoli o un file caricato avvia un job ASR e restituisce un job id. - Interroga o ricevi in streaming: leggi il job con
GET /v1/transcript/job/{id}finché non riesce o fallisce, oppure iscriviti al suo stream/eventsper il progresso lato server. Una query di job restituisce200anche per un job fallito, quindi dirama sul campostatus. - Leggi il risultato: una trascrizione finita porta la lingua risolta, la durata, i segmenti con timestamp e, su richiesta, metadati come titolo, autore e data di pubblicazione.
- Ripeti in sicurezza: una trascrizione già estratta viene servita dalla cache invece di avviare un nuovo job, quindi la stessa fonte può essere richiesta di nuovo.
- Ispeziona prima:
GET /v1/transcript/inforisolve una fonte ed elenca le lingue che può servire prima che ti impegni in un'estrazione.
202 con un job id, e una risorsa davvero assente o un ripiego non consentito restituisce 404. Ogni percorso restituisce la stessa forma di trascrizione una volta che il testo è pronto.Estrazione in batch ed esportazioni
I carichi di lavoro reali raramente si fermano a un solo video, quindi l'API accetta un batch come elenco di URL, playlist o canale. Ogni batch tiene i propri totali — quanti elementi sono in attesa, quanti hanno avuto successo e quanti sono falliti — e restituisce gli elementi pagina per pagina, così un canale lungo non arriva come un unico payload enorme.
- Tre forme di batch:
POST /v1/batchaccetta un elenco di URL, una playlist o un canale, in base al corpo che invii. - Stato indipendente: un link fallito viene contrassegnato da solo e non scarta mai il resto del batch; gli elementi falliti possono essere riprovati con
/retry. - Elementi paginati: leggi il batch con
GET /v1/batch/{batchId}, poi segui il token di pagina restituito per gli elementi rimanenti. - Progresso in tempo reale: ogni interrogazione restituisce conteggi aggiornati, così chi chiama può mostrare quanto di un'esecuzione lunga è finito.
- Esporta nel tuo formato: scarica un batch finito da
/exportcometxt,csv,json,srt,vttozip.
srt e vtt entrano direttamente in un editor o in un player. Per un archivio, csv, json e zip mantengono un'intera libreria di registrazioni cercabile come un unico corpus. I formati si allineano alle risposte della singola trascrizione, quindi un consumatore che gestisce un risultato sa già leggere un batch.Trascrizioni salvate nella libreria dell'account
Estrazione e archiviazione sono cose separate: una trascrizione entra a far parte della libreria dell'account quando viene salvata, e la libreria è il luogo in cui la leggi, cerchi, scarichi e rimuovi in seguito senza rieseguire l'estrazione.
- Elenca i contenuti salvati:
GET /v1/library/transcriptsscorre pagina per pagina le trascrizioni dell'account, i record dei batch e le righe dello storico dei fallimenti, con ricerca, filtri per piattaforma e lingua e ordinamento. - Leggi un elemento:
GET /v1/library/transcripts/{platform}/{externalId}restituisce una trascrizione salvata per piattaforma e id esterno, o per la lingua che indichi. - Scarica: la rotta
/downloadesporta una trascrizione salvata cometxt,srt,vtt,jsonomd. - Contenuti correlati: la rotta
/relatedelenca altri elementi salvati dello stesso canale. - Rimuovi:
DELETEtoglie un elemento dalla libreria senza toccare la copia di nessun altro. - Letture limitate all'account: una richiesta alla libreria restituisce solo ciò che l'account ha salvato e non avvia mai una nuova estrazione, quindi rivedere una trascrizione salvata è una lettura, non un altro job.
Rilevamento YouTube oltre le trascrizioni
YouTube è la piattaforma in cui l'API risponde anche alle domande attorno a una trascrizione, usando gli stessi nomi di risorsa della YouTube Data API.
- Ricerca:
GET /v1/youtube/searchtrova video, canali o playlist per query e restituisce risultati paginati a cursore. - Video:
GET /v1/youtube/videosrestituisce i dettagli di un video, inclusa la disponibilità di sottotitoli. - Canali:
GET /v1/youtube/channelsrisolve un canale per id o@handle. - Caricamenti di un canale:
GET /v1/youtube/channels/{channelId}/videospercorre i caricamenti di un canale. - Elementi di una playlist:
GET /v1/youtube/playlists/{playlistId}/itemspercorre una playlist. - Sottotitoli:
GET /v1/youtube/captionsrestituisce i metadati della traccia di sottotitoli e il testo dei sottotitoli di un video. Non avvia mai un job di riconoscimento vocale: quando segnalarequiresAsync, chiamaPOST /v1/transcriptper eseguire la trascrizione.
Costruita per la produzione
La superficie è piccola di proposito, e le parti che contano per un servizio sono documentate invece che indovinate.
- Una sola credenziale: autenticati con una chiave API inviata come token Bearer, oppure con
X-API-Keyda uno script o un server. - Chiavi con scope: concedi solo gli scope di cui chi chiama ha bisogno, con
transcriptsebatchesche coprono estrazione e lavoro in batch. - Errori strutturati: i fallimenti di estrazione e validazione restituiscono un oggetto di errore con un
codestabile e unmessageleggibile; le risposte di autenticazione (401) e di limite di frequenza (429) usano un corpo di errore piatto più semplice. - Limiti utili: una richiesta limitata per frequenza restituisce
429conRetry-After, e le risposte riuscite portano headerX-RateLimit-*così un client può arretrare correttamente. - Un contratto pubblicato: il documento OpenAPI completo sostiene l'API, quindi puoi generare un client, simulare un server o validare risposte reali rispetto allo schema.
- Un fratello per gli agenti: lo stesso account e gli stessi strumenti sono raggiungibili dal server MCP di transcript.im se chi chiama è un client IA invece di un servizio.
Correlati
Domande frequenti sull'API di trascrizione
Cos'è l'API di transcript.im?
L'API di transcript.im è una superficie REST che trasforma un link pubblico di video o audio in una trascrizione con timestamp, usando prima i sottotitoli esistenti e la trascrizione IA quando un video non ne ha.
Quali piattaforme supporta l'API di transcript.im?
Estrae trascrizioni da YouTube, TikTok, Instagram, LinkedIn e Twitter/X rilevando la piattaforma dal link che invii. YouTube, TikTok e LinkedIn usano prima i sottotitoli con il riconoscimento vocale come ripiego; Instagram e X non hanno traccia di sottotitoli e passano direttamente al riconoscimento vocale.
Cosa succede quando un video non ha sottotitoli?
Quando un video non ha alcuna traccia di sottotitoli, l'API avvia un job ASR e restituisce un job id; interroghi quel job finché la trascrizione è pronta, quindi la richiesta non si blocca mai sul riconoscimento vocale.
Posso trascrivere un file audio o video locale?
Sì. POST /v1/transcript accetta un corpo multipart/form-data con una parte file invece di un URL. Un file caricato va direttamente al riconoscimento vocale, quindi restituisce un job 202 — oppure un risultato 200 se termina entro il budget di attesa.
L'API di transcript.im può restituire timestamp con il testo?
Sì. Le risposte JSON portano segmenti con timestamp e le risposte di testo possono mantenere un prefisso di timestamp per riga, così puoi tornare al momento in cui è stata detta una frase.
Come richiedo una trascrizione in una lingua specifica?
Invia un elenco di priorità delle lingue separato da virgole, incluse le voci asr e asr-<code>. Una corrispondenza di sottotitoli viene restituita direttamente; quando esistono sottotitoli ma nessuno corrisponde all'elenco, la richiesta prosegue verso la trascrizione IA e restituisce un job 202, e un 404 con le lingue disponibili viene restituito solo quando il riconoscimento vocale non è consentito.
Come faccio a sapere quando una trascrizione asincrona è pronta?
Interroga GET /v1/transcript/job/{id} con la stessa credenziale finché non segnala successo o fallimento, oppure iscriviti a GET /v1/transcript/job/{id}/events per aggiornamenti lato server. Una query di job restituisce 200 anche quando il job è fallito, quindi leggi i campi status ed error invece del codice HTTP.
L'API di transcript.im supporta l'estrazione in batch?
Sì. Un batch accetta un elenco di URL, una playlist o un canale, segue lo stato di ogni elemento e restituisce gli elementi pagina per pagina.
Quali formati di esportazione posso scaricare?
Un batch finito si esporta come txt, csv, json, srt, vtt o zip; una singola trascrizione salvata si scarica come txt, srt, vtt, json o md.
Dove vivono le trascrizioni salvate?
La libreria dell'account è il luogo in cui vivono le trascrizioni salvate e i record dei batch, sotto /v1/library. Espone rotte di elenco, lettura, download, correlati ed eliminazione, e le sue letture sono limitate all'account e non avviano mai una nuova estrazione.
Cosa restituisce l'endpoint dei sottotitoli YouTube?
GET /v1/youtube/captions restituisce i metadati della traccia di sottotitoli di un video insieme al testo dei sottotitoli. Non avvia mai un job di riconoscimento vocale; quando segnala requiresAsync, chiama POST /v1/transcript per eseguire la trascrizione.
Come segnala l'API di transcript.im errori e limiti di frequenza?
Gli errori di estrazione e validazione usano un oggetto con code e message; l'autenticazione restituisce un 401 piatto, e il limite di frequenza restituisce un 429 piatto con Retry-After più header X-RateLimit-* così un client può arretrare correttamente.
Aggiungi trascrizioni al tuo prodotto
Crea una chiave API, invia un link video o un file locale e leggi la trascrizione come JSON o testo semplice.