
REST API
API transkrypcji dla wideo i audio
transcript.im udostępnia ten sam potok ekstrakcji, który napędza produkt, jako wersjonowane API transkrypcji. Wyślij URL wideo lub audio i otrzymaj tekst ze znacznikami czasu, w JSON lub jako zwykły tekst, z automatycznie wykrytą platformą. Najpierw wykorzystywane są istniejące napisy; gdy wideo ich nie ma, AI transkrybuje dźwięk, a wynik jest dostarczany asynchronicznie.
- Jeden
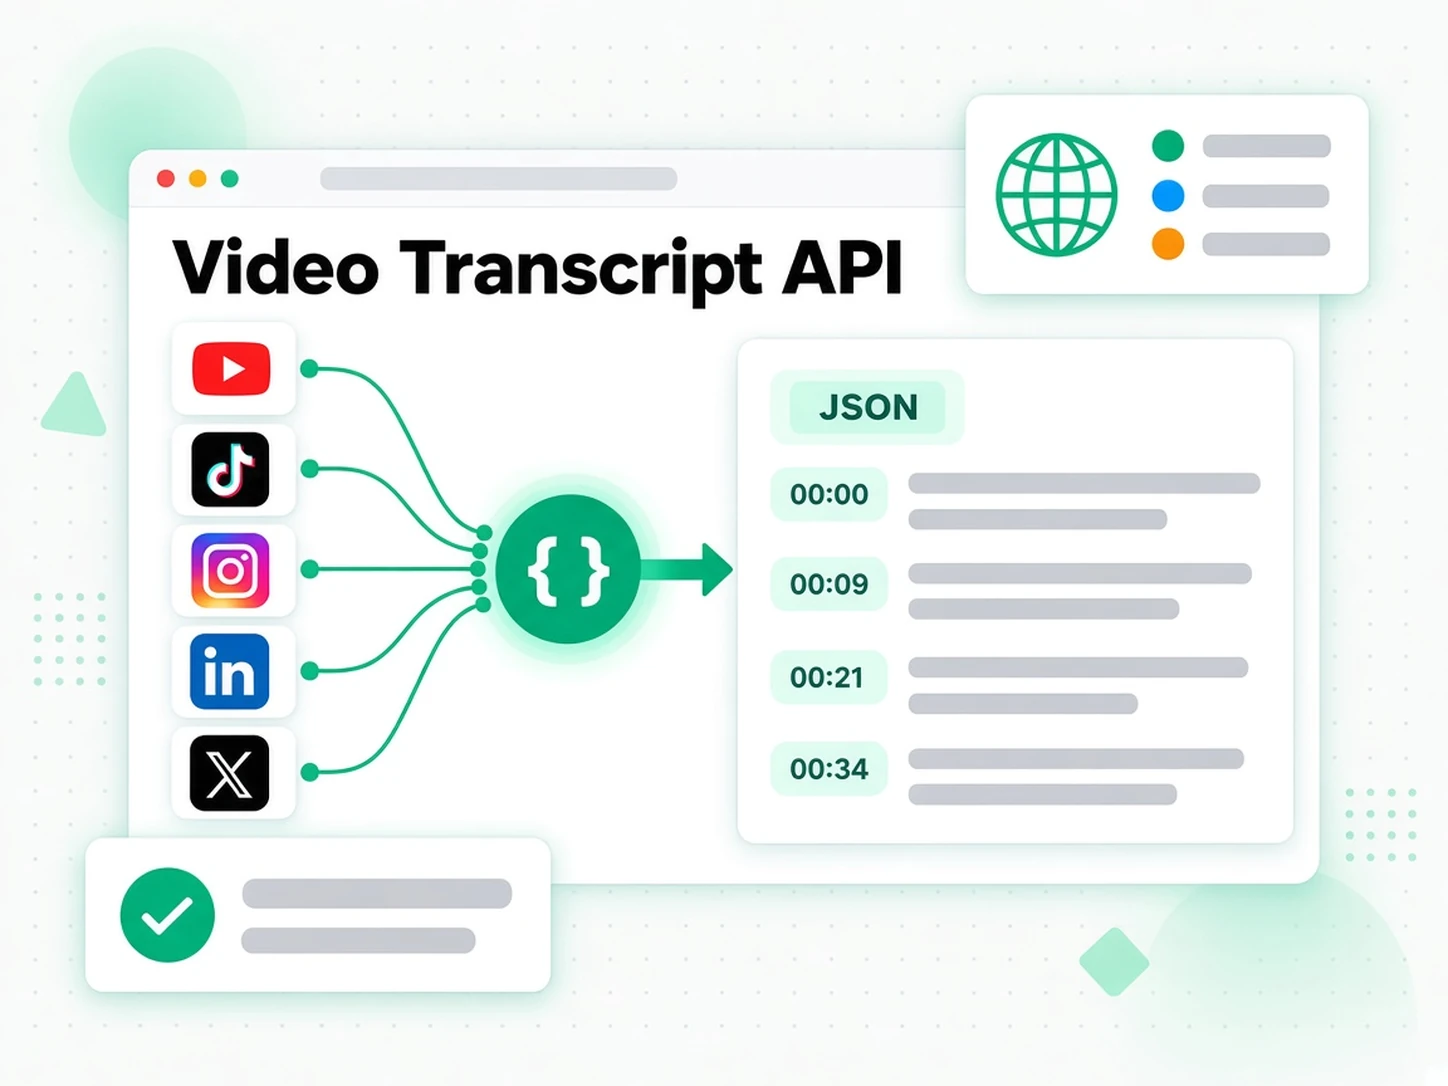
urlprzyjmuje pełny lub skrócony link i wykrywa YouTube, TikTok, Instagram, LinkedIn i Twitter/X; w przypadku YouTube rozpoznawane jest także samo video id, aplatformiexternalIdobsługują źródło, które już znasz. - Najpierw wykorzystywane są napisy; gdy wideo ich nie ma, AI transkrybuje mówiony dźwięk, a przesłany plik lokalny zawsze trafia do rozpoznawania mowy.
format=jsonzwraca segmenty ze znacznikami czasu, aformat=textzwraca zwykły tekst gotowy do wklejenia.- Ekstrakcja wsadowa obejmuje listy URL, playlisty i kanały.
- Eksporty wsadowe obejmują txt, csv, json, srt, vtt i zip; zapisana transkrypcja pobiera się jako txt, srt, vtt, json lub md.
- Zapisane transkrypcje znajdują się w Bibliotece konta, a wyszukiwanie w YouTube obejmuje wyszukiwanie, filmy, kanały, przesłane materiały, playlisty i napisy.
- Pełna specyfikacja jest opublikowana jako dokument OpenAPI.
Co robi API transcript.im
API transcript.im zamienia publiczny link do wideo lub audio w transkrypcję ze znacznikami czasu, którą Twój produkt może odczytać, zapisać, przeszukać lub przekazać do modelu. Wysyłasz URL; API rozpoznaje platformę, szuka istniejącej ścieżki napisów twórcy i zwraca zapisany tekst ze znacznikiem czasu w każdym wierszu. Gdy wideo nie ma żadnych napisów, API nie zatrzymuje się na błędzie — sięga po transkrypcję AI nagranego dźwięku, dzięki czemu to samo żądanie wciąż zwraca tekst.
- Jedno żądanie, prawdziwy tekst — rozpoznaj link i zwróć segmenty transkrypcji ze znacznikami czasu lub zwykły tekst.
- Najpierw napisy, potem AI — użyj ścieżki twórcy, gdy istnieje, a gdy jej nie ma, transkrybuj dźwięk.
- Domyślnie asynchronicznie dla ASR — identyfikator zadania pozwala odpytywać długą transkrypcję bez blokowania.
- Świadome języka — poproś o priorytet językowy i odczytaj język, który rozpoznało API.
- Niezależne od platformy — wywołujący nie musi wiedzieć, gdzie hostowane jest wideo.
Jedno API transkrypcji dla pięciu platform
YouTube
Transkrypcje dla dowolnego publicznego filmu YouTube, Shortsa lub nagrania na żywo, z napisami twórcy w pierwszej kolejności i transkrypcją AI, gdy napisów brakuje. YouTube to także platforma z pełnym zestawem funkcji wyszukiwania — wyszukiwanie, filmy, kanały, przesłane materiały, playlisty i napisy — dostępnych obok samej transkrypcji. Zaległości kanału lub playlista stają się partią transkrypcji ze znacznikami czasu, a pojedynczy link wraca jako czytelny tekst, który możesz przeszukać.
TikTok
Transkrypcje publicznych filmów TikTok z napisami używanymi w pierwszej kolejności i rozpoznawaniem mowy jako rozwiązaniem zapasowym. Wklej link do filmu i czytaj wypowiedzianą treść jako czysty tekst ze znacznikami czasu, który możesz wykorzystać ponownie, przetłumaczyć lub zacytować. To samo wywołanie obejmuje krótki klip i dłuższy materiał, więc trend, samouczek i nagranie typu talking-head wracają jako tekst.
Transkrypcje publicznych rolek Instagram i postów wideo. Instagram nie ma ścieżki napisów do odczytania, więc wyodrębnianie odbywa się przez asynchroniczne rozpoznawanie mowy: wyślij link, odpytuj zadanie i odbierz tekst, gdy będzie gotowy. Dzięki temu rolka staje się cytowalna i przeszukiwalna, mimo że platforma nigdy nie opublikowała jej słów jako tekstu.
Transkrypcje publicznych postów wideo LinkedIn, z napisami używanymi w pierwszej kolejności i rozpoznawaniem mowy jako rozwiązaniem zapasowym. Wynik wraca ze znacznikami czasu, więc prelekcja, klip produktowy lub nagrane spotkanie stają się przeszukiwalnym tekstem, który możesz zacytować i wykorzystać ponownie. Wyciągnij argument z nagrania webinarium albo zamień aktualizację założyciela w szkic, który możesz edytować.
Twitter/X
Transkrypcje publicznych postów wideo X. X nie ma ścieżki napisów do odczytania, więc wyodrębnianie odbywa się przez asynchroniczne rozpoznawanie mowy: wyślij link, odpytuj zadanie i odbierz tekst ze znacznikami czasu, który możesz przeszukać. Zacytuj film dokładnie lub zarchiwizuj jego wypowiedzianą treść, zanim post zostanie zedytowany lub usunięty.
Jak przebiega żądanie transkrypcji
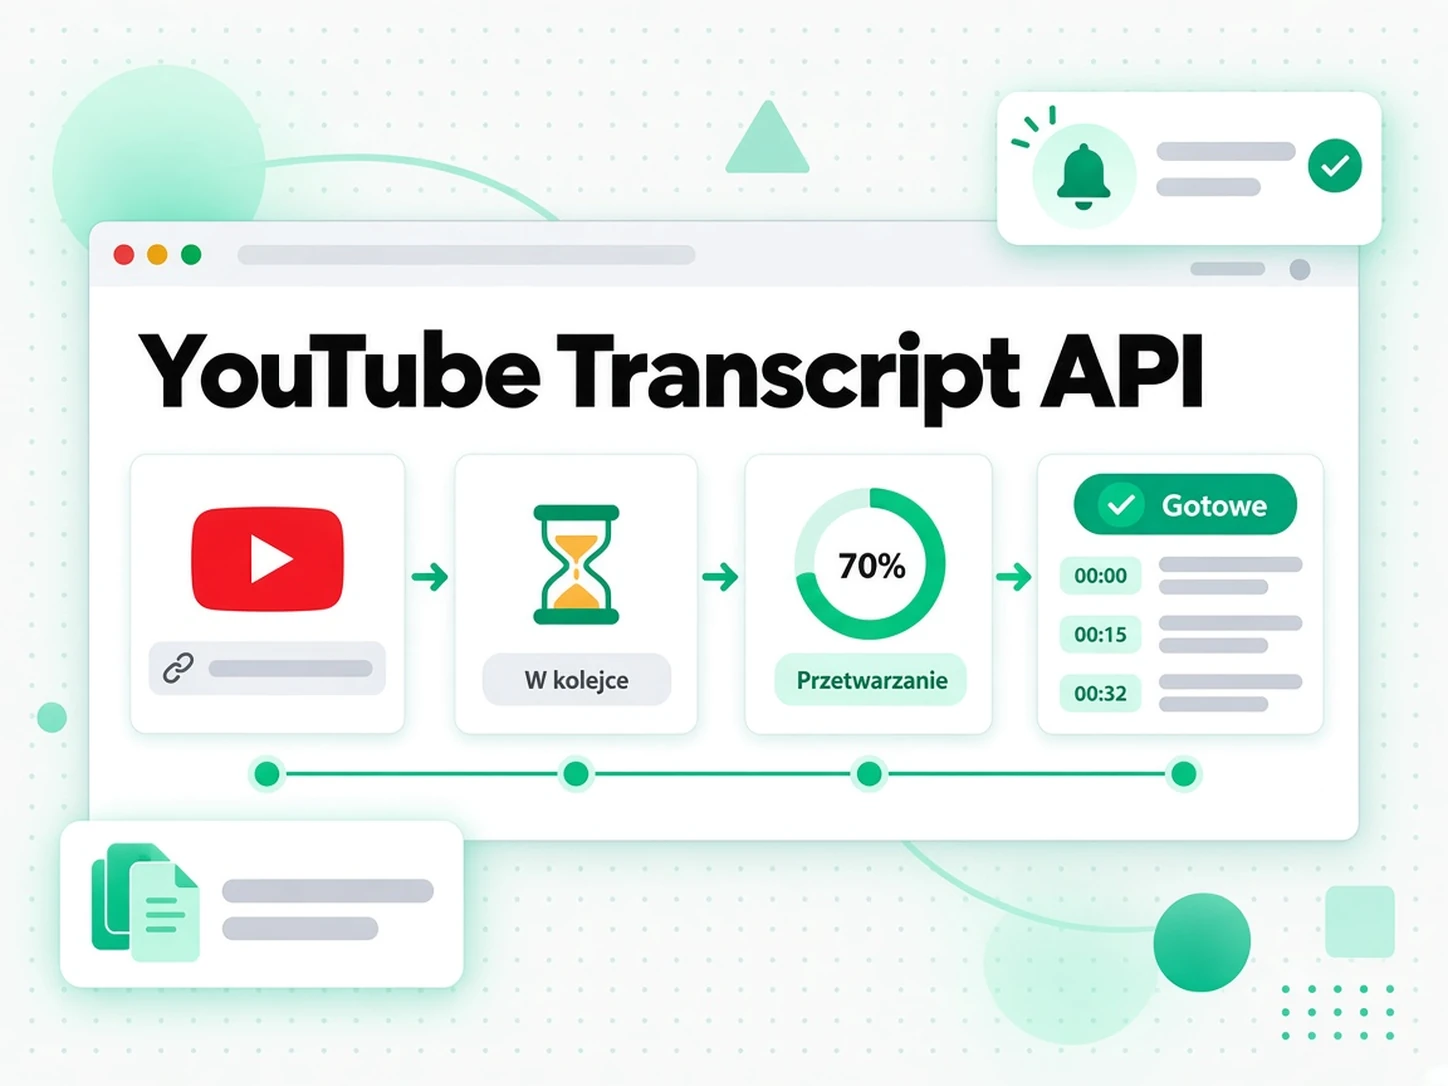
Pojedyncze wywołanie prowadzi link lub przesłany plik od danych wejściowych do transkrypcji, a API informuje, którą ścieżką poszło.
- Wyślij źródło — podaj
url, przekażplatformiexternalId, gdy już je znasz, albo prześlij plik jakomultipart/form-datado tego samego endpointu. - Uzyskaj dopasowanie napisów — gdy wideo zawiera napisy w języku z Twojej listy, transkrypcja wraca w odpowiedzi.
- Obsłuż brak dopasowania języka — gdy napisy istnieją, ale żadne nie pasują do Twojej listy, żądanie przechodzi do transkrypcji AI i zwraca
202z identyfikatorem zadania;404zavailableLanguagesjest zwracane tylko wtedy, gdy rozpoznawanie mowy nie jest dozwolone dla wywołującego. - Wymuś ASR lub skorzystaj z niego jako rozwiązania zapasowego — jawne wpisanie
asr, wideo bez żadnej ścieżki napisów lub przesłany plik uruchamia zadanie ASR i zwraca identyfikator zadania. - Odpytuj lub strumieniuj — czytaj zadanie za pomocą
GET /v1/transcript/job/{id}, aż się powiedzie lub nie, albo subskrybuj jego strumień/events, aby otrzymywać postęp wysyłany przez serwer. Zapytanie o zadanie zwraca200nawet dla nieudanego zadania, więc rozgałęziaj się na podstawie polastatus. - Odczytaj wynik — gotowa transkrypcja zawiera rozpoznany język, długość, segmenty ze znacznikami czasu, a na życzenie metadane, takie jak tytuł, autor i data publikacji.
- Powtarzaj bezpiecznie — transkrypcja, która została już wyodrębniona, jest pobierana z pamięci podręcznej zamiast uruchamiania nowego zadania, więc to samo źródło można zamówić ponownie.
- Najpierw sprawdź —
GET /v1/transcript/inforozpoznaje źródło i wyświetla języki, które może obsłużyć, zanim zdecydujesz się na wyodrębnienie.
202 z identyfikatorem zadania, a naprawdę brakujący zasób lub niedozwolone rozwiązanie zapasowe zwraca 404. Każda ścieżka zwraca ten sam kształt transkrypcji, gdy tekst jest gotowy.Wyodrębnianie wsadowe i eksporty
Rzeczywiste obciążenia rzadko kończą się na jednym filmie, więc API przyjmuje partię jako listę URL, playlistę lub kanał. Każda partia śledzi własne sumy — ile elementów oczekuje, ile się powiodło, a ile nie — i zwraca elementy po jednej stronie, więc długi kanał nie przychodzi jako jeden ogromny ładunek.
- Trzy kształty partii —
POST /v1/batchprzyjmuje listę URL, playlistę lub kanał, wybierane przez wysyłane ciało żądania. - Niezależny status — jeden nieudany link jest oznaczany osobno i nigdy nie odrzuca reszty partii; nieudane elementy można ponowić za pomocą
/retry. - Elementy stronicowane — odczytaj partię za pomocą
GET /v1/batch/{batchId}, a następnie podążaj za zwróconym tokenem strony, aby pobrać pozostałe elementy. - Postęp na żywo — każde odpytanie zwraca zaktualizowane liczby, więc wywołujący może pokazać, jaka część długiego przebiegu została ukończona.
- Eksportuj w swoim formacie — pobierz gotową partię z
/exportjakotxt,csv,json,srt,vttlubzip.
srt i vtt trafiają prosto do edytora lub odtwarzacza. W przypadku archiwum csv, json i zip utrzymują całą bibliotekę nagrań jako przeszukiwalny korpus. Formaty są zgodne z odpowiedziami dla pojedynczej transkrypcji, więc konsument obsługujący jeden wynik już wie, jak odczytać partię.Zapisane transkrypcje w bibliotece konta
Wyodrębnianie i przechowywanie są rozdzielone: transkrypcja staje się częścią biblioteki konta, gdy zostanie zapisana, a biblioteka to miejsce, w którym możesz ją później odczytać, przeszukać, pobrać i usunąć bez ponownego uruchamiania wyodrębniania.
- Wyświetl zapisaną zawartość —
GET /v1/library/transcriptsstronicuje transkrypcje konta, rekordy partii i wiersze historii niepowodzeń, z wyszukiwaniem, filtrami platformy i języka oraz sortowaniem. - Odczytaj jeden element —
GET /v1/library/transcripts/{platform}/{externalId}zwraca zapisaną transkrypcję według platformy i identyfikatora zewnętrznego lub w podanym języku. - Pobierz — trasa
/downloadeksportuje zapisaną transkrypcję jakotxt,srt,vtt,jsonlubmd. - Powiązana zawartość — trasa
/relatedwyświetla inne zapisane elementy z tego samego kanału. - Usuń —
DELETEusuwa element z biblioteki, nie naruszając kopii innych osób. - Odczyty w zakresie konta — żądanie biblioteki zwraca tylko to, co zapisało konto, i nigdy nie uruchamia nowego wyodrębniania, więc ponowne odwiedzenie zapisanej transkrypcji to odczyt, a nie kolejne zadanie.
Wyszukiwanie w YouTube poza transkrypcjami
YouTube to platforma, w której API odpowiada także na pytania wokół transkrypcji, używając tych samych nazw zasobów co YouTube Data API.
- Wyszukiwanie —
GET /v1/youtube/searchznajduje filmy, kanały lub playlisty według zapytania i zwraca wyniki stronicowane kursorem. - Filmy —
GET /v1/youtube/videoszwraca szczegóły filmu, w tym informację, czy napisy są dostępne. - Kanały —
GET /v1/youtube/channelsrozpoznaje kanał według identyfikatora lub@handle. - Przesłane materiały kanału —
GET /v1/youtube/channels/{channelId}/videosprzechodzi przez przesłane materiały kanału. - Elementy playlisty —
GET /v1/youtube/playlists/{playlistId}/itemsprzechodzi przez playlistę. - Napisy —
GET /v1/youtube/captionszwraca metadane ścieżki napisów oraz tekst napisów dla filmu. Nigdy nie uruchamia zadania rozpoznawania mowy: gdy zgłosirequiresAsync, wywołajPOST /v1/transcript, aby uruchomić transkrypcję.
Stworzone do użytku produkcyjnego
Interfejs jest celowo niewielki, a elementy istotne dla usługi są udokumentowane, a nie pozostawione domysłom.
- Jedno poświadczenie — uwierzytelniaj się kluczem API przesyłanym jako token Bearer lub przez
X-API-Keyze skryptu albo serwera. - Klucze z zakresami — przyznawaj tylko zakresy potrzebne wywołującemu;
transcriptsibatchesobejmują ekstrakcję oraz pracę wsadową. - Ustrukturyzowane błędy — niepowodzenia ekstrakcji i walidacji zwracają obiekt błędu ze stabilnym
codei czytelnymmessage; odpowiedzi uwierzytelniania (401) i limitu szybkości (429) używają prostszego, płaskiego ciała błędu. - Limity, na które można zareagować — żądanie objęte limitem szybkości zwraca
429zRetry-After, a udane odpowiedzi niosą nagłówkiX-RateLimit-*, dzięki czemu klient może prawidłowo się wycofać. - Opublikowany kontrakt — pełny dokument OpenAPI stoi za API, więc możesz wygenerować klienta, zamockować serwer lub zweryfikować rzeczywiste odpowiedzi względem schematu.
- Odpowiednik dla agentów — to samo konto i te same narzędzia są dostępne z serwera MCP transcript.im, jeśli wywołującym jest klient AI, a nie usługa.
Powiązane
Najczęstsze pytania o API transkrypcji
Czym jest API transcript.im?
API transcript.im to interfejs REST, który zamienia publiczny link do wideo lub audio w transkrypcję ze znacznikami czasu, wykorzystując najpierw istniejące napisy, a gdy wideo ich nie ma — transkrypcję AI.
Jakie platformy obsługuje API transcript.im?
Wyodrębnia transkrypcje z YouTube, TikTok, Instagram, LinkedIn i Twitter/X, rozpoznając platformę na podstawie wysłanego linku. YouTube, TikTok i LinkedIn najpierw korzystają z napisów, a rozpoznawanie mowy służy jako rozwiązanie zapasowe; Instagram i X nie mają ścieżki napisów i od razu przechodzą do rozpoznawania mowy.
Co się dzieje, gdy wideo nie ma napisów?
Gdy wideo nie ma w ogóle ścieżki napisów, API uruchamia zadanie ASR i zwraca identyfikator zadania; odpytujesz to zadanie, aż transkrypcja będzie gotowa, dzięki czemu żądanie nigdy nie blokuje się na rozpoznawaniu mowy.
Czy mogę transkrybować lokalny plik audio lub wideo?
Tak. POST /v1/transcript przyjmuje ciało multipart/form-data z częścią file zamiast adresu URL. Przesłany plik od razu trafia do rozpoznawania mowy, więc zwraca zadanie 202 — albo wynik 200, jeśli zdąży się zakończyć w budżecie oczekiwania.
Czy API transcript.im może zwracać znaczniki czasu razem z tekstem?
Tak. Odpowiedzi JSON zawierają segmenty ze znacznikami czasu, a odpowiedzi tekstowe mogą zachować prefiks znacznika czasu w każdym wierszu, dzięki czemu możesz wrócić do momentu, w którym wypowiedziano daną kwestię.
Jak poprosić o transkrypcję w konkretnym języku?
Wyślij rozdzieloną przecinkami listę priorytetów językowych, zawierającą wpisy asr i asr-<code>. Dopasowanie napisów jest zwracane bezpośrednio; gdy napisy istnieją, ale żadne nie pasują do listy, żądanie przechodzi do transkrypcji AI i zwraca zadanie 202, a 404 z dostępnymi językami jest zwracane tylko wtedy, gdy rozpoznawanie mowy nie jest dozwolone.
Skąd mam wiedzieć, kiedy asynchroniczna transkrypcja jest gotowa?
Odpytuj GET /v1/transcript/job/{id} tym samym poświadczeniem, aż zgłosi sukces lub porażkę, albo zasubskrybuj GET /v1/transcript/job/{id}/events, aby otrzymywać aktualizacje przesyłane przez serwer. Zapytanie o zadanie zwraca 200 nawet gdy zadanie się nie powiodło, więc czytaj pola status i error, a nie kod HTTP.
Czy API transcript.im obsługuje ekstrakcję wsadową?
Tak. Partia przyjmuje listę adresów URL, playlistę lub kanał, śledzi status każdego elementu i zwraca elementy po jednej stronie naraz.
Które formaty eksportu mogę pobrać?
Ukończona partia eksportuje się jako txt, csv, json, srt, vtt lub zip; pojedyncza zapisana transkrypcja pobiera się jako txt, srt, vtt, json lub md.
Gdzie znajdują się zapisane transkrypcje?
Biblioteka konta to miejsce, w którym znajdują się zapisane transkrypcje i rekordy partii, pod /v1/library. Udostępnia trasy listowania, odczytu, pobierania, powiązane i usuwania, a jej odczyty są ograniczone do konta i nigdy nie uruchamiają nowej ekstrakcji.
Co zwraca endpoint napisów YouTube?
GET /v1/youtube/captions zwraca metadane ścieżki napisów wideo wraz z tekstem napisów. Nigdy nie uruchamia zadania rozpoznawania mowy; gdy zgłosi requiresAsync, wywołaj POST /v1/transcript, aby przeprowadzić transkrypcję.
Jak API transcript.im zgłasza błędy i limity szybkości?
Błędy ekstrakcji i walidacji używają obiektu z code i message; uwierzytelnianie zwraca płaski 401, a ograniczanie szybkości zwraca płaski 429 z Retry-After oraz nagłówkami X-RateLimit-*, dzięki czemu klient może prawidłowo się wycofać.
Dodaj transkrypcje do swojego produktu
Utwórz klucz API, wyślij link do wideo lub plik lokalny, a następnie odczytaj transkrypcję jako JSON lub zwykły tekst.