
REST API
API transkrip untuk video dan audio
transcript.im menyediakan pipeline ekstraksi yang sama yang menjalankan produk sebagai API transkrip berversi. Kirim URL video atau audio dan dapatkan teks berstempel waktu, dalam JSON atau teks biasa, dengan platform yang dideteksi untuk Anda. Takarir yang ada dipakai lebih dulu; saat video tidak memilikinya, AI mentranskripsikan audio dan hasilnya dikirim secara asinkron.
- Satu
urlmenerima tautan lengkap atau pendek dan mendeteksi YouTube, TikTok, Instagram, LinkedIn, dan Twitter/X; untuk YouTube, video id mentah juga dikenali, danplatformplusexternalIdmencakup sumber yang sudah Anda kenal. - Takarir dipakai lebih dulu; saat video tidak memilikinya, AI mentranskripsikan audio, dan file lokal yang diunggah selalu melewati pengenalan suara.
format=jsonmengembalikan segmen berstempel waktu, sedangkanformat=textmengembalikan teks biasa yang siap ditempel.- Ekstraksi batch mencakup daftar URL, playlist, dan channel.
- Ekspor batch mencakup txt, csv, json, srt, vtt, dan zip; transkrip yang disimpan diunduh sebagai txt, srt, vtt, json, atau md.
- Transkrip yang disimpan tersimpan di Pustaka akun, dan penjelajahan YouTube mencakup pencarian, video, channel, unggahan, playlist, dan takarir.
- Kontrak lengkapnya diterbitkan sebagai dokumen OpenAPI.
Apa yang dilakukan API transcript.im
API transcript.im mengubah tautan video atau audio publik menjadi transkrip berstempel waktu yang bisa dibaca, disimpan, dicari, atau diteruskan ke model oleh produk Anda. Anda mengirim URL; API menentukan platform, mencari trek takarir yang sudah dimiliki kreator, dan mengembalikan teks tertulis dengan stempel waktu di setiap baris. Saat video sama sekali tidak punya takarir, API tidak berhenti pada error: ia beralih ke transkripsi AI atas audio yang diucapkan agar permintaan yang sama tetap menghasilkan teks.
- Satu permintaan, teks nyata — tentukan tautan dan kembalikan segmen transkrip berstempel waktu atau teks biasa.
- Takarir dulu, AI kemudian — pakai trek kreator bila ada, transkripsikan audio bila tidak.
- Asinkron secara bawaan untuk ASR — job id memungkinkan Anda menjajaki transkripsi panjang tanpa memblokir.
- Sadar bahasa — minta prioritas bahasa dan baca kembali bahasa yang ditentukan API.
- Tidak bergantung platform — pemanggil tidak perlu tahu di mana video dihosting.
Satu API transkrip untuk lima platform
YouTube
Transkrip untuk video YouTube publik, Short, atau rekaman langsung apa pun, memakai takarir kreator lebih dulu dan transkripsi AI saat takarir tidak ada. YouTube juga platform dengan permukaan penjelajahan lengkap — pencarian, video, channel, unggahan, playlist, dan takarir — yang tersedia berdampingan dengan transkripnya sendiri. Tumpukan video sebuah channel atau sebuah playlist menjadi batch transkrip berstempel waktu, sementara satu tautan kembali sebagai teks yang mudah dibaca dan bisa Anda cari.
TikTok
Transkrip untuk video TikTok publik, dengan takarir dipakai lebih dulu dan pengenalan suara sebagai cadangan. Tempel tautan video dan baca konten yang diucapkan sebagai teks bersih berstempel waktu yang bisa Anda gunakan ulang, terjemahkan, atau kutip. Panggilan yang sama mencakup klip pendek maupun unggahan lebih panjang, jadi tren, tutorial, dan video orang berbicara ke kamera semuanya kembali sebagai teks.
Transkrip untuk Reels dan pos video Instagram publik. Instagram tidak punya trek takarir untuk dibaca, jadi ekstraksinya adalah pengenalan suara asinkron: kirim tautan, jajaki job, dan ambil teksnya saat siap. Itu membuat sebuah Reel bisa dikutip dan dicari meski platform tidak pernah menerbitkan ucapannya sebagai teks.
Transkrip untuk pos video LinkedIn publik, dengan takarir dipakai lebih dulu dan pengenalan suara sebagai cadangan. Hasilnya kembali dengan stempel waktu, jadi sebuah presentasi, klip produk, atau rapat yang direkam menjadi teks yang bisa dicari dan Anda kutip serta gunakan ulang. Tarik argumen dari rekaman webinar, atau ubah kabar terbaru seorang pendiri menjadi draf yang bisa Anda sunting.
Twitter/X
Transkrip untuk pos video X publik. X tidak punya trek takarir untuk dibaca, jadi ekstraksi melewati pengenalan suara asinkron: kirim tautan, jajaki job, dan ambil teks berstempel waktu yang bisa Anda cari. Kutip video dengan akurat, atau arsipkan konten ucapannya sebelum pos disunting atau dihapus.
Bagaimana permintaan transkrip mengalir
Satu panggilan membawa tautan atau file yang diunggah dari input ke transkrip, dan API memberi tahu jalur mana yang diambilnya.
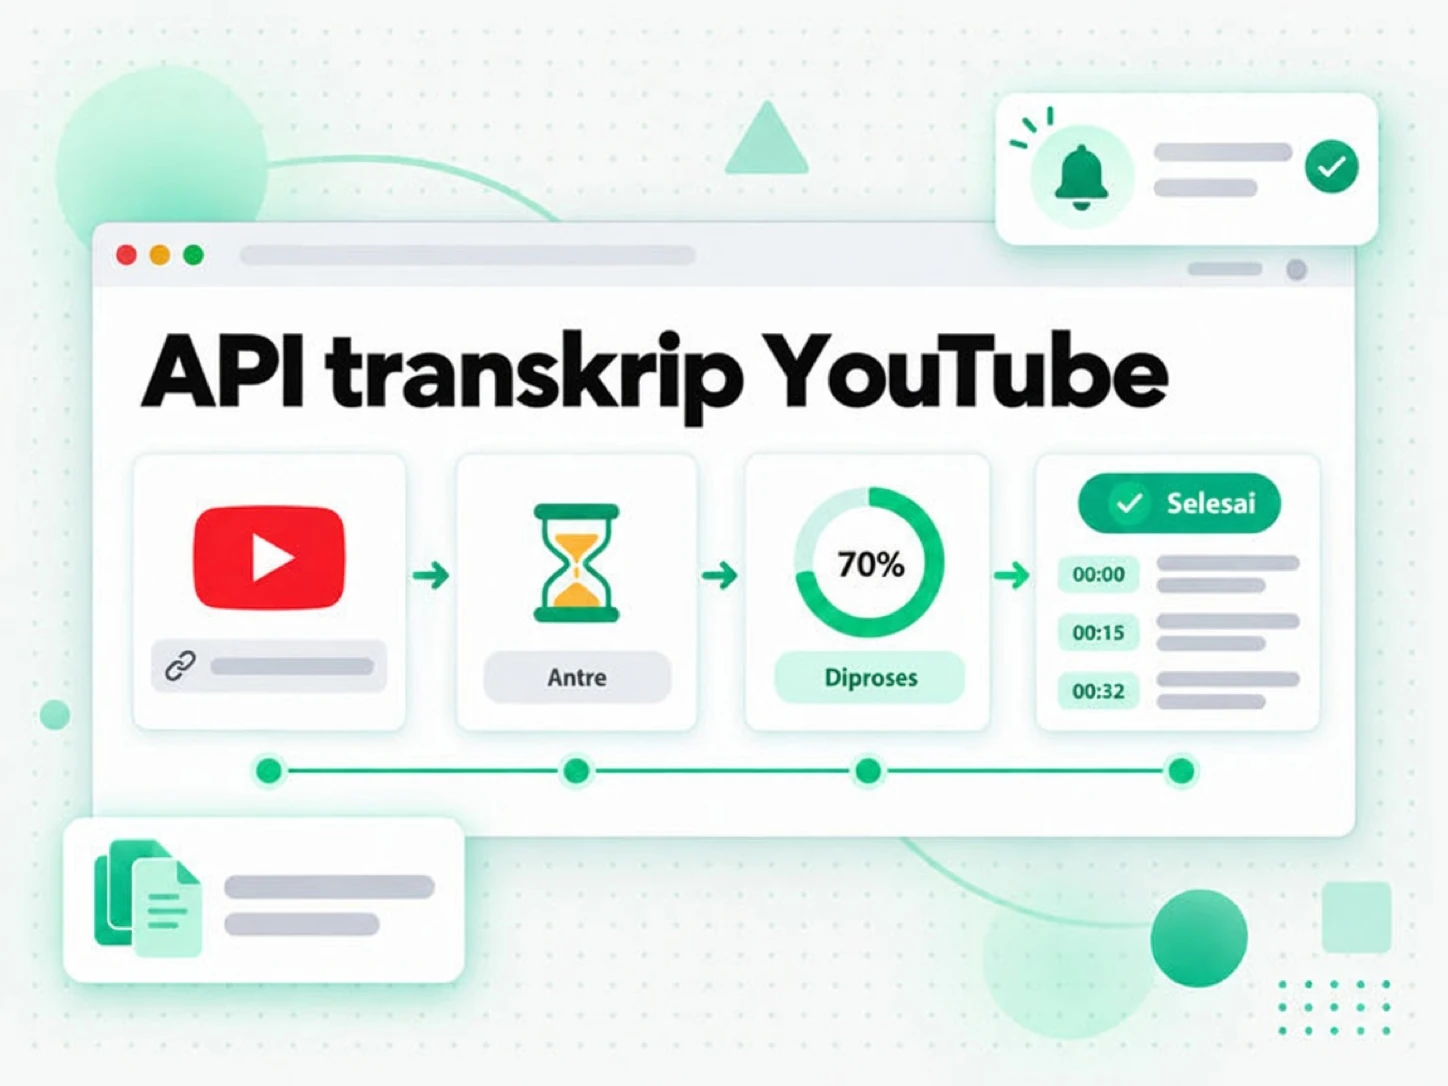
- Kirim sumbernya — kirim
url, sertakanplatformdanexternalIdbila Anda sudah mengetahuinya, atau unggah file sebagaimultipart/form-datake endpoint yang sama. - Dapatkan kecocokan takarir — saat video membawa takarir dalam bahasa di daftar Anda, transkrip kembali dalam respons.
- Tangani bahasa yang tidak cocok — saat takarir ada tetapi tidak ada yang cocok dengan daftar Anda, permintaan berlanjut ke transkripsi AI dan mengembalikan
202dengan job id;404denganavailableLanguageshanya dikembalikan saat pengenalan suara tidak diizinkan bagi pemanggil. - Paksa atau beralih ke ASR — entri
asryang eksplisit, video tanpa trek takarir sama sekali, atau file yang diunggah memulai job ASR dan mengembalikan job id. - Jajaki atau streaming — baca job dengan
GET /v1/transcript/job/{id}sampai berhasil atau gagal, atau langganan aliran/events-nya untuk progres dari server. Kueri job mengembalikan200bahkan untuk job yang gagal, jadi bercabanglah pada bidangstatus. - Baca hasilnya — transkrip yang selesai membawa bahasa yang ditentukan, durasi, segmen berstempel waktu, dan bila diminta metadata seperti judul, penulis, dan tanggal terbit.
- Ulangi dengan aman — transkrip yang sudah diekstraksi dilayani dari cache alih-alih memulai job baru, jadi sumber yang sama bisa diminta lagi.
- Periksa dulu —
GET /v1/transcript/infomenentukan sumber dan mencantumkan bahasa yang bisa dilayaninya sebelum Anda memutuskan ekstraksi.
202 dengan job id, dan aset yang benar-benar tidak ada atau cadangan yang tidak diizinkan mengembalikan 404. Setiap jalur mengembalikan bentuk transkrip yang sama begitu teksnya siap.Ekstraksi batch dan ekspor
Beban kerja nyata jarang berhenti di satu video, jadi API menerima batch sebagai daftar URL, playlist, atau channel. Setiap batch melacak totalnya sendiri — berapa item yang tertunda, berapa yang berhasil, dan berapa yang gagal — dan mengembalikan item per halaman, sehingga channel panjang tidak datang sebagai satu muatan raksasa.
- Tiga bentuk batch —
POST /v1/batchmenerima daftar URL, playlist, atau channel, sesuai isi body yang Anda kirim. - Status independen — tautan yang gagal ditandai sendiri dan tidak pernah membuang sisa batch; item yang gagal bisa dicoba ulang dengan
/retry. - Item berhalaman — baca batch dengan
GET /v1/batch/{batchId}, lalu ikuti page token yang dikembalikan untuk item berikutnya. - Progres langsung — setiap penjajakan mengembalikan jumlah terbaru, jadi pemanggil bisa menunjukkan seberapa jauh proses panjang sudah selesai.
- Ekspor dalam format Anda — unduh batch yang selesai dari
/exportsebagaitxt,csv,json,srt,vtt, atauzip.
srt dan vtt langsung masuk ke editor atau pemutar. Untuk arsip, csv, json, dan zip menjaga seluruh pustaka rekaman tetap bisa dicari sebagai satu korpus. Formatnya sejalan dengan respons transkrip tunggal, jadi konsumen yang menangani satu hasil sudah tahu cara membaca batch.Transkrip tersimpan di Pustaka akun
Ekstraksi dan penyimpanan adalah dua hal terpisah: transkrip menjadi bagian dari Pustaka akun setelah disimpan, dan Pustaka adalah tempat Anda membaca, mencari, mengunduh, dan menghapusnya nanti tanpa menjalankan ulang ekstraksi.
- Daftar konten tersimpan —
GET /v1/library/transcriptsmenelusuri per halaman transkrip akun, catatan batch, dan baris riwayat gagal, dengan pencarian, filter platform dan bahasa, serta pengurutan. - Baca satu item —
GET /v1/library/transcripts/{platform}/{externalId}mengembalikan transkrip tersimpan berdasarkan platform dan id eksternal, atau untuk bahasa yang Anda sebutkan. - Unduh — rute
/downloadmengekspor transkrip tersimpan sebagaitxt,srt,vtt,json, ataumd. - Konten terkait — rute
/relatedmencantumkan item tersimpan lain dari channel yang sama. - Hapus —
DELETEmengeluarkan item dari Pustaka tanpa menyentuh salinan orang lain. - Pembacaan terbatas akun — permintaan Pustaka hanya mengembalikan apa yang disimpan akun dan tidak pernah memulai ekstraksi baru, jadi meninjau ulang transkrip tersimpan adalah pembacaan, bukan job lain.
Penjelajahan YouTube di luar transkrip
YouTube adalah platform tempat API juga menjawab pertanyaan di sekitar transkrip, memakai nama resource yang sama dengan YouTube Data API.
- Pencarian —
GET /v1/youtube/searchmenemukan video, channel, atau playlist berdasarkan kueri dan mengembalikan hasil berhalaman kursor. - Video —
GET /v1/youtube/videosmengembalikan detail sebuah video, termasuk apakah takarir tersedia. - Channel —
GET /v1/youtube/channelsmenentukan channel berdasarkan id atau@handle. - Unggahan channel —
GET /v1/youtube/channels/{channelId}/videosmenelusuri unggahan sebuah channel. - Item playlist —
GET /v1/youtube/playlists/{playlistId}/itemsmenelusuri sebuah playlist. - Takarir —
GET /v1/youtube/captionsmengembalikan metadata trek takarir dan teks takarir sebuah video. Ia tidak pernah memulai job pengenalan suara: saat melaporkanrequiresAsync, panggilPOST /v1/transcriptuntuk menjalankan transkripsi.
Dirancang untuk produksi
Permukaannya sengaja dibuat kecil, dan bagian yang penting bagi sebuah layanan didokumentasikan alih-alih ditebak.
- Satu kredensial — autentikasi dengan kunci API yang dikirim sebagai token Bearer, atau dengan
X-API-Keydari skrip atau server. - Kunci berscope — berikan hanya scope yang dibutuhkan pemanggil, dengan
transcriptsdanbatchesmencakup ekstraksi dan pekerjaan batch. - Error terstruktur — kegagalan ekstraksi dan validasi mengembalikan objek error dengan
codeyang stabil danmessageyang mudah dibaca; respons autentikasi (401) dan batas laju (429) memakai body error datar yang lebih sederhana. - Batas yang bisa ditindaklanjuti — permintaan yang terkena batas laju mengembalikan
429denganRetry-After, dan respons yang berhasil membawa headerX-RateLimit-*agar klien bisa mundur dengan benar. - Kontrak yang diterbitkan — dokumen OpenAPI lengkap menopang API, jadi Anda bisa membuat klien, memalsukan server, atau memvalidasi respons nyata terhadap skema.
- Saudara untuk agen — akun dan alat yang sama bisa diakses dari server MCP transcript.im jika pemanggil Anda adalah klien AI, bukan layanan.
Terkait
Pertanyaan umum tentang API transkrip
Apa itu API transcript.im?
API transcript.im adalah permukaan REST yang mengubah tautan video atau audio publik menjadi transkrip berstempel waktu, memakai takarir yang ada lebih dulu dan transkripsi AI saat video tidak memilikinya.
Platform apa saja yang didukung API transcript.im?
Ia mengekstraksi transkrip dari YouTube, TikTok, Instagram, LinkedIn, dan Twitter/X dengan mendeteksi platform dari tautan yang Anda kirim. YouTube, TikTok, dan LinkedIn memakai takarir lebih dulu dengan pengenalan suara sebagai cadangan; Instagram dan X tidak punya trek takarir dan langsung ke pengenalan suara.
Apa yang terjadi bila video tidak punya takarir?
Saat video sama sekali tidak punya trek takarir, API memulai job ASR dan mengembalikan job id; Anda menjajaki job itu sampai transkripnya siap, jadi permintaan tidak pernah terblokir oleh pengenalan suara.
Bisakah saya mentranskripsikan file audio atau video lokal?
Bisa. POST /v1/transcript menerima body multipart/form-data dengan bagian file sebagai pengganti URL. File yang diunggah langsung masuk ke pengenalan suara, sehingga mengembalikan job 202 — atau hasil 200 bila selesai dalam anggaran tunggu.
Bisakah API transcript.im mengembalikan stempel waktu bersama teksnya?
Bisa. Respons JSON membawa segmen berstempel waktu dan respons teks bisa mempertahankan awalan stempel waktu di setiap baris, sehingga Anda bisa kembali ke saat sebuah kalimat diucapkan.
Bagaimana cara meminta transkrip dalam bahasa tertentu?
Kirim daftar prioritas bahasa yang dipisahkan koma, termasuk entri asr dan asr-<code>. Kecocokan takarir dikembalikan langsung; saat takarir ada tetapi tidak ada yang cocok dengan daftar, permintaan berlanjut ke transkripsi AI dan mengembalikan job 202, dan 404 dengan bahasa yang tersedia hanya dikembalikan saat pengenalan suara tidak diizinkan.
Bagaimana saya tahu kapan transkrip asinkron siap?
Jajaki GET /v1/transcript/job/{id} dengan kredensial yang sama sampai melaporkan sukses atau gagal, atau langganan GET /v1/transcript/job/{id}/events untuk pembaruan dari server. Kueri job mengembalikan 200 bahkan saat job gagal, jadi baca bidang status dan error alih-alih kode HTTP.
Apakah API transcript.im mendukung ekstraksi batch?
Ya. Sebuah batch menerima daftar URL, playlist, atau channel, melacak status setiap item, dan mengembalikan item per halaman.
Format ekspor apa yang bisa saya unduh?
Batch yang selesai diekspor sebagai txt, csv, json, srt, vtt, atau zip; satu transkrip tersimpan diunduh sebagai txt, srt, vtt, json, atau md.
Di mana transkrip tersimpan berada?
Pustaka akun adalah tempat transkrip tersimpan dan catatan batch berada, di bawah /v1/library. Ia menyediakan rute daftar, baca, unduh, terkait, dan hapus, dan pembacaannya terbatas pada akun serta tidak pernah memulai ekstraksi baru.
Apa yang dikembalikan endpoint takarir YouTube?
GET /v1/youtube/captions mengembalikan metadata trek takarir sebuah video bersama teks takarirnya. Ia tidak pernah memulai job pengenalan suara; saat melaporkan requiresAsync, panggil POST /v1/transcript untuk menjalankan transkripsi.
Bagaimana API transcript.im melaporkan error dan batas laju?
Error ekstraksi dan validasi memakai objek dengan code dan message; autentikasi mengembalikan 401 datar, dan batas laju mengembalikan 429 datar dengan Retry-After plus header X-RateLimit-* agar klien bisa mundur dengan benar.
Tambahkan transkrip ke produk Anda
Buat kunci API, kirim tautan video atau file lokal, lalu baca transkripnya sebagai JSON atau teks biasa.