
Работа с видео на японском: практическое руководство
Узнайте, как уверенно работать с видео на японском: определять язык, расшифровывать аудио и переводить субтитры с сохранением таймкодов.
У вас открыта ссылка на японское видео на YouTube, в деле уже три инструмента, и ни один из них не сходится в том, что сказал говорящий. В одном экспорте не хватает строк, один транскрипт сглаживает важные слова, а один черновик субтитров кажется читабельным — пока не попробуешь совместить его со звуком. Это обычная болевая точка при работе с японским видео, и именно поэтому типовой рабочий процесс обычно рассыпается ещё до того, как появятся субтитры.
Японское видео требует продуманного пути, потому что язык меняет задачу на каждом шаге. Звук может быть насыщен заимствованиями, гонорификами, обрывочными репликами и быстрым обменом репликами, с которым обычный проход «речь в текст» не всегда справляется чисто. У текстовой стороны тоже свои правила: японские субтитры часто несут больше смысла на символ, а места на экране меньше, чем ожидают многие редакторы, привыкшие к английскому.
Хороший рабочий процесс начинается с четырёх действий: определить, транскрибировать, рассчитать тайминг и перевести. Если пропустить любое из них, остальному файлу становится труднее доверять. В качестве практичной отправной точки рабочая область для японской транскрибации показывает структуру, которая делает эту работу менее хаотичной.
Почему японское видео заслуживает отдельного рабочего процесса
Руководитель команды скидывает в общий документ ссылку на 30-минутный японский вебинар. Один человек прогоняет его через сайт для субтитров, другой пробует универсальный ИИ-инструмент, а третий вставляет звук в редактор субтитров. В итоге все три файла выглядят по-разному, и ни один из них нельзя использовать без чистки.
Такая ситуация возникает потому, что японское видео — это не просто «видео, но на другом языке». Исходный звук часто смешивает формальную и разговорную речь, добавляет короткие поддакивания и опирается на контекст, который инструмент с английской ориентацией может сгладить. В результате транскрибация, тайминг субтитров и перевод требуют больше внимания, чем стандартный проход в один заход.
Превратить исходное видео в пригодный текст — не прямая линия
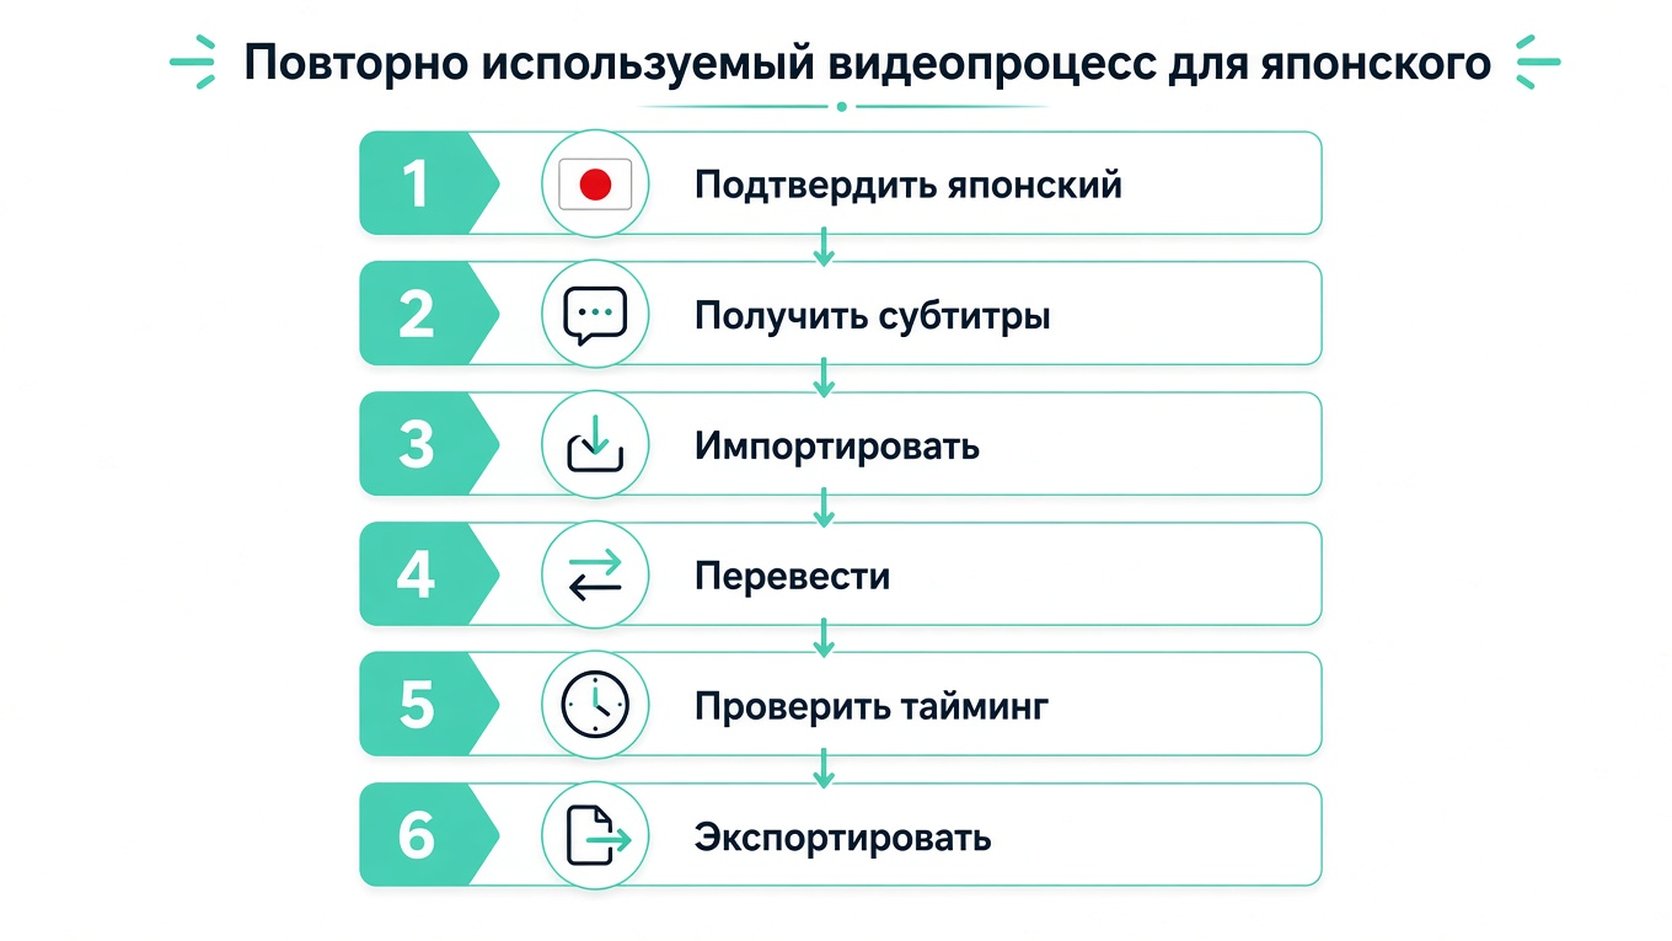
Японское видео обычно проходит примерно такую последовательность, даже если команда не называет её так. Сначала кто-то проверяет, какой язык заявил публикатор. Затем убеждается, как звучит аудио. После этого решает, брать существующие субтитры или генерировать новый транскрипт. И только потом переводит, расставляет тайминг и экспортирует.
Звучит просто, но точки разрыва важны. Японским субтитрам часто нужно больше визуального воздуха, а переведённые строки легко становятся слишком длинными для исходного окна реплики. Рабочий процесс, который игнорирует эти ограничения, создаёт текст, который отлично выглядит в документе и ломается в тот момент, когда попадает в плеер.
Практическое правило: относитесь к японскому как к проекту синхронизированного текста, а не как к работе по переводу «копировать-вставить».
Много путаницы возникает из-за того, что люди считают субтитры просто диалогом на другом языке. Это не так. Это сжатый опыт чтения, привязанный к движущемуся видео, и японский делает это сжатие более заметным, потому что сама система письма несёт много информации на символ.
Субтитры, которые на странице выглядят «короткими», на экране всё равно могут казаться перегруженными.
Именно поэтому остальная часть этого руководства держится ближе к реальной механике. Если вы умеете правильно определять язык, получать чистый транскрипт, сохранять тайминг и оставлять переведённые реплики читабельными, вы можете переиспользовать один и тот же процесс для лекций, интервью, вебинаров и коротких клипов для соцсетей.
Как определить, что видео действительно на японском
Самый надёжный способ опознать японский — использовать три сигнала вместе, а не одну догадку. Метаданные говорят, что заявил публикатор. Аудиофрагмент говорит, что произносят люди. Дорожка субтитров говорит, что другая система или загрузивший уже считали рабочим языком.
Начните с того, что уже говорят платформа и файл
Посмотрите на поле языка, если платформа его показывает. Проверьте теги, описания и любые загруженные дорожки субтитров. Vimeo, вложения подкастов и метаданные локальных файлов тоже могут нести полезные подсказки, даже когда они неполные.
Затем проиграйте короткий аудиофрагмент и дайте ASR-пробе автоматически определить язык. Японский обычно чисто определяется, когда речь простая. Проблемы появляются, когда дорожка переключается между японским и английским или когда говорящий использует много заимствованных слов и переключений кода.
Наконец, изучите имеющиеся субтитры. Дорожка ja-JP или ja-CC — самый сильный сигнал, какой можно получить. На YouTube автосубтитры для японского часто оставляют знакомый мусор вроде полноширинного интервала или случайной пунктуации, и это всё равно полезно, потому что подтверждает: система уже обработала аудио как японское.
Используйте самый сильный сигнал, а крайний случай задокументируйте
Если все три проверки согласуются, решение простое. Если метаданные говорят «английский», но аудиопроба и субтитры оба выглядят японскими, доверяйте аудио и дорожке субтитров, а не метке. Публикатор мог неправильно проставить тег у загрузки, но произнесённое содержимое — всё равно то, что должен отражать ваш транскрипт.
Если проверки расходятся, зафиксируйте причину в рабочих заметках, прежде чем двигаться дальше. Это важно, потому что инструменты на следующих этапах, редакторы и рецензенты выигрывают от одного и того же предположения о языке. Чистая передача лучше идеальной догадки.
| Три сигнала для определения японского языка в видео | |||
|---|---|---|---|
| Сигнал | Что проверяет | Надёжность | Когда ему доверять |
| Метаданные | Языковые поля, теги, сведения о файле | Средняя | Когда публикатор внимателен |
| Анализ аудио | Что на самом деле говорит говорящий | Высокая | Когда речевой образец чёткий |
| Дорожка субтитров | Существующий текст ja-JP или ja-CC | Очень высокая | Когда дорожка субтитров уже существует |
Для более широкого рабочего процесса захвата полезен путь речь в текст для японского видео, потому что он начинается с самого контента, а не исходит из предположения, что метка верна.
Как надёжно транскрибировать японское аудио
Самый чистый путь транскрибации зависит от того, существуют ли уже субтитры. Если да — сначала используйте их. Если нет — создайте транскрипт из аудио. Звучит очевидно, но для японского это экономит массу переделок, потому что существующий синхронизированный текст часто ближе к пригодному, чем черновик ASR.
Сначала субтитры, если дорожка уже есть
Когда существует дорожка ja-JP, экспортируйте её и преобразуйте в формат чистого текста с временными метками. TTML и WebVTT оба несут тайминг, и этот тайминг должен оставаться нетронутым, пока вы чистите текст. Первая задача — не «улучшить» формулировку. А убедиться, что транскрипт покрывает всю аудиодорожку без пробелов.
Эта проверка покрытия важнее, чем кажется. Файл субтитров может выглядеть отполированным и всё же пропускать смены говорящих, ремарки или короткие вставки. Если вы заметите эти пробелы до перевода, вы не протолкнёте неполный текст на следующий этап.
Чистый рабочий процесс «сначала субтитры» обычно означает три простых прохода:
- Извлеките синхронизированную дорожку из исходной платформы или файла.
- Нормализуйте текст в читаемый транскрипт с сохранёнными временными метками.
- Сравните покрытие с аудио, чтобы пропущенные фрагменты выявились рано.
Сначала ASR, когда нет пригодной дорожки субтитров
Если субтитров нет, используйте речь в текст на самом аудио. Японский, как правило, выигрывает от моделей, которые комфортно работают с разговорной речью, потому что представления в стиле новостной редакции могут упускать срезанные окончания, неформальные формулировки и короткие грамматические частицы, которые важны для смысла, даже когда они не отображаются аккуратно на английский.
Перед запуском транскрибации передайте движку нужный ему пользовательский словарь. Названия проектов, продуктов, фамилии и брендовые термины — всё помогает. Затем тщательно выберите выходную письменность. Кана может быть лучше для сырого захвата, тогда как кандзи плюс окуригана часто читается естественнее при проверке.
Если говорящих несколько, стоит включить диаризацию. Без разделения говорящих японские интервью и дискуссии очень быстро превращаются в стену текста. После первого прохода проверьте три случайные минуты рядом с оригинальным аудио. Такая выборочная проверка поймает исправления, которые появляются снова и снова, особенно полуширинные цифры, смещение пунктуации и потерянные финальные частицы предложений.
Рабочий процесс перевести видео в текст для японского — хороший пример того, как чистое рабочее пространство транскрибации помогает держать эти подсказки организованными, а не заставляет вас позже восстанавливать их вручную.
Что делает японские субтитры сложнее английских
Японские субтитры требуют другой привычки чтения, чем английские. Английский опирается на границы слов, пробелы и знакомый ритм строк. Японский может уместить больше смысла в меньшее число видимых знаков, поэтому строка, которая на бумаге выглядит короткой, на экране всё равно может казаться перегруженной.
Плотность символов меняет всё
Профессиональное японское руководство по стилю устанавливает скорость чтения в 4,0 символа в секунду и считает полуширинные символы за 0,5 согласно японскому руководству по стилю OOONA. Это правило полезно, потому что показывает, как японские субтитры оцениваются по визуальной нагрузке, а не только по количеству символов. Один кандзи может нести много смысла, не занимая много места.
Японское руководство Netflix по синхронизированному тексту даёт ту же картину под другим углом. Оно использует минимальную длительность субтитров 0,5 секунды на событие, допускает до 7 символов в секунду в контекстах SDH и часто ограничивает горизонтальные строки примерно 13 полноширинными символами в своём японском руководстве по стилю. Точные числа важны меньше, чем принцип. Тайминг субтитров должен давать глазу достаточно места для чтения, прежде чем сцена сменится.
Полуширинный и полноширинный текст — не одна и та же проблема
Обычные инструменты для субтитров часто это упускают. Цифры, скобки, знаки препинания и знаки долготы могут принимать полуширинную или полноширинную форму, а от этого зависит, насколько перегруженной выглядит реплика. Строка, которая нормально смотрится в текстовом редакторе, может оказаться тесной внутри кадра субтитра.
Английские редакторы часто считают слова в строке. Японским редакторам приходится следить за плотностью символов, балансом знаков и тем, сколько времени зрителю нужно, чтобы «зацепиться» за каждую реплику. Субтитр может быть лингвистически правильным и всё равно трудным для чтения, если визуальная нагрузка слишком велика.
| Ограничения субтитров: японский и английский | ||
|---|---|---|
| Ограничение | Японский | Английский |
| Скорость чтения | Около 4,0 знака в секунду в японском стайлгайде OOONA | Часто регулируется ритмом слов, а не плотностью символов |
| Длина строки | Около 13 полноширинных знаков в «Japanese Timed Text Style Guide» Netflix | Обычно на экране больше знаков |
| Работа со знаками | Полуширинные и полноширинные формы меняют визуальную плотность | Реже становится проблемой вёрстки |
| Окно показа | Короткие реплики требуют аккуратной подачи | Тайминг тоже важен, но визуальная нагрузка легче |
Если японская реплика выглядит перегруженной, сократите её, прежде чем менять шрифт.
Эта привычка окупается. Субтитр, укладывающийся в лимит строки, обычно читается легче, чем тот, что пытается дословно сохранить каждое сказанное слово.
Как переводить субтитры, не теряя тайминг
Перевод становится проще, когда перестаёшь относиться к файлу субтитров как к обычному документу. У каждой реплики уже есть время начала, время окончания и ограниченное окно чтения. Перевод должен уместиться в это окно, а не наоборот.
Сначала зафиксируйте окна реплик
Загрузите файл SRT или WebVTT и оставьте таймкоды неизменными. В SRT используются порядковый номер, начальный и конечный таймкод и одна-две строки текста. WebVTT устроен по той же базовой логике синхронизированных реплик, только вместо запятых в таймкодах стоит точка как описано в этом руководстве по форматам субтитров. Структура важна, потому что именно тайминг синхронизирует субтитры.
Если после перевода реплика слишком длинная, сократите формулировку или разделите мысль на две реплики. Если слишком короткая, можно оставить немного пространства, чтобы строка не мелькала неестественно быстро. Главное — сохранить исходный тайминг, пока меняется текст.
Переводите внутри окна, а не за его пределами
Читаемый перевод субтитров должен сохранять смысл и не заставлять зрителя перечитывать экран. Для этого нужно упрощать придаточные, убирать лишние слова и уважать лимит знаков, который вы уже проверили в предыдущем разделе. Кроме того, стоит следить за форматом плеера: одни системы предпочитают WebVTT, другие ждут отдельный файл SRT.
Командам, которые хотят двигаться быстрее, процесс с поддержкой перевода видео с помощью ИИ поможет сделать первый черновой вариант, но тайминг всё равно должен проверить человек перед экспортом. Именно на этой проверке и ловятся строки, которые формально переведены хорошо, но неудобно ложатся в окно реплики.
Для сборки субтитров с прицелом на японский генератор субтитров для японских клипов — один из практичных путей, при котором структура тайминга остаётся видимой во время работы.
{% youtube id="VpDRJT0vSH8" /%}
Как выбрать инструмент, который хорошо работает с японским
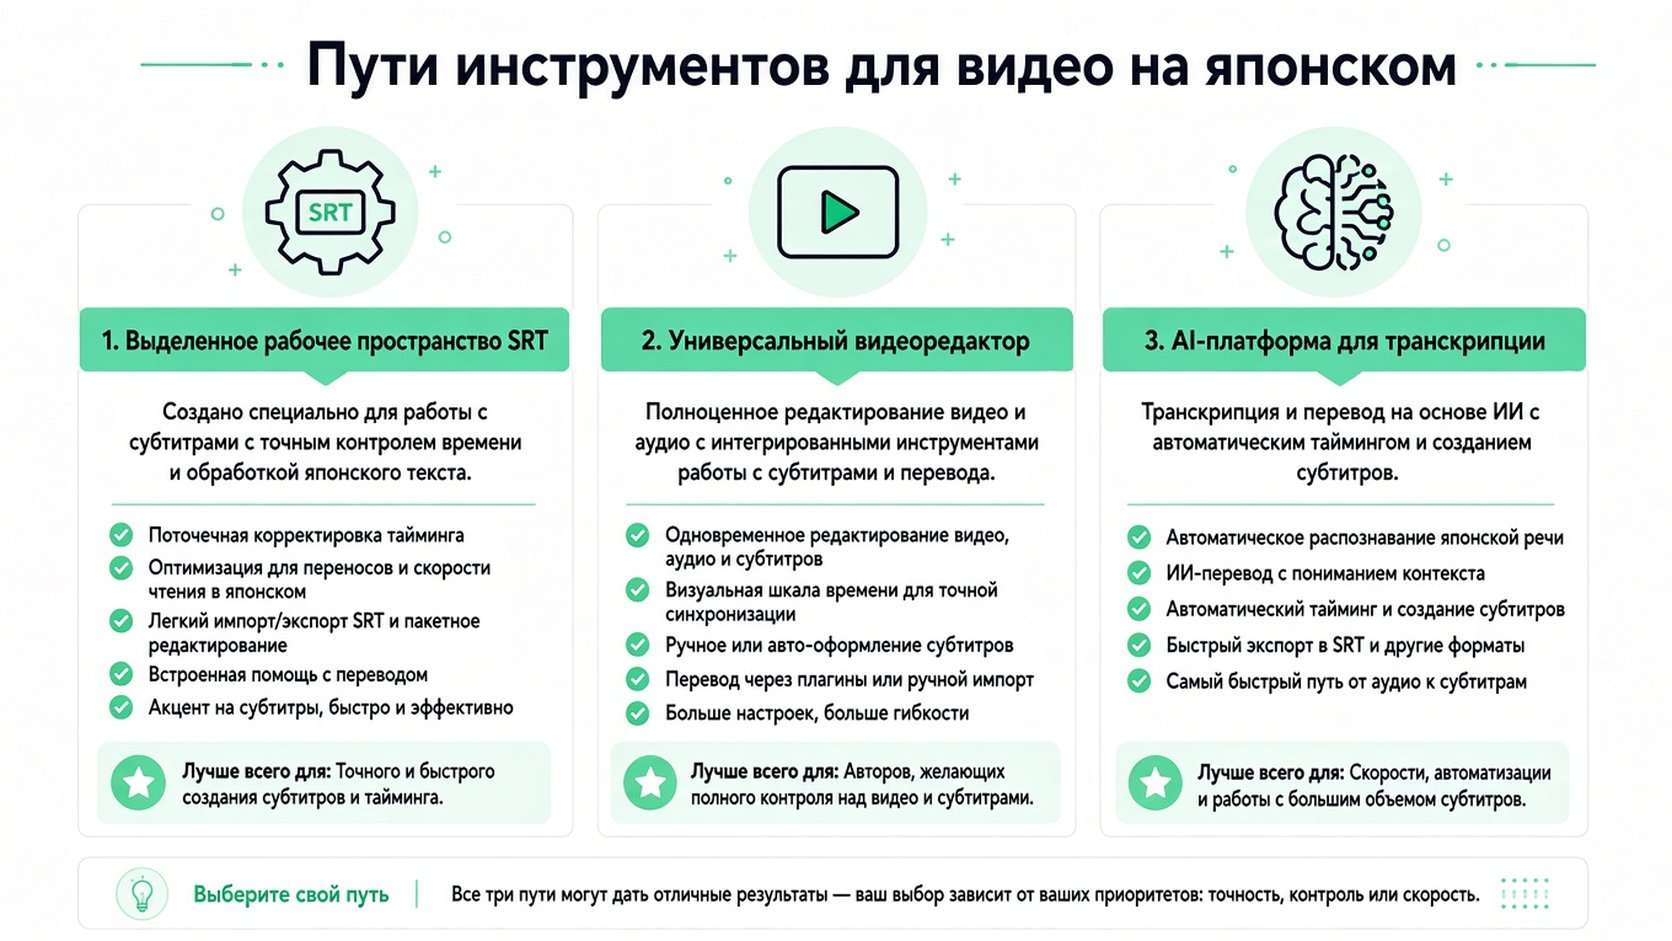
Для видео на японском снова и снова всплывают три пути. Первый — отдельное пространство для транскрибации, где синхронизированный текст остаётся редактируемым. Второй — ручное создание субтитров в обычном видеоредакторе. Третий — более универсальный ИИ-инструмент, который пытается делать транскрибацию, перевод и вшивание субтитров в одном месте.
Подбирайте инструмент под результат
Отдельное пространство имеет наибольший смысл, когда нужны выходные файлы SRT или VTT, редактируемые реплики и вычитка с учётом японского. Этот путь выбирают, когда субтитры должны оставаться пригодными для повторного использования дальше, а не просто один раз хорошо выглядеть на одной платформе.
Ручное создание субтитров всё ещё уместно. Оно хорошо работает для коротких клипов, особенно когда рядом сидит беглый носитель и может вручную выставить тайминг строк. Проблема в трудозатратах, а не в теории. Подсчёт знаков по строкам и тайминг быстро становятся утомительными, как только клип удлиняется.
Универсальные ИИ-инструменты бывают полезны для черновиков. Они также могут сгладить структуру тайминга или скрыть детали, которые важны для японской читаемости. Значит, длину строк, длительность реплики и поведение знаков препинания всё равно придётся проверять самому.
Выбирайте инструмент, после которого меньше всего правок
Лучшее правило простое. Выбирайте отдельное пространство, когда нужны редактируемые субтитры и контроль качества с учётом японского. Выбирайте ручное создание субтитров, когда клип короткий и есть человек. Выбирайте универсальный ИИ-инструмент, когда достаточно черновика и вы и так планируете позже переработать файл.
Веб-решение вроде генератора японских субтитров quso.ai может пригодиться, когда нужно быстро прогнать субтитры для сравнения, но проверку тайминга оно всё равно оставляет вам, если итоговый файл должен остаться читаемым. Это нормально. Японский хронометрированный текст придирчив, и инструмент должен помогать видеть структуру, а не прятать её.
Повторяемый процесс, который можно использовать снова
Хороший процесс работы с японским видео становится проще, как только вы перестаёте каждый раз решать всё с нуля. Один и тот же порядок работает снова и снова — неважно, обрабатываете вы вебинар, лекцию, интервью или клип для соцсетей.
Сохраняйте последовательность фиксированной
Начните с того, что подтвердите японский язык — по метаданным или короткому фрагменту аудио. Затем извлеките уже существующие субтитры, если они есть, или запустите ASR на чистом аудио, если их нет. Импортируйте реплики в редактор, который учитывает правила плотности символов, переводите внутри исходного окна реплики и экспортируйте в формате, который ожидает плеер.
После экспорта сделайте последний проход: проверьте сползание к полуширинным символам, проникновение ромадзи и выход строк за пределы длины. Это мелкие проблемы, специфичные для японского, которые обычно переживают первую чистку, если не искать их специально.
Помогает простое разделение ролей:
- Автоматизация берёт на себя: определение языка, первичную транскрибацию и черновой перевод.
- Ручная проверка берёт на себя: уплотнение реплик, культурные формулировки и финальную проверку тайминга.
- Логика экспорта берёт на себя: вывод SRT или WebVTT в зависимости от плеера, куда пойдёт файл.
В эту схему хорошо вписывается расшифровка видео в текст: она хранит расшифровку, таймкоды и параметры экспорта в одном месте. Благодаря этому следующий японский файл легче начать — вы переиспользуете процесс, а не изобретаете его заново.
Если вы прямо сейчас разбираете японские видеоклипы, transcript.im поможет вытащить расшифровки по публичным ссылкам или из загрузок, сохранить таймкоды нетронутыми и передать этот текст в перевод или чистку субтитров, не пересобирая весь файл вручную. Зайдите на сервис транскрибации transcript.im и опробуйте этот процесс на следующем японском видео — особенно если вам нужен чистый, многоразовый хронометрированный текст, а не очередной черновик.
Транскрибация
Превратите любое видео в текст
Вставьте ссылку YouTube, TikTok или Instagram и читайте транскрипт с отметками времени в каждой строке.
Экспорт в TXT, SRT или VTT.