
REST API
API транскрибации для видео и аудио
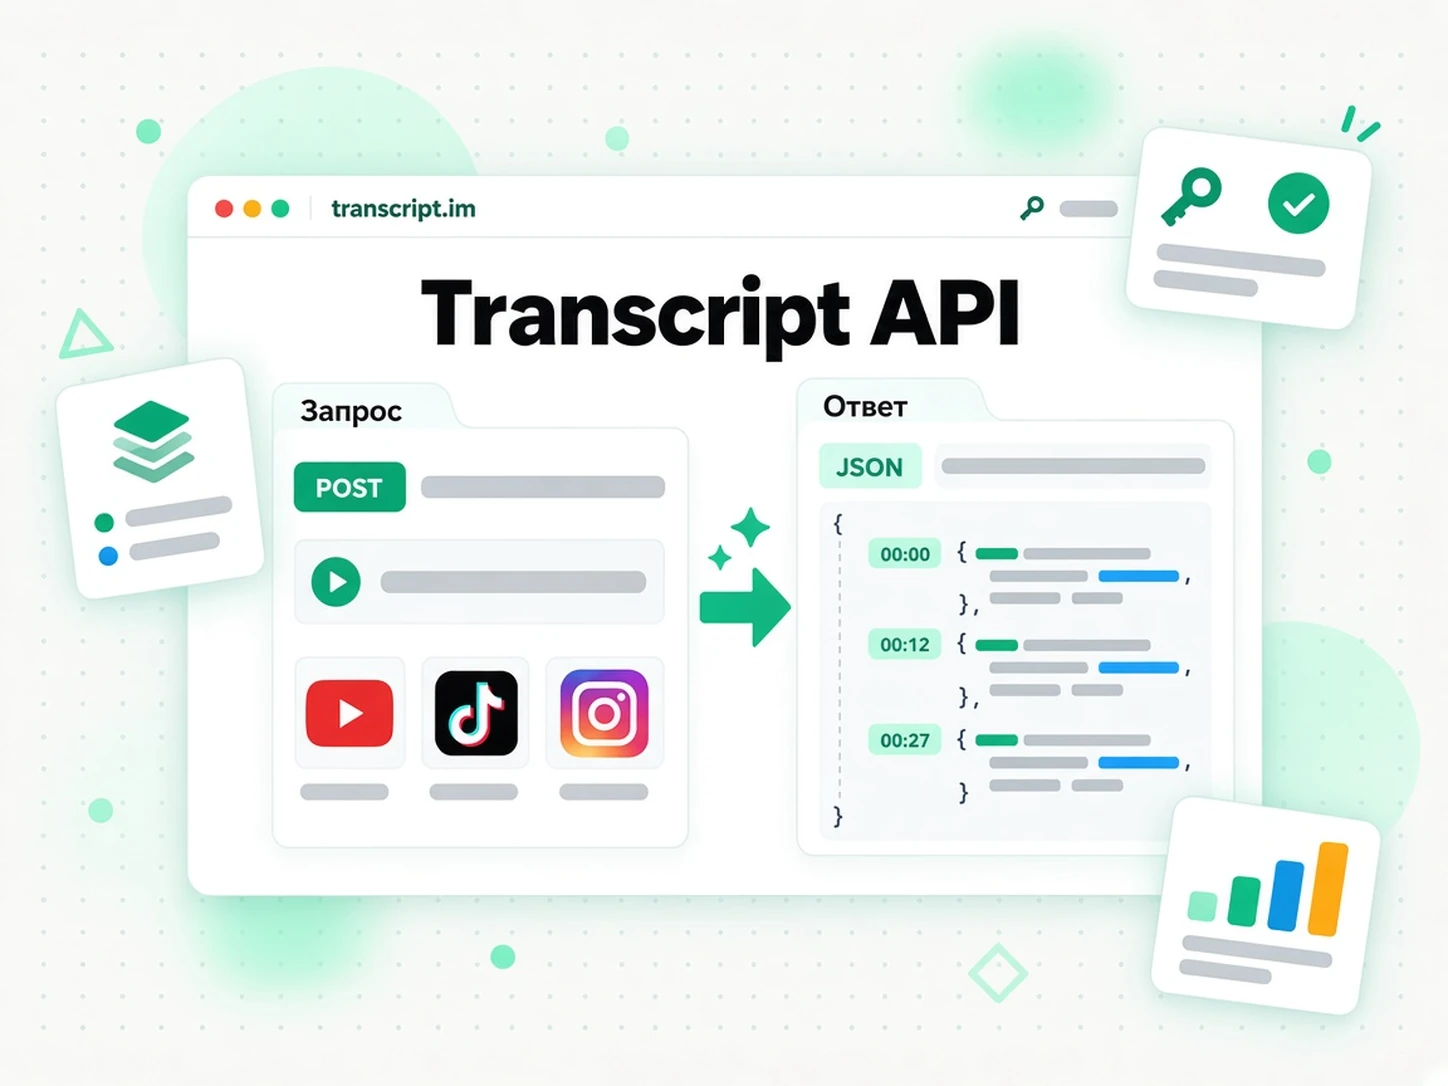
transcript.im открывает тот же конвейер извлечения, на котором работает продукт, как версионированный API транскрибации. Отправьте URL видео или аудио и получите текст с таймкодами в JSON или обычном тексте — платформа определится сама. Сначала используются готовые субтитры; если у видео их нет, AI транскрибирует аудио, а результат доставляется асинхронно.
- Один
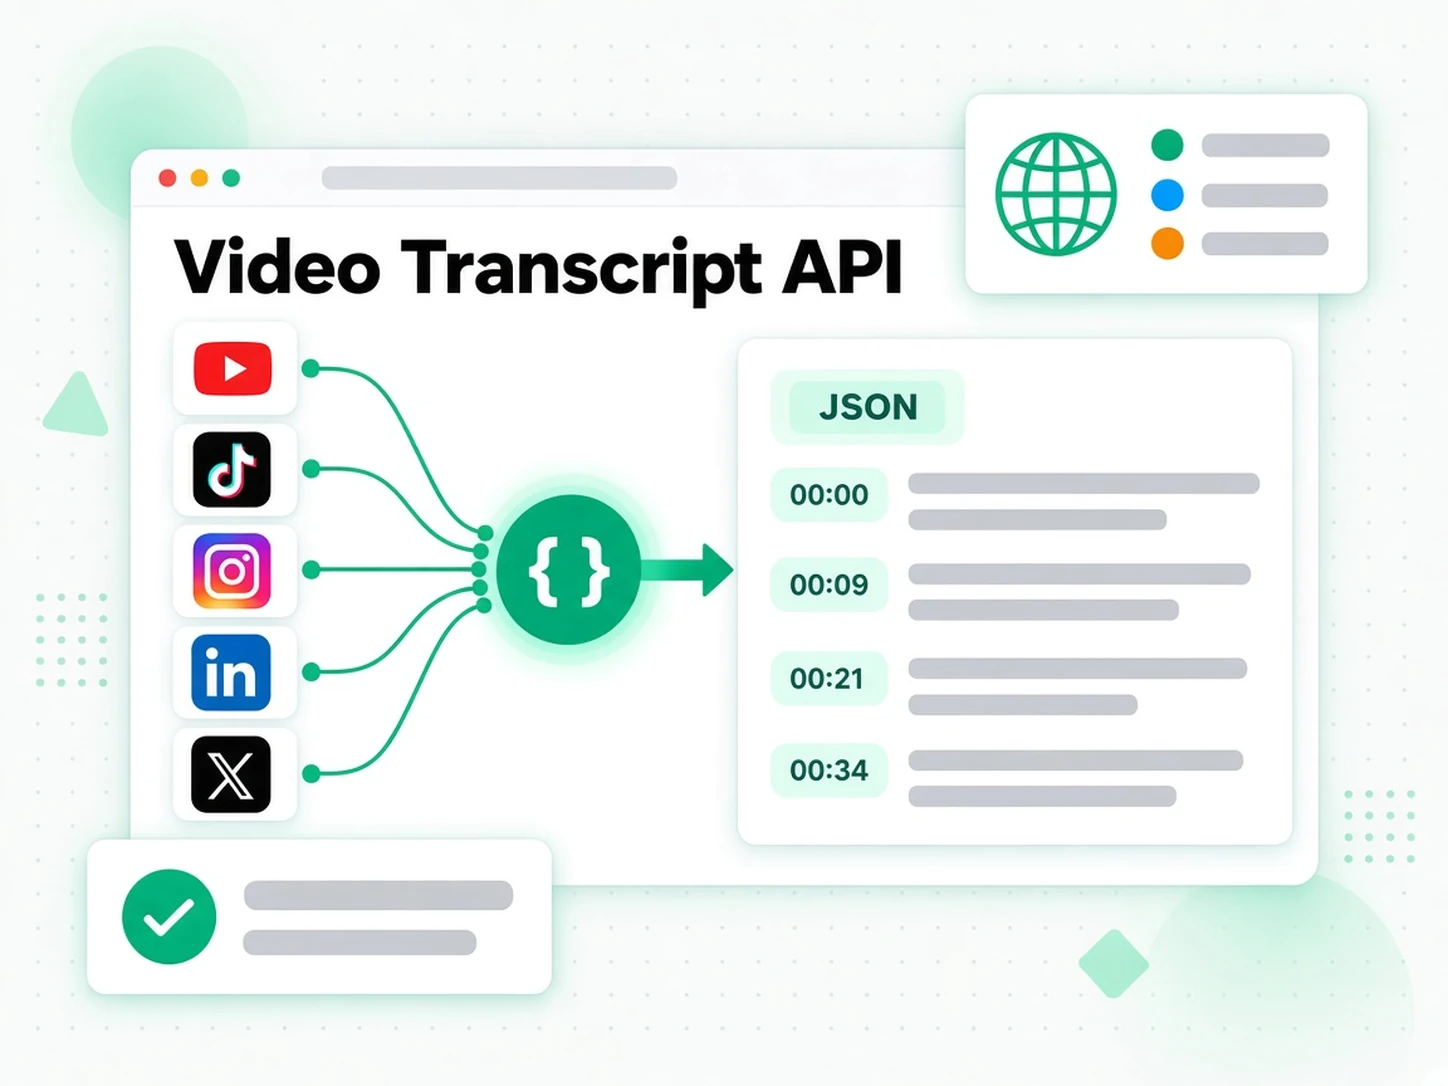
urlпринимает полную или короткую ссылку и определяет YouTube, TikTok, Instagram, LinkedIn и Twitter/X; для YouTube распознаётся и просто id видео, аplatformвместе сexternalIdпокрывают источник, который вы уже знаете. - Сначала используются субтитры; если у видео их нет, AI транскрибирует звук, а загруженный локальный файл всегда отправляется на распознавание речи.
format=jsonвозвращает сегменты с таймкодами, аformat=text— обычный текст, готовый к вставке.- Пакетное извлечение охватывает списки URL, плейлисты и каналы.
- Пакетный экспорт поддерживает txt, csv, json, srt, vtt и zip; сохранённая расшифровка скачивается в txt, srt, vtt, json или md.
- Сохранённые расшифровки хранятся в библиотеке аккаунта, а поиск по YouTube охватывает поиск, видео, каналы, загрузки, плейлисты и субтитры.
- Полный контракт опубликован в виде документа OpenAPI.
Что делает API transcript.im
API transcript.im превращает публичную ссылку на видео или аудио в расшифровку с таймкодами, которую ваш продукт может читать, хранить, искать или передавать в модель. Вы отправляете URL; API определяет платформу, ищет уже существующую дорожку субтитров автора и возвращает текст с таймкодом в каждой строке. Если у видео вообще нет субтитров, API не останавливается на ошибке — он переключается на AI-транскрипцию озвучки, чтобы тот же запрос всё равно дал текст.
- Один запрос — реальный текст: разрешите ссылку и получите сегменты расшифровки с таймкодами или простой текст.
- Субтитры в первую очередь, AI во вторую — используйте дорожку автора, когда она есть, и распознавайте аудио, когда её нет.
- Асинхронность по умолчанию для ASR — id задачи позволяет опрашивать длинную транскрипцию, не блокируя запрос.
- Учёт языков — укажите приоритет языка и получите обратно язык, который определил API.
- Независимость от платформы — вызывающему не нужно знать, где размещено видео.
Один API расшифровки для пяти платформ
YouTube
Расшифровки для любого публичного видео YouTube, Short или прямой трансляции: сначала используются субтитры автора, а при их отсутствии — AI-транскрипция. YouTube — ещё и платформа с полным набором функций поиска — поиск, видео, каналы, загрузки, плейлисты и субтитры — доступных вместе с самой расшифровкой. Архив канала или плейлист превращается в пакет расшифровок с таймкодами, а одиночная ссылка возвращается как читаемый текст, по которому можно искать.
TikTok
Расшифровки для публичных видео TikTok: сначала используются субтитры, а распознавание речи служит запасным вариантом. Вставьте ссылку на видео и читайте озвученный текст как чистый текст с таймкодами, который можно переиспользовать, переводить или цитировать. Один и тот же вызов охватывает и короткий клип, и длинную загрузку, поэтому тренд, туториал и говорящая голова — всё возвращается текстом.
Расшифровки для публичных Instagram Reels и видеопостов. У Instagram нет дорожки субтитров, поэтому извлечение — это асинхронное распознавание речи: отправьте ссылку, опрашивайте задачу и заберите текст, когда он будет готов. Так Reels становится пригодным для цитирования и поиска, хотя платформа никогда не публиковала его слова в виде текста.
Расшифровки для публичных видеопостов LinkedIn: сначала используются субтитры, а распознавание речи служит запасным вариантом. Результат приходит с таймкодами, поэтому выступление, продуктовый клип или записанная встреча становятся текстом с поиском, который можно цитировать и переиспользовать. Извлеките тезисы из записи вебинара или превратите апдейт основателя в черновик, который можно редактировать.
Twitter/X
Расшифровки для публичных видеопостов X. У X нет дорожки субтитров, поэтому извлечение идёт через асинхронное распознавание речи: отправьте ссылку, опрашивайте задачу и заберите текст с таймкодами, по которому можно искать. Точно цитируйте видео или сохраните его озвученный контент в архив, пока пост не отредактировали или не удалили.
Как проходит запрос на расшифровку
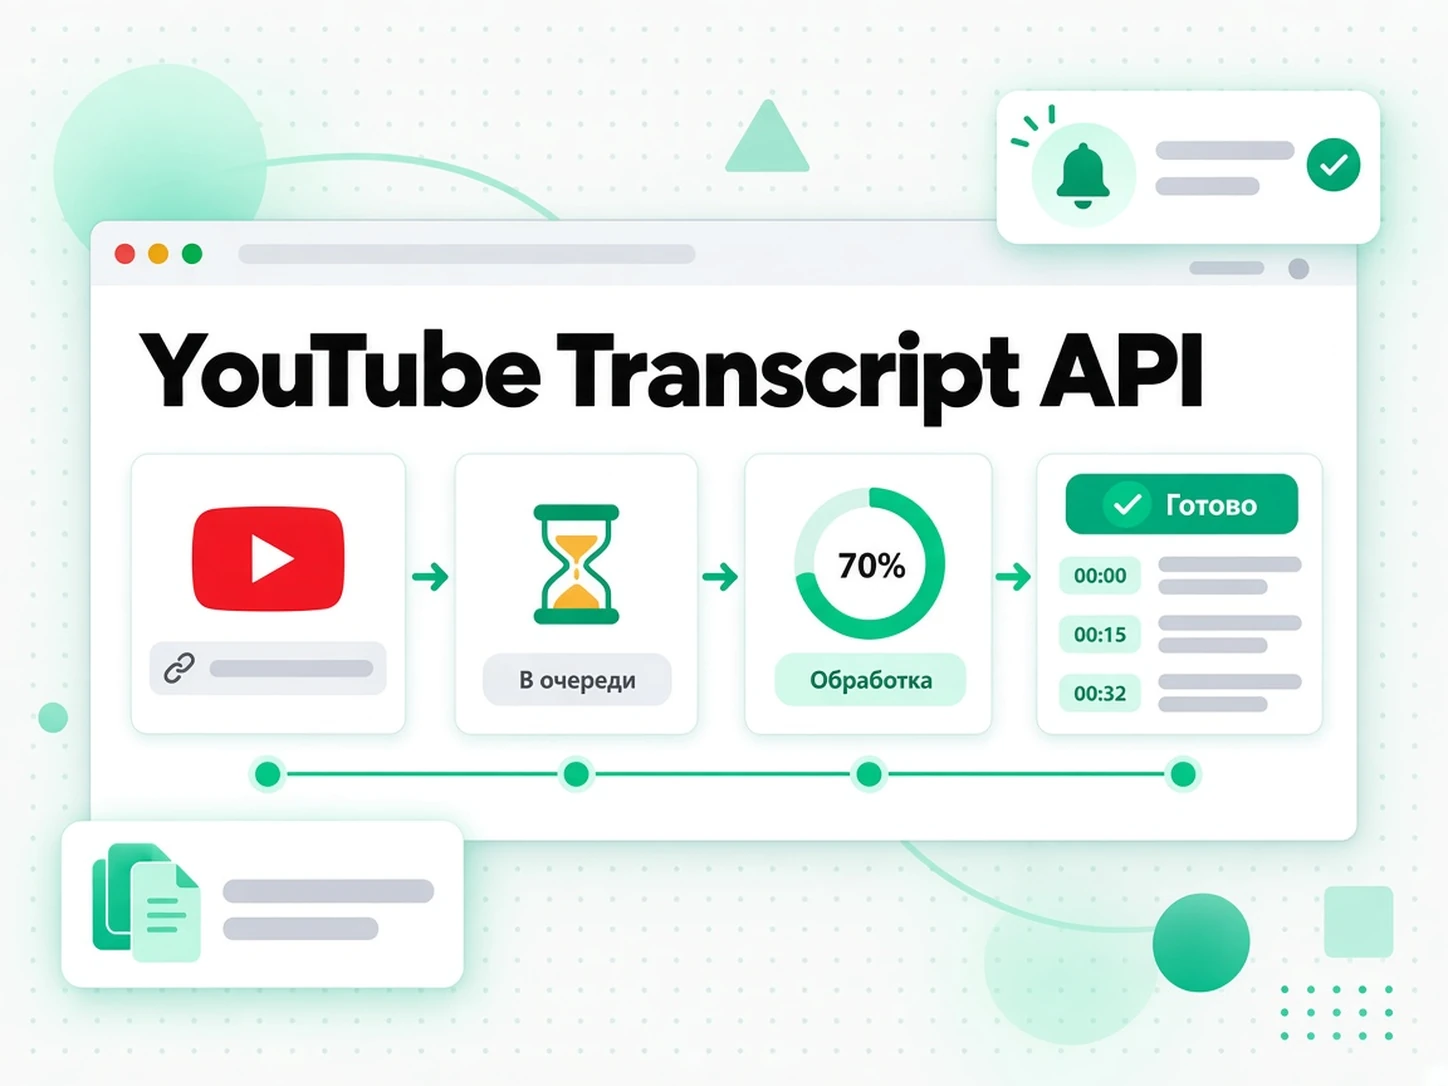
Один вызов проводит ссылку или загруженный файл от входа до расшифровки, и API сообщает, какой путь он выбрал.
- Отправьте источник — передайте
url, укажитеplatformиexternalId, если вы их уже знаете, или загрузите файл какmultipart/form-dataна тот же endpoint. - Получите совпадение по субтитрам — когда у видео есть субтитры на языке из вашего списка, расшифровка возвращается в ответе.
- Обработайте промах по языку — когда субтитры есть, но ни одни не совпадают с вашим списком, запрос продолжается AI-транскрипцией и возвращает
202с id задачи;404сavailableLanguagesвозвращается только тогда, когда распознавание речи не разрешено для вызывающего. - Принудительно используйте ASR или переходите к нему — явная запись
asr, видео вообще без дорожки субтитров или загруженный файл запускают задачу ASR и возвращают id задачи. - Опрашивайте или подпишитесь на поток — читайте задачу через
GET /v1/transcript/job/{id}, пока она не завершится успешно или с ошибкой, либо подпишитесь на её поток/eventsдля прогресса через server-sent. Запрос задачи возвращает200даже для неудачной задачи, поэтому ветвитесь по полюstatus. - Прочитайте результат — готовая расшифровка содержит определённый язык, длину, сегменты с таймкодами и, если запрошено, метаданные: название, автора и дату публикации.
- Повторяйте безопасно — уже извлечённая расшифровка отдаётся из кэша вместо запуска новой задачи, поэтому тот же источник можно запросить снова.
- Сначала проверьте —
GET /v1/transcript/infoразрешает источник и перечисляет языки, которые он может обслужить, прежде чем вы запустите извлечение.
202 с id задачи, а действительно отсутствующий ресурс или запрещённый запасной вариант возвращает 404. Каждый путь возвращает одну и ту же структуру расшифровки, как только текст готов.Пакетное извлечение и экспорт
Реальные задачи редко ограничиваются одним видео, поэтому API принимает пакет в виде списка URL, плейлиста или канала. Каждый пакет ведёт собственную статистику — сколько элементов в ожидании, сколько успешно и сколько не удалось — и возвращает элементы постранично, чтобы длинный канал не приходил одним огромным набором данных.
- Три формы пакета —
POST /v1/batchпринимает список URL, плейлист или канал в зависимости от отправленного тела запроса. - Независимый статус — одна неудачная ссылка отмечается отдельно и никогда не отбрасывает остальной пакет; неудачные элементы можно повторить через
/retry. - Постраничные элементы — читайте пакет через
GET /v1/batch/{batchId}, затем следуйте по возвращённому токену страницы для оставшихся элементов. - Прогресс в реальном времени — каждый опрос возвращает обновлённые счётчики, поэтому вызывающий может показать, какая часть длинного запуска завершена.
- Экспорт в вашем формате — скачайте готовый пакет из
/exportв видеtxt,csv,json,srt,vttилиzip.
srt и vtt сразу попадает в редактор или плеер. Для архива csv, json и zip сохраняют целую библиотеку записей как единый корпус с поиском. Форматы совпадают с ответами для одиночной расшифровки, поэтому потребитель, обрабатывающий один результат, уже умеет читать пакет.Сохранённые расшифровки в библиотеке аккаунта
Извлечение и хранение разделены: расшифровка становится частью библиотеки аккаунта после сохранения, и именно в библиотеке вы позже читаете, ищете, скачиваете и удаляете её без повторного запуска извлечения.
- Список сохранённого —
GET /v1/library/transcriptsпостранично перебирает расшифровки аккаунта, записи пакетов и строки истории неудач с поиском, фильтрами по платформе и языку и сортировкой. - Чтение одного элемента —
GET /v1/library/transcripts/{platform}/{externalId}возвращает сохранённую расшифровку по платформе и external id или для указанного вами языка. - Скачивание — маршрут
/downloadэкспортирует сохранённую расшифровку в видеtxt,srt,vtt,jsonилиmd. - Связанный контент — маршрут
/relatedперечисляет другие сохранённые элементы с того же канала. - Удаление —
DELETEубирает элемент из библиотеки, не затрагивая копии других. - Чтение в рамках аккаунта — запрос к библиотеке возвращает только то, что сохранил аккаунт, и никогда не запускает новое извлечение, поэтому повторное обращение к сохранённой расшифровке — это чтение, а не новая задача.
Поиск по YouTube помимо расшифровок
YouTube — платформа, где API также отвечает на вопросы вокруг расшифровки, используя те же имена ресурсов, что и YouTube Data API.
- Поиск —
GET /v1/youtube/searchнаходит видео, каналы или плейлисты по запросу и возвращает результаты с постраничной навигацией по курсору. - Видео —
GET /v1/youtube/videosвозвращает сведения о видео, включая наличие субтитров. - Каналы —
GET /v1/youtube/channelsразрешает канал по id или@handle. - Загрузки канала —
GET /v1/youtube/channels/{channelId}/videosперебирает загрузки канала. - Элементы плейлиста —
GET /v1/youtube/playlists/{playlistId}/itemsперебирает плейлист. - Субтитры —
GET /v1/youtube/captionsвозвращает метаданные дорожки субтитров и текст субтитров для видео. Он никогда не запускает задачу распознавания речи: когда он сообщаетrequiresAsync, вызовитеPOST /v1/transcript, чтобы выполнить транскрипцию.
Создан для продакшена
Интерфейс намеренно компактный, а всё, что важно для сервиса, задокументировано, а не оставлено на догадки.
- Один ключ доступа — аутентификация по API-ключу, передаваемому как Bearer-токен, либо через
X-API-Keyиз скрипта или с сервера. - Ключи с областями доступа — выдавайте только те области, которые нужны вызывающей стороне;
transcriptsиbatchesпокрывают извлечение и пакетную обработку. - Структурированные ошибки — сбои извлечения и валидации возвращают объект ошибки со стабильным
codeи понятнымmessage; ответы аутентификации (401) и ограничения частоты (429) используют более простой плоский формат ошибки. - Понятные лимиты — запрос, превысивший лимит частоты, возвращает
429сRetry-After, а успешные ответы содержат заголовкиX-RateLimit-*, чтобы клиент мог корректно выждать паузу. - Опубликованный контракт — полный документ OpenAPI лежит в основе API, так что вы можете сгенерировать клиент, поднять мок сервера или проверить реальные ответы на соответствие схеме.
- Двойник для агентов — тот же аккаунт и инструменты доступны через MCP-сервер transcript.im, если ваш клиент — это AI-клиент, а не сервис.
Связанные
Частые вопросы об API транскрибации
Что такое API transcript.im?
API transcript.im — это REST-интерфейс, который превращает публичную ссылку на видео или аудио в расшифровку с таймкодами: сначала используются готовые субтитры, а если их нет — AI-транскрибация.
Какие платформы поддерживает API transcript.im?
Он извлекает расшифровки из YouTube, TikTok, Instagram, LinkedIn и Twitter/X, определяя платформу по отправленной ссылке. Для YouTube, TikTok и LinkedIn сначала используются субтитры, а распознавание речи — как запасной вариант; у Instagram и X дорожки субтитров нет, поэтому сразу применяется распознавание речи.
Что происходит, если у видео нет субтитров?
Если у видео вообще нет дорожки субтитров, API запускает задачу ASR и возвращает id задачи; вы опрашиваете эту задачу, пока расшифровка не будет готова, поэтому запрос никогда не блокируется на распознавании речи.
Можно ли расшифровать локальный аудио- или видеофайл?
Да. POST /v1/transcript принимает тело multipart/form-data с частью file вместо URL. Загруженный файл сразу отправляется на распознавание речи, поэтому возвращается задача 202 — или результат 200, если обработка успевает уложиться в бюджет ожидания.
Может ли API transcript.im возвращать таймкоды вместе с текстом?
Да. Ответы в JSON содержат сегменты с таймкодами, а текстовые ответы могут сохранять префикс с таймкодом в каждой строке, чтобы вы могли вернуться к моменту, когда была произнесена строка.
Как запросить расшифровку на определённом языке?
Отправьте список приоритета языков через запятую, включая записи asr и asr-<code>. Совпадение по субтитрам возвращается сразу; если субтитры есть, но ни одни не совпадают со списком, запрос переходит к AI-транскрибации и возвращает задачу 202, а 404 со списком доступных языков возвращается только тогда, когда распознавание речи запрещено.
Как узнать, что асинхронная расшифровка готова?
Опрашивайте GET /v1/transcript/job/{id} с тем же ключом доступа, пока он не сообщит success или failed, либо подпишитесь на GET /v1/transcript/job/{id}/events для обновлений через server-sent events. Запрос статуса задачи возвращает 200, даже если задача завершилась с ошибкой, поэтому читайте поля status и error, а не HTTP-код.
Поддерживает ли API transcript.im пакетное извлечение?
Да. Пакет принимает список URL, плейлист или канал, отслеживает статус каждого элемента и возвращает элементы постранично.
В каких форматах можно скачать результат?
Готовый пакет экспортируется в txt, csv, json, srt, vtt или zip; отдельная сохранённая расшифровка скачивается в txt, srt, vtt, json или md.
Где хранятся сохранённые расшифровки?
Сохранённые расшифровки и записи пакетов хранятся в разделе Library аккаунта, по пути /v1/library. Он предоставляет маршруты list, read, download, related и delete, а его чтение ограничено рамками аккаунта и никогда не запускает новое извлечение.
Что возвращает эндпоинт субтитров YouTube?
GET /v1/youtube/captions возвращает метаданные дорожки субтитров видео вместе с текстом субтитров. Он никогда не запускает задачу распознавания речи; когда он сообщает requiresAsync, вызовите POST /v1/transcript, чтобы запустить расшифровку.
Как API transcript.im сообщает об ошибках и лимитах частоты?
Ошибки извлечения и валидации используют объект с code и message; аутентификация возвращает плоский 401, а ограничение частоты — плоский 429 с Retry-After и заголовками X-RateLimit-*, чтобы клиент мог корректно выждать паузу.
Добавьте расшифровки в свой продукт
Создайте API-ключ, отправьте ссылку на видео или локальный файл и получите расшифровку обратно в виде JSON или простого текста.