
Оформление расшифровки интервью: практическое руководство
Лучшие практики оформления расшифровки интервью для чистого текста: метки спикеров, тайм-коды, дословная и очищенная запись, советы по публикации.
Транскрипт может выглядеть готовым и при этом оставаться почти бесполезным. Аудио лежит в папке, файл автосубтитров тоже на месте, и всё равно кому-то приходится превращать этот хаос во что-то, что журналист сможет цитировать, исследователь — кодировать, а продюсер — экспортировать, не сломав тайминг. Именно здесь оформление транскрипта интервью начинает работать по-настоящему, ведь одно и то же интервью можно превратить в совершенно разные материалы — в зависимости от того, кому оно нужно дальше.
Первая ошибка — относиться к вёрстке как к украшению. Это не так. Продуманный блок заголовка, аккуратные обозначения спикеров, таймкоды, пометки в квадратных скобках и разумное разбиение на абзацы делают транскрипт читаемым в Word, переносимым в PDF и более удобным для дальнейших форматов текстового экспорта. Именно поэтому институциональные руководства снова и снова сходятся на одних и тех же основах: поля в 1 дюйм, шрифт 12 пунктов, выравнивание по левому краю и видимые маркеры страниц в архивных процессах. Если перед созданием собственного шаблона вам нужна точка отсчёта для подачи структурированного отчёта, полезно также посмотреть профессиональные форматы отчётов, чтобы увидеть, как документальная структура меняет восприятие файла.
Командам, которые начинают с аудио, а не с готового файла, до начала чистки может помочь быстрый процесс захвата. Практичная отправная точка — процесс транскрибации аудио, после чего структуру транскрипта накладывают поверх черновика, вместо того чтобы придумывать формат и содержание одновременно.
Почему оформление транскрипта интервью важно ещё до начала записи
90-минутное интервью попадает в общую папку одним аудиофайлом и черновым дампом автосубтитров. К утру младший редактор должен вытащить пригодные цитаты, сохранить имена и привести файл к достаточно единому виду, чтобы никому не пришлось разбирать его дважды. Именно в этот момент вёрстка перестаёт быть косметикой и становится системой редактирования.
Самый быстрый способ потерять время — сначала транскрибировать, а форматировать потом. Переделка длинного транскрипта задним числом означает правку каждой реплики спикера, каждого таймкода и каждой пометки о паузах или наложении. Зафиксированный шаблон избавляет от этой чистки. Он также позволяет использовать одно интервью в самых разных материалах, ведь файл цитат для редакции, транскрипт для качественного кодирования, архивная копия и черновик субтитров не требуют одинаковой детализации.
Решение о вёрстке начинается с того, как материал будет использоваться дальше.
Транскрипту для кодирования нужны единообразные реплики спикеров и структура, которую аналитики могут быстро просматривать. Архивному транскрипту нужны происхождение и консервативная дословная обработка. Опубликованному материалу нужна читаемость. Работе с субтитрами или подписями нужна дисциплина тайминга, а не литературная отделка. Стройте вёрстку под задачу — и вы сократите доработки. Вы также не станете переносить один редакционный стиль в каждый проект.
Командам, которые начинают с аудио, а не с готового файла, до начала чистки может помочь быстрый процесс захвата. Практичная отправная точка — процесс транскрибации аудио, после чего структуру транскрипта накладывают поверх черновика, вместо того чтобы придумывать формат и содержание одновременно. Если вам нужен ориентир для того, как файл читается на странице, полезно также посмотреть профессиональные форматы отчётов, прежде чем остановиться на собственном шаблоне.
Блоку заголовка тоже стоит уделить внимание заранее, потому что он готовит файл к дальнейшему использованию. Я считаю его частью транскрипта, а не сопроводительной запиской. Чистый транскрипт обычно начинается с названия и метаданных, а затем переходит к диалогу.
Солидное институциональное руководство от American Folklife Center задаёт полезную базовую линию для файлов устной истории. Оно требует полей в 1 дюйм, шрифта Times New Roman 12 пунктов, выравнивания по левому краю, отсутствия отступов у реплик спикеров и исключения фигурных кавычек из финального файла. Номера страниц размещаются внизу по центру, а на обложке и страницах предисловия их нет.
Эти правила существуют не только ради стиля. Они сохраняют транскрипт читаемым в Word, стабильным в PDF и более удобным для переноса в архивные системы или форматы текстового экспорта без нарушения выравнивания. Для редактора это и есть проверка.
Основные строительные блоки чистого транскрипта интервью
Чистый транскрипт обычно начинается с блока заголовка, который фиксирует основные данные до начала диалога. Я бы считал этот блок обязательными метаданными, потому что и архивы, и редакционные команды полагаются на него, чтобы файл оставался читаемым в будущем.
Практичный заголовок может включать:
- Название интервью
- Дата
- Место или носитель
- Имя интервьюера
- Имя и роль собеседника
- Длительность записи
Остальная часть файла читается лучше, когда каждую реплику говорящего легко просмотреть. Строгое институциональное руководство от American Folklife Center утверждает, что транскрипты устной истории должны начинаться с заголовка и метаданных, иметь поля шириной 1 дюйм, шрифт Times New Roman 12-го кегля, выравнивание по левому краю, без отступов для реплик говорящих, без «фигурных» кавычек, а номера страниц должны располагаться внизу по центру, причём на обложке и титульных страницах номера страниц быть не должно. Такая же документальная структура встречается в архивных руководствах, которые требуют указывать имена, даты, места и сведения о версиях до начала диалога, потому что эти детали помогают индексировать и впоследствии цитировать. Для полноценного редакторского процесса ведущие платформы для транскрибации интервью часто предлагают те же структурные решения в своих инструментах экспорта и редактирования.
Метки говорящих и размещение меток времени
Метки говорящих должны оставаться единообразными. Три распространённых варианта хорошо показывают себя на практике:
- ИМЕНА ЗАГЛАВНЫМИ БУКВАМИ, когда нужна максимально быстрая просматриваемость
- Ролевые метки, например ИНТЕРВЬЮЕР и РЕСПОНДЕНТ, когда важна анонимность
- Полное имя при первом упоминании, а затем только фамилия, когда важна архивная точность
Ещё одно архивное руководство добавляет, что при первом упоминании следует использовать полное имя, а затем переходить к фамилии. Другое руководство по транскрибации требует, чтобы метки времени появлялись минимум раз на странице и в реальном времени, с двумя пробелами после метки времени перед началом текста. Для файлов, которым нужна возможность поиска, я предпочитаю строку с меткой времени над репликой, но встроенные метки времени подходят, когда нужен более плотный поток чтения в Word или Google Docs.
Практическое правило: если вы ожидаете дальнейшее редактирование, ставьте метки времени туда, где их проще всего просмотреть и меньше всего шансов случайно удалить.
Невербальные сигналы и разбиение на абзацы
Подсказки в квадратных скобках должны оставаться осмысленными. Распространённые примеры: [смех], [пауза], [неразборчиво] и [00:42:15 наложение речи]. Они важны, когда пауза меняет смысл или наложение речи влияет на атрибуцию, но не должны заполонять страницу только потому, что они есть в аудио.
Новый абзац должен начинаться с метки нового говорящего, а не с абзацного отступа для продолжения. Так файл остаётся удобочитаемым после копирования в поля CMS, инструменты субтитров или системы проверки, работающие только с текстом. Простой рабочий файл может выглядеть так:
Интервью по проекту, 12 марта 2026, Zoom
Интервьюер: Mia Chen
Гость: Jordan Lee, продакт-менеджер
00:01:12
MIA: Спасибо, что присоединились. Не могли бы вы подробно рассказать о запуске?
00:01:16
JORDAN: Конечно. У нас были сжатые сроки, и команда всё ещё определялась с окончательным объёмом работ. [пауза]
00:01:24
MIA: Что изменилось первым?
Такой формат прост, но даёт редакторам нужные им ориентиры.
Дословные и очищенные транскрипты
Самый полезный способ думать о стиле транскрипта — как о континууме, а не о бинарном выборе. На одном конце — строгое дословное воспроизведение, которое сохраняет обрывы, слова-заполнители и заикания. В середине — разумное дословное воспроизведение, которое убирает часть мусора, но сохраняет смысл и ритм речи говорящего. На другом конце — очищенный транскрипт для удобного чтения, который сохраняет идеи, но убирает всё, что замедляет чтение страницы.
| Оригинальный устный обмен репликами | Дословная версия | Очищенная версия |
|---|---|---|
| «Ну, э-э, я, я думаю, мы как бы, типа, пропустили срок, потому что поставщик, э-э, изменил формат файла.» | «Ну, э-э, я, я думаю, мы как бы, типа, пропустили срок, потому что поставщик, э-э, изменил формат файла.» | Я думаю, мы пропустили срок, потому что поставщик изменил формат файла. |
| «Нет, я имею в виду, команда действительно пыталась, но у нас ещё не было окончательных цифр.» | «Нет, я имею в виду, команда действительно пыталась, но у нас ещё не было окончательных цифр.» | Команда действительно пыталась, но у нас ещё не было окончательных цифр. |
Когда строгое дословное воспроизведение оправдано
Дословные транскрипты — самый безопасный выбор, когда сама формулировка является записью. Они защищают от обвинений в фабрикации цитат, сохраняют модели колебаний, важные для лингвистического или психологического анализа, и лучше выдерживают юридическую проверку, чем отполированная переработка. При этом они обычно раздувают объём текста и плохо читаются на странице, поэтому редко бывают лучшим вариантом для публичной статьи.
Очищенные транскрипты делают противоположное. Их проще цитировать в опубликованном материале, проще просматривать в резюме для руководства, и обычно они удобнее для сценариев доступности, потому что синтаксис менее рваный. Обратная сторона — необходимость суждения, потому что редактору приходится решать, какие заполнители являются шумом, а какие обрывы передают неуверенность, акцент или интонацию.
Этическая граница
Качественные исследования, устная история и показания под присягой часто оправдывают более буквальный транскрипт. Журналистика и контент-маркетинг часто требуют в первую очередь удобочитаемости. Если вы планируете опубликовать прямую цитату, не очищайте её и не выдавайте за дословную. Именно здесь у редакторов возникают проблемы, потому что аудитория предполагает, что слова прозвучали именно так.
Самое чистое правило простое. Используйте ту версию, которая соответствует риску результата. Если файл могут проверить, отложить в архив или использовать для обоснования решения, сохраняйте больше разговорной фактуры. Если файл предназначен для быстрого чтения клиентом, руководителем или читателем, аккуратно сократите его и задокументируйте выбор в своём внутреннем стиле. Для команд, которым нужен отдельный этап очистки, рабочий процесс чистой дословной расшифровки — это место, где такая редакторская оценка становится воспроизводимым процессом.
Выбор руководства по стилю и закрепление ваших правил
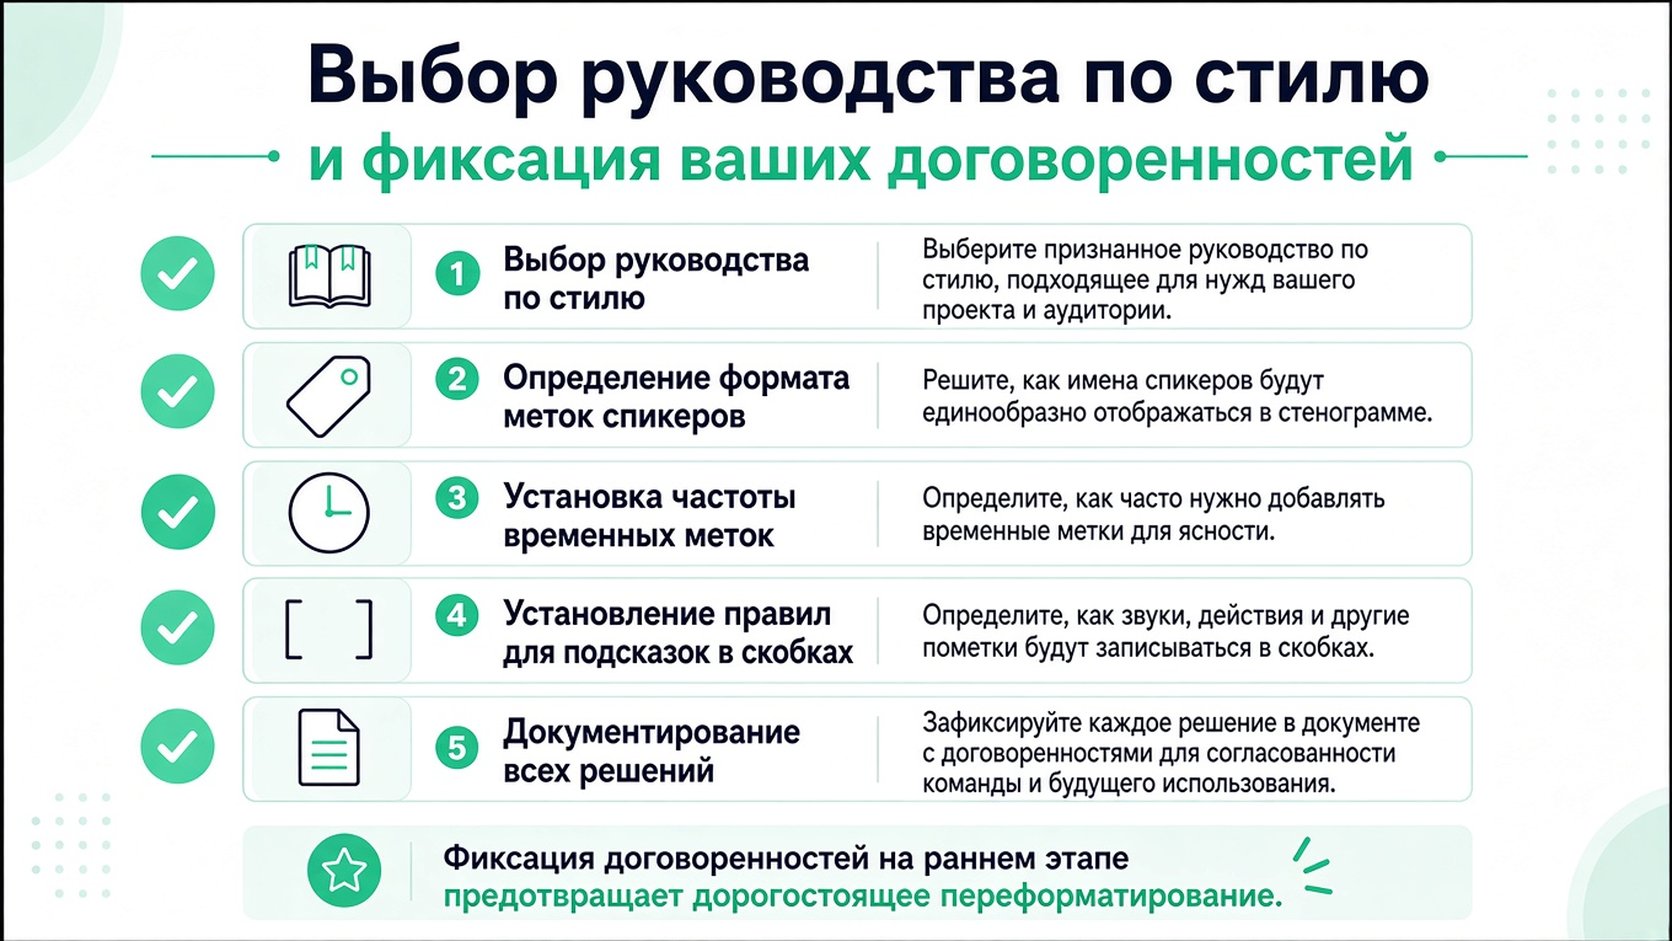
Проект расшифровки становится проще в тот момент, когда вы перестаёте импровизировать. Заимствуете ли вы стиль AP, Chicago, APA или собственный внутренний стиль, само руководство значит меньше, чем последовательность, которая за ним следует, потому что никто не хочет переформатировать двадцать интервью после того, как первый редактор заметит, что метки говорящих не совпадают.
Решения, которые нужно зафиксировать в первую очередь
Перед началом расшифровки урегулируйте эти вопросы и запишите их в одностраничный лист правил:
- Формат меток говорящих — одно правило для каждого файла
- Точность временных меток — один шаблон расстановки пробелов
- Паралингвистические пометки — один стиль скобок
- Обработка слов-заполнителей — один стандарт для повторов и ложных начал
- Правила многоточия и [inaudible] — один точный шаблон использования
Этот лист должен сопровождать проект. Расшифровщик, редактор и проверяющий должны иметь возможность открыть один и тот же документ и увидеть одну и ту же логику.
Чистый лист правил также снижает трение, когда несколько файлов проходят через один и тот же конвейер. Одно и то же интервью может пройти путь от черновика расшифровки к листу цитат, затем в CMS, а затем в экспорт субтитров. Если формат меток меняется на полпути, последующие файлы начинают наследовать мелкие ошибки, которые раздражают при исправлении и легко ускользают от внимания.
Что даёт вам последовательность
Архивные руководства здесь полезны, потому что показывают, сколько работы вкладывается в простую последовательность. Одно университетское руководство требует указывать имена интервьюера и интервьюируемого, дату, место и продолжительность на первой странице, а также номера страниц на каждой странице. Другое архивное руководство требует указывать номер коллекции, имена рассказчиков, имена интервьюеров и дату в шапке, а затем сохранять единую шапку на последующих страницах. Эти решения касаются проверяемости не меньше, чем внешнего вида, и та же логика действует в современных редакционных командах.
Самые сильные команды не обсуждают вёрстку для каждого файла. Они определяют её один раз, а затем соблюдают. Именно это сохраняет расшифровку читаемой, когда она переходит от первичной записи к проверке, и именно это не даёт вашим редакторам тратить время на излишнюю очистку. Встроенное видео ниже будет полезно, если вы хотите взглянуть под другим углом на дисциплину настройки и программный рабочий процесс.
{% youtube id="rhEgDJT_2w0" /%}
Адаптация вёрстки для исследований, архивов, новостей и субтитров
Одно и то же интервью может оказаться в четырёх разных местах, и каждое требует своей вёрстки. Расшифровке для кодирования нужна структура, которую аналитики могут размечать без затруднений. Архивной расшифровке нужны сведения о происхождении, которые остаются понятными спустя годы. Опубликованному интервью нужен удобочитаемый текст. Файлу субтитров нужна синхронизация, соответствующая тому, что зрители успевают воспринимать на экране. Один шаблон редко хорошо подходит всем четырём.
| Результат | Метка говорящего | Временные метки | Уровень дословности | Особенности |
|---|---|---|---|---|
| Качественное исследование | На основе ролей или полные имена | Частые, последовательные | Высокий, с пометками неречевых звуков | Нумерация строк, маркеры перекрытия, удобные для кодирования абзацы |
| Архив устной истории | Полные имена, затем фамилии | Видны на каждой странице | Консервативная дословность | Шапка с метаданными, версионирование, сведения о происхождении |
| Опубликованная статья | Полные имена или роли | Выборочные | Очищено для удобочитаемости | Выносные цитаты, более плотная разбивка на абзацы, строки, готовые к атрибуции |
| Файл субтитров | Метки ролей или короткие имена | Точные вход и выход реплики | Сжато для скорости чтения | Контроль числа символов в строке, время показа, экспорт субтитров |
Файлы для исследований и архивов выполняют разную работу
Качественному исследователю нужен файл, который можно просматривать, кодировать и сравнивать между интервью. Обычно это означает последовательную разбивку на абзацы, маркеры перекрытия и достаточно контекста, чтобы сохранить смысл, не заполняя страницу шумом. Архивные команды хотят более консервативную запись, потому что на расшифровку могут позже ссылаться, и она должна сохранять имена, даты и исходную манеру речи.
Редакционные и издательские процессы требуют другого. Редакторам нужна расшифровка, которая читается чисто: реплики легко атрибутировать, а абзацы не спорят со страницей. Часто это означает убрать лишние слова и уплотнить структуру, сохранив интервью достаточно точным для цитирования. Субтитры добавляют ещё одно ограничение. Файл должен помещаться на экране, учитывать скорость чтения, и каждая реплика должна быть согласована с произнесённой фразой.
Оформление под конкретный процесс лучше универсального
Команды теряют время, когда пытаются применить одну вёрстку ко всем сценариям. Кодировщикам нужна одна версия, сотрудникам архива — другая, а видеомонтажёрам часто нужен экспорт субтитров, который идёт в ином ритме, чем опубликованная расшифровка. Единый исходный файл всё равно помогает, но результат должен меняться в зависимости от следующей задачи.
Когда для одного и того же интервью нужны и версия с исследовательской разметкой, и файл субтитров SRT, помогает такое рабочее пространство, как transcript.im: оно сохраняет расшифровку с таймкодами и позволяет экспортировать TXT и SRT из одного источника, не пересобирая файл вручную. Если сначала нужно перевести видео в текст, тот же процесс сохранит расшифровку готовой к последующему преобразованию в TXT, SRT или VTT — в зависимости от того, что дальше: разметка, публикация или субтитры.
Очистка, простановка таймкодов и экспорт без нарушения синхронизации
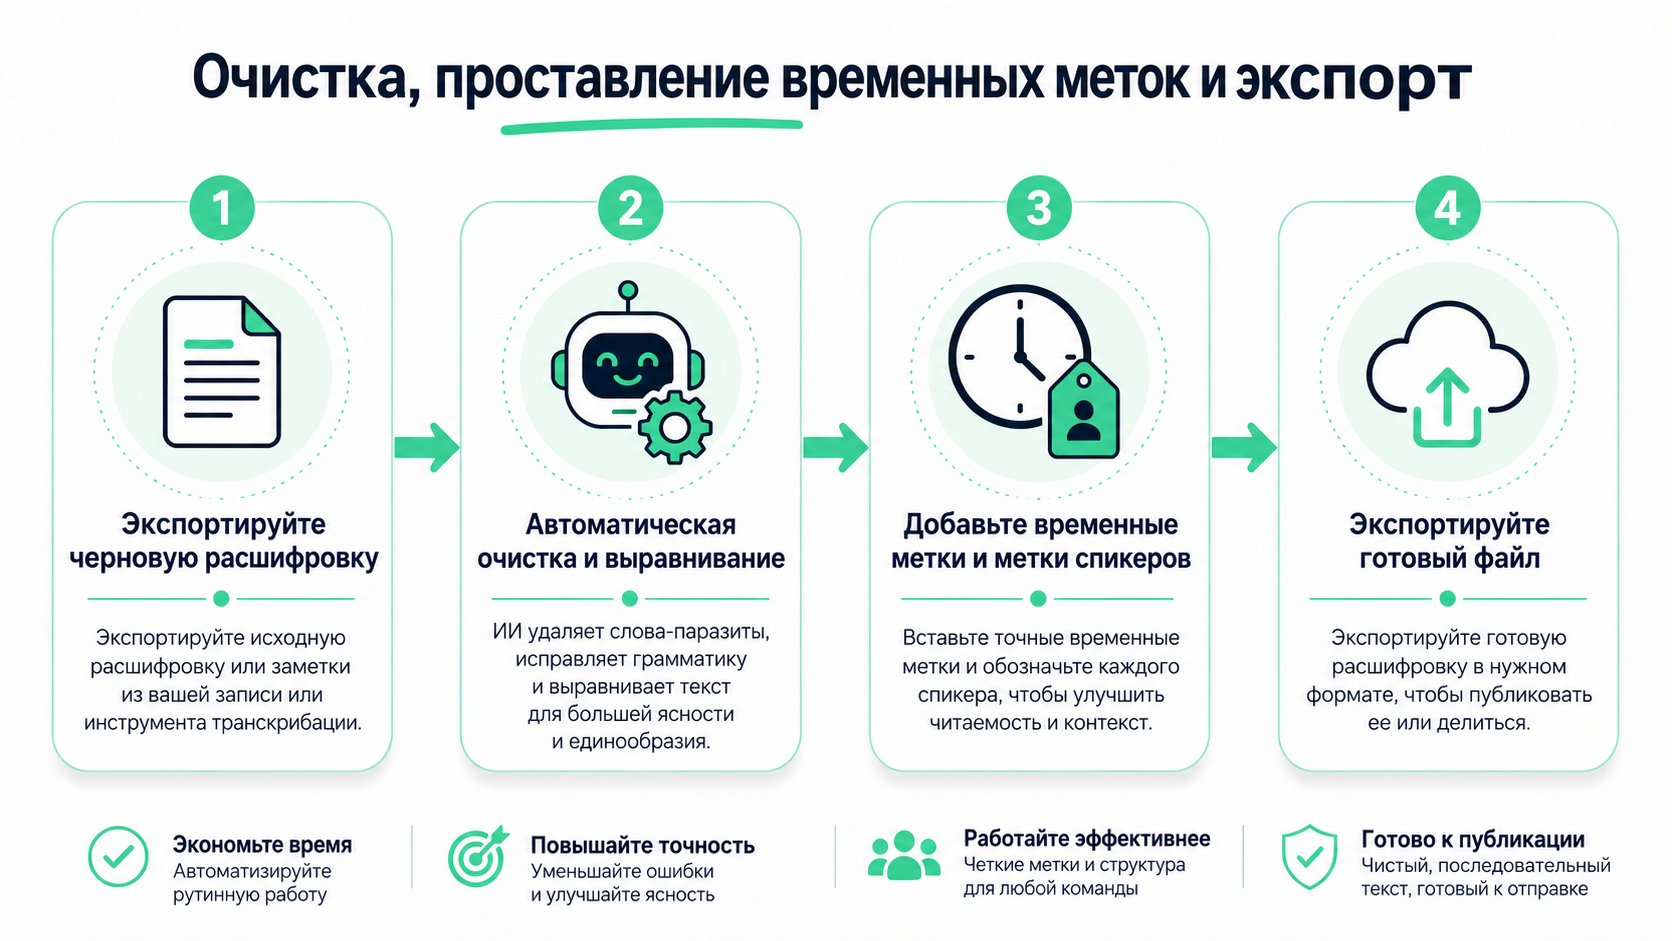
Черновые расшифровки обычно ломаются в одном и том же месте: таймкод перестаёт точно указывать на произнесённую фразу. Как только синхронизация сбивается, ломаются субтитры, поиск по фрагментам становится запутанным, а редакторы теряют доверие к файлу. Самый надёжный подход — сохранять исходный столбец таймкодов, очищая текст вокруг него.
Надёжный проход редактуры
Начните с экспорта автотранскрипции со встроенными таймкодами. Затем сделайте один проход очистки, убирая лишние слова только там, где это действительно нужно для читабельности, сохраняя исходную структуру тайминга нетронутой. Если вы работаете в инструменте с ИИ, относитесь к черновику как к исходной записи, а к очищенной копии — как к презентационному слою.
Согласованность важнее изящества. Расшифровка, которая красиво читается, но указывает не на тот фрагмент аудио, — плохая расшифровка.
Это правило согласованности важно для всех типов экспорта. Файлы Word удобно проверять, но они могут уплощать структуру, если люди неаккуратно удаляют столбцы или переформатируют текст. SRT и VTT сохраняют тайминг субтитров, CSV помогает программам для кодирования и проверке в таблицах, а JSON — обычная форма, когда команды хотят передавать данные расшифровки через API. Формат, который вы выбираете, должен соответствовать следующему шагу, а не только текущему.
Проверьте файл, прежде чем он уйдёт из ваших рук
Одна финальная сверка с аудио стоит потраченного времени. Прослушайте несколько неловких стыков, убедитесь, что метки говорящих по-прежнему совпадают, и проверьте, что ни один проход очистки не сдвинул строку, с которой начинается цитата. Если вы используете процесс, включающий перевод, очистку или пакетный экспорт, оставляйте исходник с таймкодами нетронутым, чтобы более поздние версии всё ещё можно было отследить до оригинальной речи.
Для команд, которые хотят перейти от аудио к пригодному черновику до этапа редактуры, процесс расшифровки аудио в текст — практичная отправная точка. Сохранять синхронизацию гораздо проще, когда первый черновик уже содержит нужную структуру тайминга.
Краткий чек-лист для вашей следующей расшифровки интервью
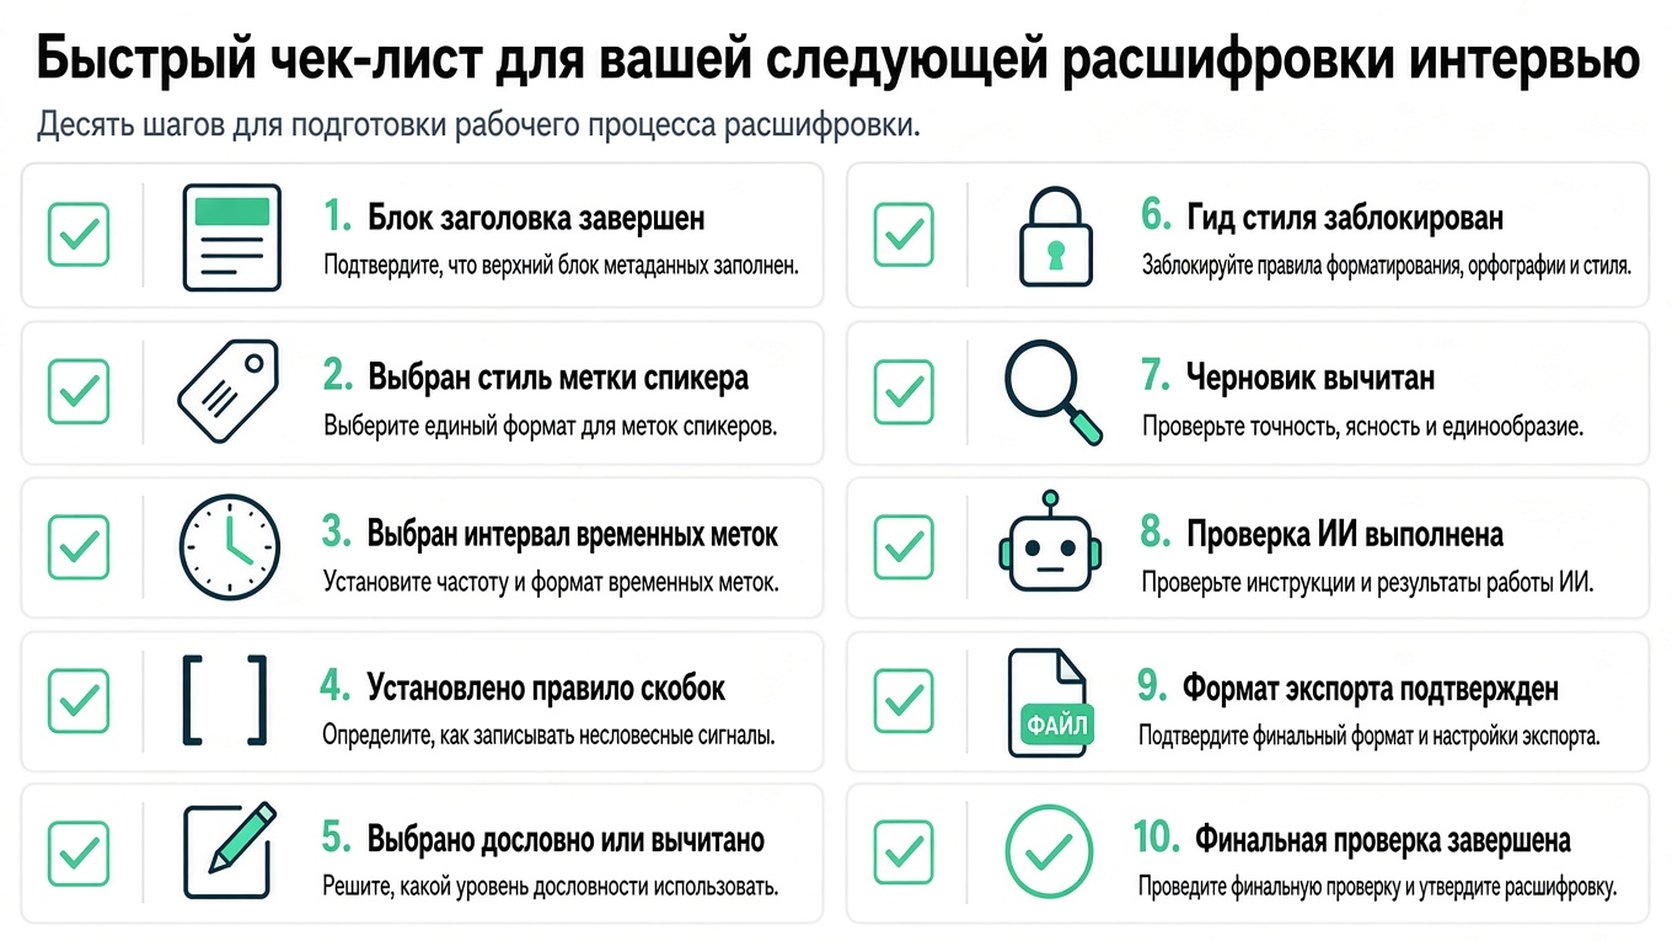
Используйте это как одностраничную памятку рядом с вашим инструментом транскрибации.
- Заполните блок заголовка: название, дата, место или носитель, интервьюер, интервьюируемый и длительность.
- Выберите один стиль меток говорящих и не меняйте его в течение проекта.
- Задайте интервал таймкодов и решите, будет ли он на отдельной строке или внутри текста.
- Определите правила для пометок в скобках: паузы, смех, наложение речи и неразборчивое аудио.
- Решите, нужна дословность или очищенный вариант, до того как первый черновик начнут править.
- Зафиксируйте руководство по стилю, которого придерживаетесь, даже если это собственный внутренний стиль.
- Вычитайте имена и термины по аудио и любым исходным заметкам.
- Проверьте синхронизацию ИИ, чтобы таймкоды по-прежнему указывали на нужную речь.
- Подтвердите формат экспорта: Word, TXT, SRT, VTT, CSV или JSON.
- Проведите финальную проверку одного короткого раздела, прежде чем выпускать весь файл.
{"translation": "45-минутное интервью обычно проходит гладко, когда порядок действий стабилен. Импортируйте аудио, сгенерируйте первый черновик, примените стиль расшифровки, приведите в порядок реплики спикеров, сверьте тайм-коды с записью, а затем экспортируйте итоговый файл в том формате, который нужен следующей команде. Вопросы оформления, которые важнее всего, — это те, что вы фиксируете перед началом правок, а не после того, как файл уже разошёлся по папкам.\n\n---\n\nЕсли вам нужно рабочее пространство, в котором расшифровки остаются читабельными, с тайм-кодами, и их проще переиспользовать в публикациях, исследованиях и работе с субтитрами, зайдите на транскрибация и попробуйте на следующем интервью. Он помогает превращать аудио и видео в структурированный текст, не начиная с чистого листа, так что вы тратите меньше времени на исправление оформления и больше — на работу с самой расшифровкой."}
Транскрибация
Превратите любое видео в текст
Вставьте ссылку YouTube, TikTok или Instagram и читайте транскрипт с отметками времени в каждой строке.
Экспорт в TXT, SRT или VTT.