
REST API
API de transcripciones para video y audio
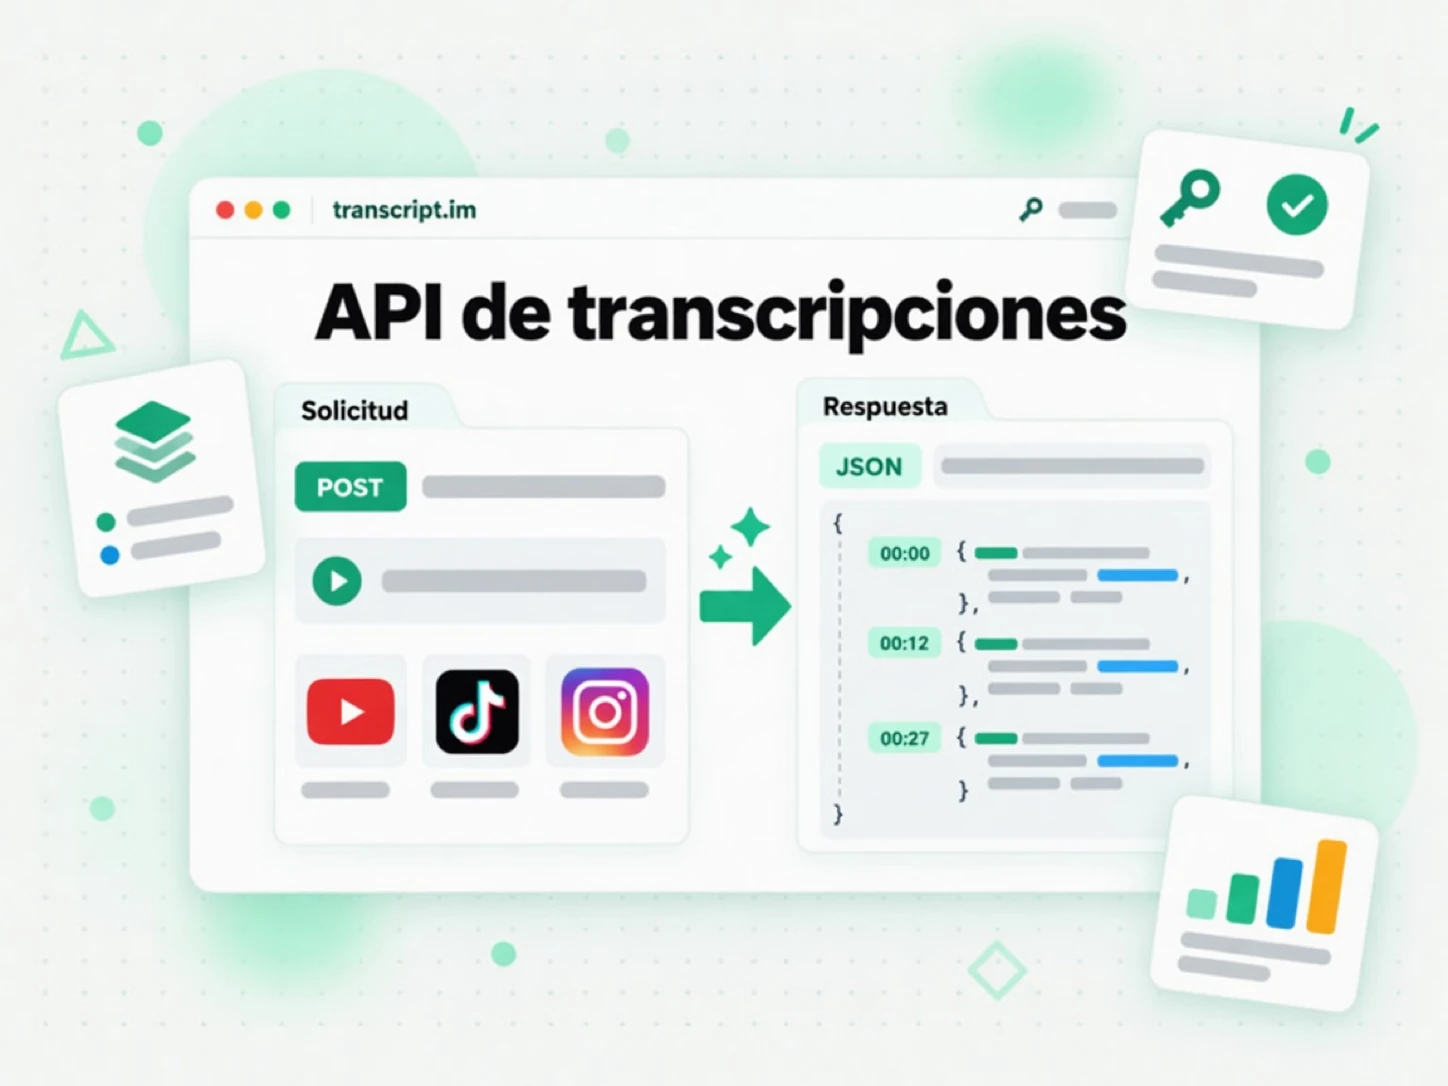
transcript.im expone como API versionada la misma canalización de extracción que impulsa el producto. Envía una URL de video o audio y recibe texto con marcas de tiempo, en JSON o texto plano, con la plataforma detectada por ti. Los subtítulos existentes se usan primero; cuando un video no tiene ninguno, la IA transcribe el audio y el resultado se entrega de forma asíncrona.
- Un solo
urlacepta un enlace completo o corto y detecta YouTube, TikTok, Instagram, LinkedIn y Twitter/X; para YouTube también se reconoce un id de video sin más, yplatformjunto conexternalIdcubren una fuente que ya conoces. - Primero se usan los subtítulos; cuando un video no tiene ninguno, la IA transcribe el audio, y un archivo local que subes siempre pasa por reconocimiento de voz.
format=jsondevuelve segmentos con marcas de tiempo, mientras queformat=textdevuelve texto plano listo para pegar.- La extracción por lotes cubre listas de URL, listas de reproducción y canales.
- La exportación por lotes admite txt, csv, json, srt, vtt y zip; una transcripción guardada se descarga como txt, srt, vtt, json o md.
- Las transcripciones guardadas viven en la biblioteca de la cuenta, y el descubrimiento de YouTube cubre búsqueda, videos, canales, subidas, listas de reproducción y subtítulos.
- El contrato completo se publica como documento OpenAPI.
Qué hace la API de transcript.im
La API de transcript.im convierte un enlace público de video o audio en una transcripción con marcas de tiempo que tu producto puede leer, almacenar, buscar o pasar a un modelo. Tú envías una URL; la API resuelve la plataforma, busca la pista de subtítulos que ya tiene el creador y devuelve el texto escrito con una marca de tiempo en cada línea. Cuando un video no tiene ningún subtítulo, la API no se detiene en un error: recurre a la transcripción con IA del audio hablado para que la misma solicitud siga produciendo texto.
- Una solicitud, texto real: resuelve un enlace y devuelve segmentos de transcripción con marcas de tiempo o texto plano.
- Primero los subtítulos, después la IA: usa la pista del creador cuando existe y transcribe el audio cuando no.
- Asíncrono por defecto para ASR: un job id te permite consultar una transcripción larga sin bloquear.
- Consciente del idioma: solicita una prioridad de idioma y lee de vuelta el idioma que resolvió la API.
- Independiente de la plataforma: quien llama no necesita saber dónde está alojado el video.
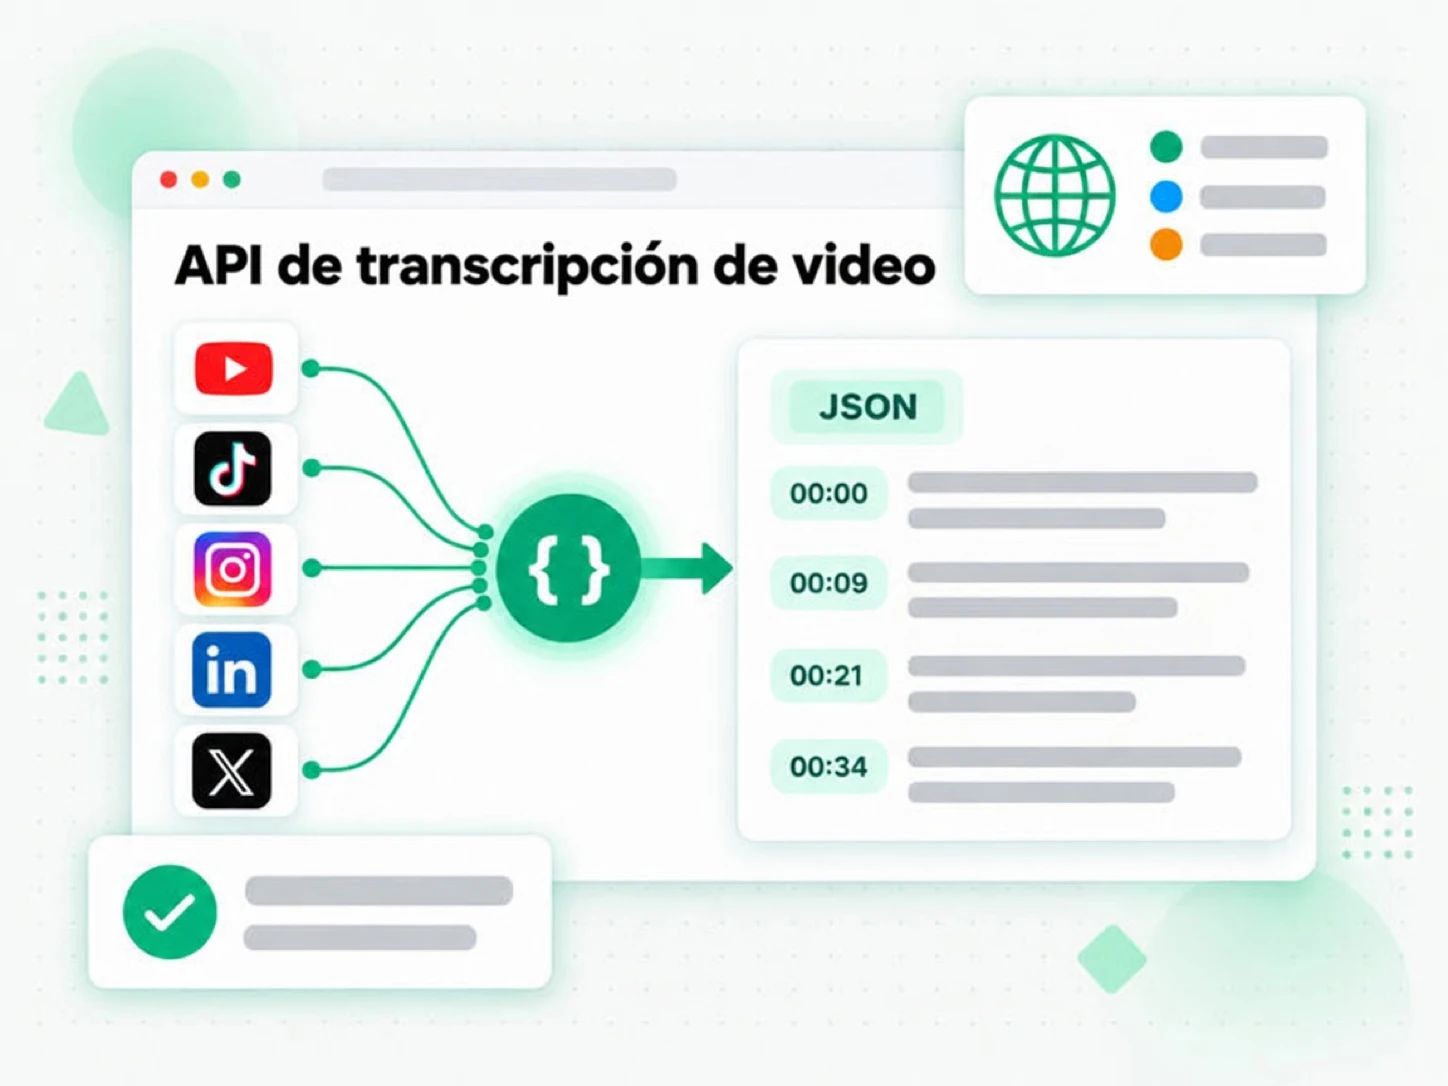
Una API de transcripciones para cinco plataformas
YouTube
Transcripciones de cualquier video público de YouTube, Short o grabación en directo, usando primero los subtítulos del creador y la transcripción con IA cuando faltan. YouTube es además la plataforma con una superficie de descubrimiento completa —búsqueda, videos, canales, subidas, listas de reproducción y subtítulos— disponible junto a la propia transcripción. El catálogo de un canal o una lista de reproducción se convierte en un lote de transcripciones con marcas de tiempo, mientras que un solo enlace vuelve como texto legible que puedes buscar.
TikTok
Transcripciones de videos públicos de TikTok, con los subtítulos usados primero y el reconocimiento de voz como alternativa. Pega un enlace de video y lee el contenido hablado como texto limpio con marcas de tiempo que puedes reutilizar, traducir o citar. La misma llamada cubre un clip corto y una subida más larga, así que una tendencia, un tutorial y un video de alguien hablando a cámara vuelven como texto.
Transcripciones de Reels y publicaciones de video públicos de Instagram. Instagram no tiene una pista de subtítulos que leer, así que la extracción es reconocimiento de voz asíncrono: envía el enlace, consulta el trabajo y recoge el texto cuando esté listo. Eso hace que un Reel se pueda citar y buscar aunque la plataforma nunca publicara sus palabras como texto.
Transcripciones de publicaciones de video públicas de LinkedIn, con los subtítulos usados primero y el reconocimiento de voz como alternativa. El resultado llega con marcas de tiempo, así que una charla, un clip de producto o una reunión grabada se convierte en texto que puedes buscar, citar y reutilizar. Extrae el argumento de la grabación de un webinar o convierte la novedad de un fundador en un borrador que puedes editar.
Twitter/X
Transcripciones de publicaciones de video públicas de X. X no tiene una pista de subtítulos que leer, así que la extracción pasa por reconocimiento de voz asíncrono: envía el enlace, consulta el trabajo y recoge texto con marcas de tiempo que puedes buscar. Cita un video con precisión o archiva su contenido hablado antes de que la publicación se edite o se elimine.
Cómo fluye una solicitud de transcripción
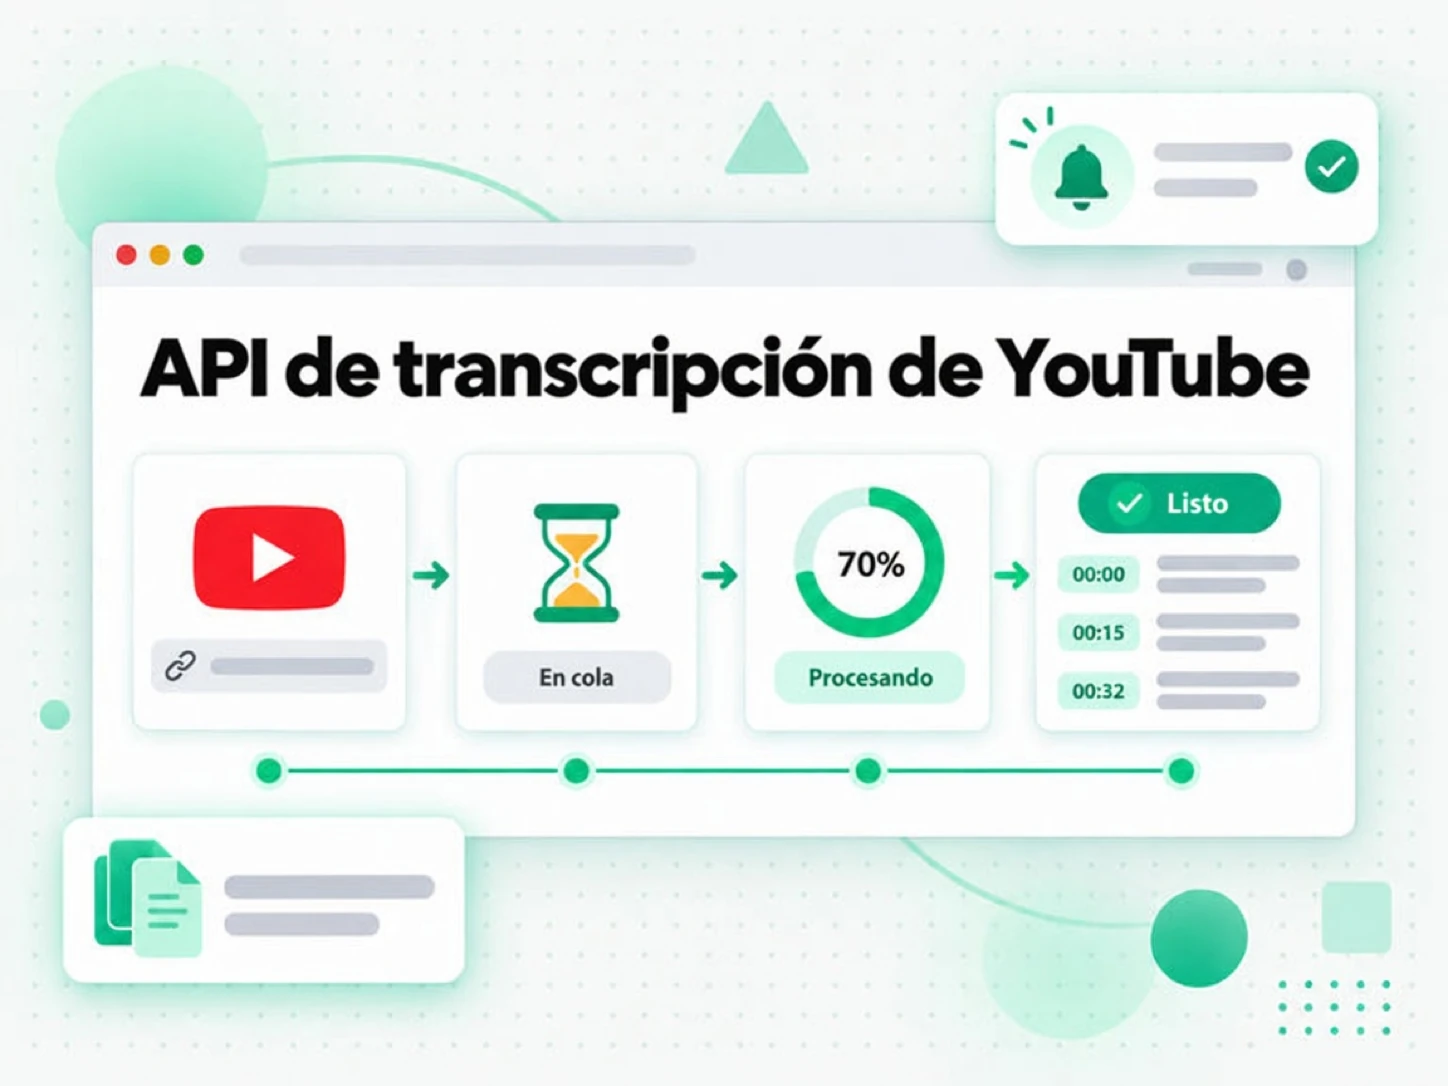
Una sola llamada lleva un enlace o un archivo subido desde la entrada hasta la transcripción, y la API te dice qué camino tomó.
- Envía la fuente: publica un
url, pasaplatformyexternalIdcuando ya los conoces, o sube un archivo comomultipart/form-dataal mismo endpoint. - Consigue una coincidencia de subtítulos: cuando el video trae subtítulos en un idioma de tu lista, la transcripción vuelve en la respuesta.
- Resuelve un idioma sin coincidencia: cuando existen subtítulos pero ninguno coincide con tu lista, la solicitud continúa a la transcripción con IA y devuelve
202con un job id; un404conavailableLanguagessolo se devuelve cuando no se permite el reconocimiento de voz para quien llama. - Fuerza el ASR o recúrrele: una entrada
asrexplícita, un video sin ninguna pista de subtítulos o un archivo subido inicia un trabajo de ASR y devuelve un job id. - Consulta o recibe en streaming: lee el trabajo con
GET /v1/transcript/job/{id}hasta que tenga éxito o falle, o suscríbete a su flujo/eventspara recibir el progreso del servidor. Una consulta de trabajo devuelve200incluso si el trabajo falló, así que ramifica según el campostatus. - Lee el resultado: una transcripción terminada incluye su idioma resuelto, duración, segmentos con marcas de tiempo y, cuando se solicita, metadatos como título, autor y fecha de publicación.
- Repite sin riesgo: una transcripción que ya se extrajo se sirve desde la caché en lugar de iniciar un trabajo nuevo, así que la misma fuente se puede volver a solicitar.
- Inspecciona antes:
GET /v1/transcript/inforesuelve una fuente y enumera los idiomas que puede servir antes de que te comprometas a una extracción.
202 con un job id, y un recurso realmente ausente o una alternativa no permitida devuelve 404. Cada camino devuelve la misma forma de transcripción una vez que el texto está listo.Extracción por lotes y exportaciones
Las cargas de trabajo reales rara vez se detienen en un solo video, así que la API acepta un lote como lista de URL, lista de reproducción o canal. Cada lote lleva sus propios totales —cuántos elementos están pendientes, cuántos tuvieron éxito y cuántos fallaron— y devuelve los elementos página a página, para que un canal largo no llegue como una única carga enorme.
- Tres formas de lote:
POST /v1/batchacepta una lista de URL, una lista de reproducción o un canal, según el cuerpo que envíes. - Estado independiente: un enlace fallido se marca por sí solo y nunca descarta el resto del lote; los elementos fallidos se pueden reintentar con
/retry. - Elementos paginados: lee el lote con
GET /v1/batch/{batchId}y sigue el token de página devuelto para los elementos restantes. - Progreso en vivo: cada consulta devuelve recuentos actualizados, así que quien llama puede mostrar cuánto de una ejecución larga ha terminado.
- Exporta en tu formato: descarga un lote terminado desde
/exportcomotxt,csv,json,srt,vttozip.
srt y vtt entran directamente en un editor o un reproductor. Para un archivo, csv, json y zip mantienen toda una biblioteca de grabaciones como un solo corpus. Los formatos coinciden con las respuestas de una sola transcripción, así que un consumidor que maneja un resultado ya sabe leer un lote.Transcripciones guardadas en la biblioteca de la cuenta
La extracción y el almacenamiento son cosas distintas: una transcripción pasa a formar parte de la biblioteca de la cuenta cuando se guarda, y la biblioteca es donde la lees, buscas, descargas y eliminas después sin volver a ejecutar la extracción.
- Enumera el contenido guardado:
GET /v1/library/transcriptsrecorre por páginas las transcripciones de la cuenta, los registros de lotes y las filas de historial fallido, con búsqueda, filtros de plataforma e idioma y ordenación. - Lee un elemento:
GET /v1/library/transcripts/{platform}/{externalId}devuelve una transcripción guardada por plataforma e id externo, o para el idioma que indiques. - Descarga: la ruta
/downloadexporta una transcripción guardada comotxt,srt,vtt,jsonomd. - Contenido relacionado: la ruta
/relatedenumera otros elementos guardados del mismo canal. - Elimina:
DELETEquita un elemento de la biblioteca sin tocar la copia de nadie más. - Lecturas limitadas a la cuenta: una solicitud a la biblioteca devuelve solo lo que guardó la cuenta y nunca inicia una extracción nueva, así que volver a visitar una transcripción guardada es una lectura, no otro trabajo.
Descubrimiento de YouTube más allá de las transcripciones
YouTube es la plataforma donde la API también responde a las preguntas alrededor de una transcripción, usando los mismos nombres de recursos que la API de datos de YouTube.
- Búsqueda:
GET /v1/youtube/searchencuentra videos, canales o listas de reproducción por consulta y devuelve resultados paginados por cursor. - Videos:
GET /v1/youtube/videosdevuelve detalles de un video, incluido si hay subtítulos disponibles. - Canales:
GET /v1/youtube/channelsresuelve un canal por id o@handle. - Subidas de un canal:
GET /v1/youtube/channels/{channelId}/videosrecorre las subidas de un canal. - Elementos de una lista:
GET /v1/youtube/playlists/{playlistId}/itemsrecorre una lista de reproducción. - Subtítulos:
GET /v1/youtube/captionsdevuelve los metadatos de la pista de subtítulos y el texto de los subtítulos de un video. Nunca inicia un trabajo de reconocimiento de voz: cuando informarequiresAsync, llama aPOST /v1/transcriptpara ejecutar la transcripción.
Pensada para producción
La superficie es pequeña a propósito, y las partes que importan a un servicio están documentadas en lugar de adivinarse.
- Una credencial: autentícate con una clave de API enviada como token Bearer, o con
X-API-Keydesde un script o un servidor. - Claves con alcance: concede solo los alcances que necesita quien llama, con
transcriptsybatchescubriendo la extracción y el trabajo por lotes. - Errores estructurados: los fallos de extracción y validación devuelven un objeto de error con un
codeestable y unmessagelegible; las respuestas de autenticación (401) y de límite de tasa (429) usan un cuerpo de error plano más simple. - Límites accionables: una solicitud limitada por tasa devuelve
429conRetry-After, y las respuestas correctas llevan cabecerasX-RateLimit-*para que un cliente pueda retroceder correctamente. - Un contrato publicado: el documento OpenAPI completo respalda la API, así que puedes generar un cliente, simular un servidor o validar respuestas reales contra el esquema.
- Un hermano para agentes: la misma cuenta y las mismas herramientas son accesibles desde el servidor MCP de transcript.im si quien llama es un cliente de IA en lugar de un servicio.
Relacionados
Preguntas frecuentes sobre la API de transcripciones
¿Qué es la API de transcript.im?
La API de transcript.im es una superficie REST que convierte un enlace público de video o audio en una transcripción con marcas de tiempo, usando primero los subtítulos existentes y la transcripción con IA cuando un video no tiene ninguno.
¿Qué plataformas admite la API de transcript.im?
Extrae transcripciones de YouTube, TikTok, Instagram, LinkedIn y Twitter/X detectando la plataforma del enlace que envías. YouTube, TikTok y LinkedIn usan primero los subtítulos con el reconocimiento de voz como alternativa; Instagram y X no tienen pista de subtítulos y pasan directamente al reconocimiento de voz.
¿Qué ocurre cuando un video no tiene subtítulos?
Cuando un video no tiene ninguna pista de subtítulos, la API inicia un trabajo de ASR y devuelve un job id; consultas ese trabajo hasta que la transcripción esté lista, así que la solicitud nunca se bloquea por el reconocimiento de voz.
¿Puedo transcribir un archivo local de audio o video?
Sí. POST /v1/transcript acepta un cuerpo multipart/form-data con una parte file en lugar de una URL. Un archivo subido pasa directamente al reconocimiento de voz, así que devuelve un trabajo 202 —o un resultado 200 si termina dentro del presupuesto de espera.
¿La API de transcript.im puede devolver marcas de tiempo con el texto?
Sí. Las respuestas JSON llevan segmentos con marcas de tiempo y las respuestas de texto pueden conservar un prefijo de marca de tiempo por línea, así que puedes volver al momento en que se dijo una frase.
¿Cómo solicito una transcripción en un idioma concreto?
Envía una lista de prioridad de idiomas separada por comas, incluidas entradas asr y asr-<code>. Una coincidencia de subtítulos se devuelve directamente; cuando existen subtítulos pero ninguno coincide con la lista, la solicitud continúa a la transcripción con IA y devuelve un trabajo 202, y un 404 con los idiomas disponibles se devuelve solo cuando no se permite el reconocimiento de voz.
¿Cómo sé cuándo está lista una transcripción asíncrona?
Consulta GET /v1/transcript/job/{id} con la misma credencial hasta que informe éxito o fallo, o suscríbete a GET /v1/transcript/job/{id}/events para recibir actualizaciones del servidor. Una consulta de trabajo devuelve 200 incluso cuando el trabajo falló, así que lee los campos status y error en lugar del código HTTP.
¿La API de transcript.im admite extracción por lotes?
Sí. Un lote acepta una lista de URL, una lista de reproducción o un canal, sigue el estado de cada elemento y devuelve los elementos página a página.
¿Qué formatos de exportación puedo descargar?
Un lote terminado se exporta como txt, csv, json, srt, vtt o zip; una sola transcripción guardada se descarga como txt, srt, vtt, json o md.
¿Dónde viven las transcripciones guardadas?
La biblioteca de la cuenta es donde viven las transcripciones guardadas y los registros de lotes, bajo /v1/library. Expone rutas de listar, leer, descargar, relacionado y eliminar, y sus lecturas están limitadas a la cuenta y nunca inician una extracción nueva.
¿Qué devuelve el endpoint de subtítulos de YouTube?
GET /v1/youtube/captions devuelve los metadatos de la pista de subtítulos de un video junto con el texto de los subtítulos. Nunca inicia un trabajo de reconocimiento de voz; cuando informa requiresAsync, llama a POST /v1/transcript para ejecutar la transcripción.
¿Cómo informa la API de transcript.im los errores y los límites de tasa?
Los errores de extracción y validación usan un objeto con code y message; la autenticación devuelve un 401 plano, y el límite de tasa devuelve un 429 plano con Retry-After más cabeceras X-RateLimit-* para que un cliente pueda retroceder correctamente.
Añade transcripciones a tu producto
Crea una clave de API, envía un enlace de video o un archivo local, y lee la transcripción como JSON o texto plano.