
REST API
비디오와 오디오를 위한 트랜스크립트 API
transcript.im은 제품을 구동하는 것과 같은 추출 파이프라인을 버전이 지정된 트랜스크립트 API로 제공합니다. 비디오나 오디오 URL을 보내면 JSON 또는 일반 텍스트로 타임스탬프가 있는 텍스트를 돌려받으며, 플랫폼은 자동으로 감지됩니다. 기존 자막이 있으면 먼저 사용하고, 비디오에 자막이 없으면 AI가 오디오를 전사하며 결과는 비동기로 전달됩니다.
- 하나의
url이 전체 링크나 짧은 링크를 받아 YouTube, TikTok, Instagram, LinkedIn, Twitter/X를 감지합니다. YouTube는 비디오 id만 있어도 인식하며, 이미 아는 소스라면platform과externalId로 지정할 수 있습니다. - 자막을 먼저 사용하고, 비디오에 자막이 없으면 AI가 말소리를 전사합니다. 로컬 파일 업로드는 항상 음성 인식으로 처리됩니다.
format=json은 타임스탬프가 있는 세그먼트를,format=text는 붙여 넣기 좋은 일반 텍스트를 반환합니다.- 배치 추출은 URL 목록, 재생목록, 채널을 지원합니다.
- 배치 내보내기는 txt, csv, json, srt, vtt, zip을 지원하고, 저장된 트랜스크립트는 txt, srt, vtt, json, md로 다운로드됩니다.
- 저장된 트랜스크립트는 계정 라이브러리에 보관되며, YouTube 탐색은 검색, 동영상, 채널, 업로드, 재생목록, 자막을 지원합니다.
- 전체 계약은 OpenAPI 문서로 공개됩니다.
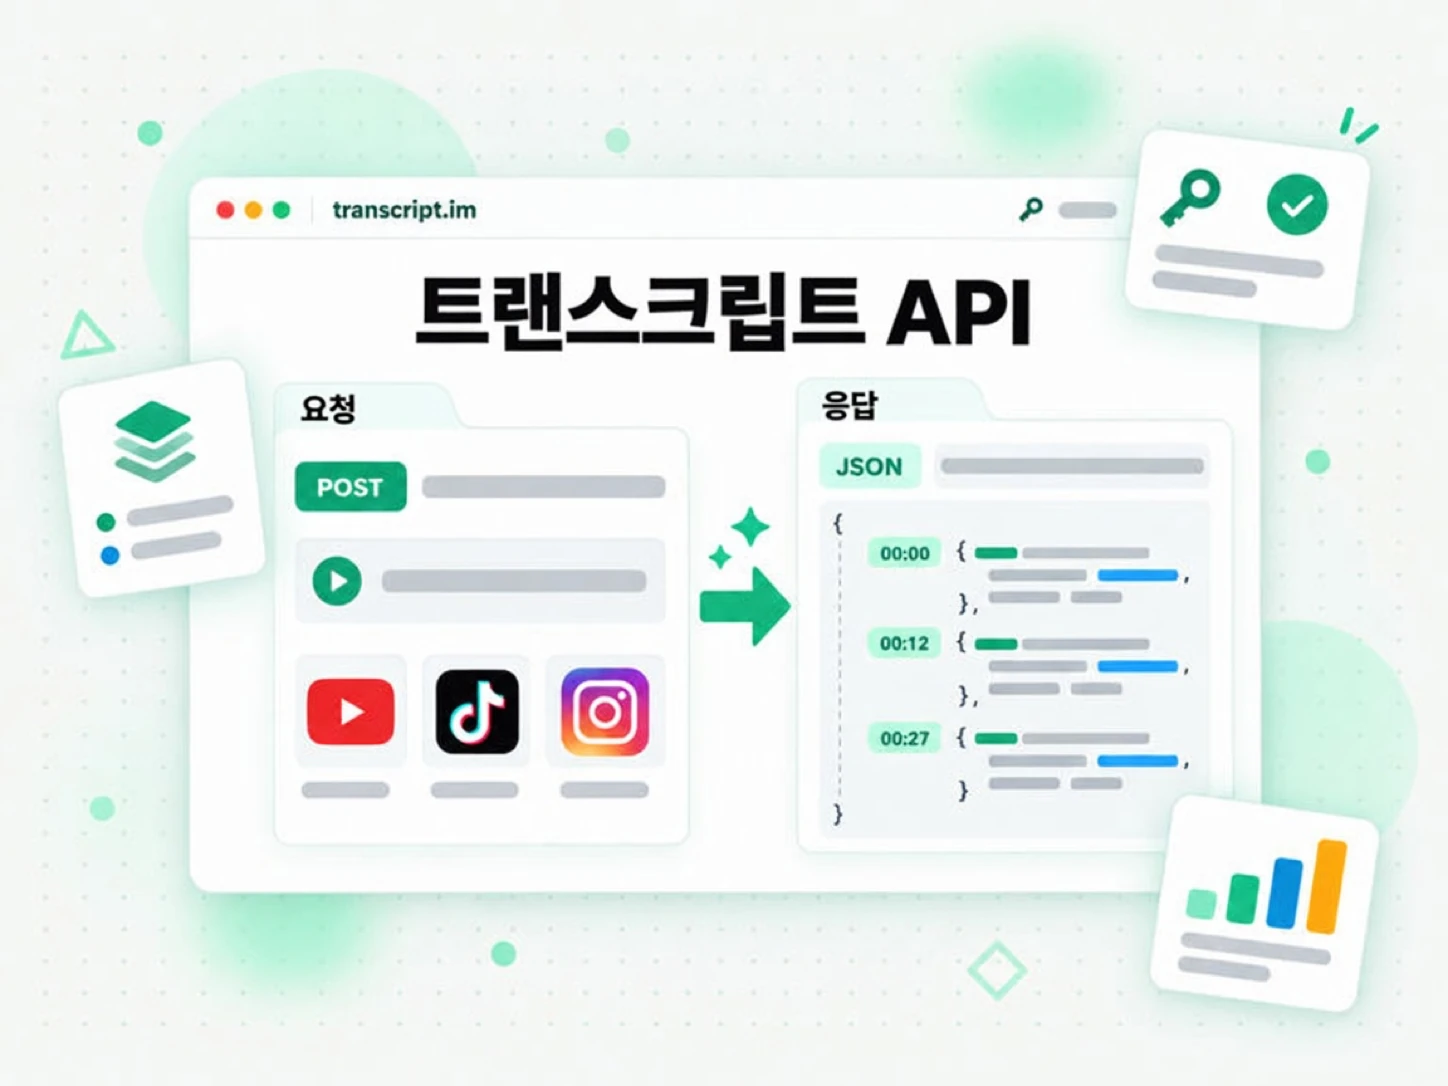
transcript.im API가 하는 일
transcript.im API는 공개된 비디오나 오디오 링크를 제품이 읽고, 저장하고, 검색하거나 모델에 넘길 수 있는 타임스탬프 트랜스크립트로 바꿉니다. URL을 보내면 API가 플랫폼을 판별하고, 크리에이터가 이미 가진 자막 트랙을 찾아 모든 줄에 타임스탬프가 붙은 텍스트를 돌려줍니다. 비디오에 자막이 전혀 없어도 API는 오류로 멈추지 않고 말소리에 대한 AI 전사로 넘어가, 같은 요청이 계속 텍스트를 만들어 냅니다.
- 한 번의 요청, 실제 텍스트 — 링크를 판별해 타임스탬프 트랜스크립트 세그먼트나 일반 텍스트를 반환합니다.
- 자막 먼저, AI 다음 — 크리에이터의 트랙이 있으면 쓰고, 없으면 오디오를 전사합니다.
- ASR은 기본이 비동기 — job id로 긴 전사를 막히지 않고 조회할 수 있습니다.
- 언어 인식 — 언어 우선순위를 요청하고 API가 판별한 언어를 다시 읽습니다.
- 플랫폼 독립적 — 호출자는 비디오가 어디에 호스팅되는지 몰라도 됩니다.
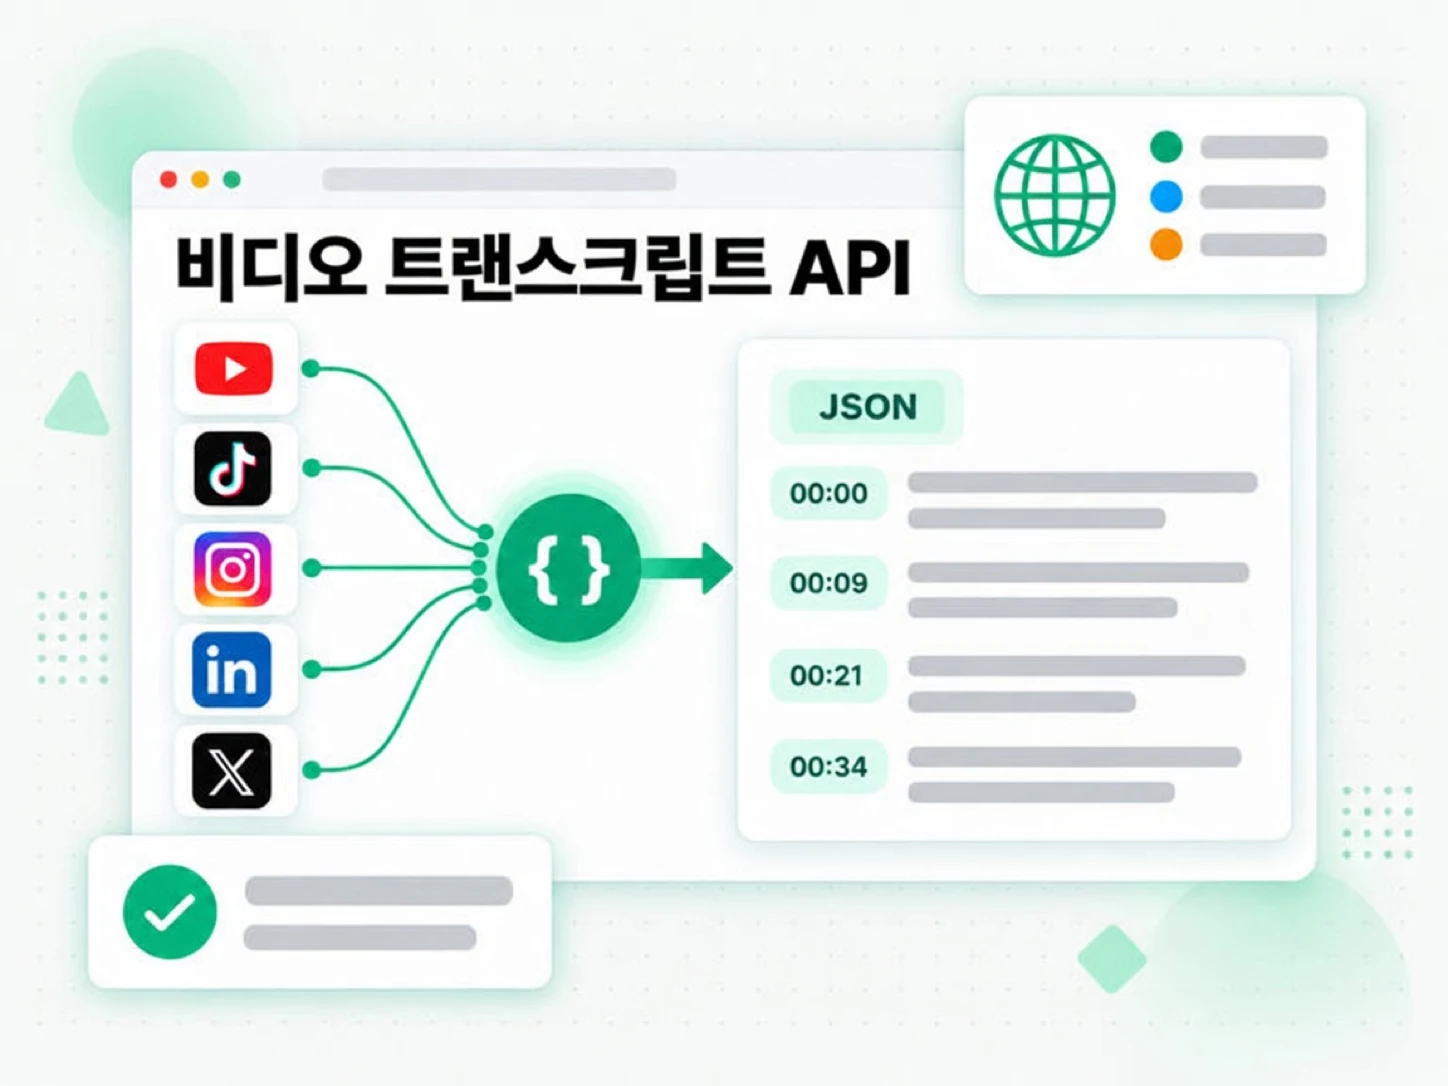
다섯 플랫폼을 위한 하나의 트랜스크립트 API
YouTube
공개된 YouTube 동영상, Short, 라이브 녹화를 위한 트랜스크립트로, 크리에이터의 자막을 먼저 쓰고 자막이 없으면 AI 전사를 씁니다. YouTube는 검색, 동영상, 채널, 업로드, 재생목록, 자막이라는 완전한 탐색 표면을 갖춘 유일한 플랫폼으로, 트랜스크립트 자체와 함께 사용할 수 있습니다. 채널의 밀린 영상이나 재생목록은 타임스탬프 트랜스크립트의 배치가 되고, 단일 링크는 검색할 수 있는 읽기 쉬운 텍스트로 돌아옵니다.
TikTok
공개된 TikTok 동영상을 위한 트랜스크립트로, 자막을 먼저 쓰고 음성 인식을 대안으로 씁니다. 비디오 링크를 붙여 넣으면 재활용하거나 번역하거나 인용할 수 있는 깔끔한 타임스탬프 텍스트로 말한 내용을 읽을 수 있습니다. 같은 호출이 짧은 클립과 더 긴 업로드를 모두 처리하므로, 트렌드, 튜토리얼, 카메라 앞에서 말하는 영상이 모두 텍스트로 돌아옵니다.
공개된 Instagram Reels와 동영상 게시물을 위한 트랜스크립트입니다. Instagram에는 읽을 자막 트랙이 없어 추출은 비동기 음성 인식으로 처리됩니다. 링크를 보내고 작업을 조회한 뒤 준비되면 텍스트를 받습니다. 그래서 플랫폼이 말을 텍스트로 공개한 적이 없어도 Reel을 인용하고 검색할 수 있습니다.
공개된 LinkedIn 동영상 게시물을 위한 트랜스크립트로, 자막을 먼저 쓰고 음성 인식을 대안으로 씁니다. 결과는 타임스탬프와 함께 돌아오므로 발표, 제품 클립, 녹화한 미팅이 인용하고 재사용할 수 있는 검색 가능한 텍스트가 됩니다. 웨비나 녹음에서 논지를 뽑아내거나 창업자의 업데이트를 편집할 초안으로 바꿀 수 있습니다.
Twitter/X
공개된 X 동영상 게시물을 위한 트랜스크립트입니다. X에는 읽을 자막 트랙이 없어 추출은 비동기 음성 인식으로 처리됩니다. 링크를 보내고 작업을 조회한 뒤 검색할 수 있는 타임스탬프 텍스트를 받습니다. 게시물이 수정되거나 삭제되기 전에 영상을 정확히 인용하거나 말한 내용을 보관할 수 있습니다.
트랜스크립트 요청이 흐르는 방식
한 번의 호출이 링크나 업로드한 파일을 입력에서 트랜스크립트까지 데려가며, API는 어떤 경로를 택했는지 알려 줍니다.
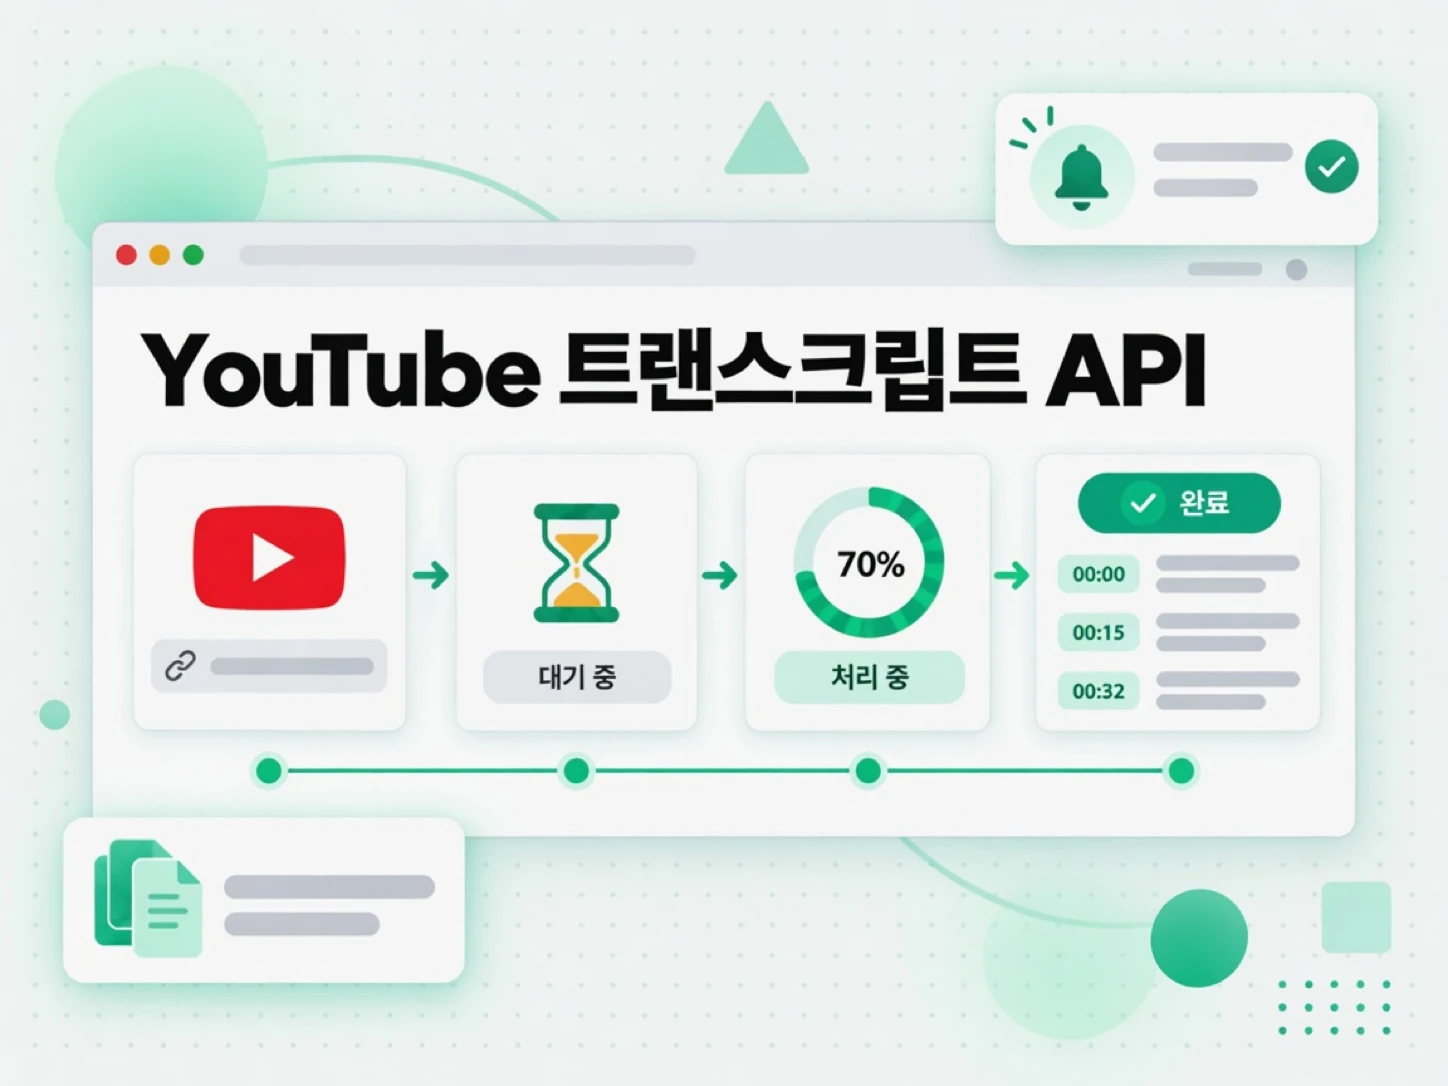
- 소스 보내기 —
url을 보내고, 이미 알고 있다면platform과externalId를 넘기거나, 같은 엔드포인트에 파일을multipart/form-data로 업로드합니다. - 자막 일치 얻기 — 비디오가 목록에 있는 언어의 자막을 가지고 있으면 트랜스크립트가 응답으로 돌아옵니다.
- 언어 불일치 처리 — 자막은 있지만 목록에 맞는 것이 없으면 요청이 AI 전사로 이어지고 job id와 함께
202를 반환합니다.availableLanguages와 함께 오는404는 호출자에게 음성 인식이 허용되지 않을 때만 반환됩니다. - ASR 강제 또는 대안 — 명시적인
asr항목, 자막 트랙이 전혀 없는 비디오, 업로드한 파일은 ASR 작업을 시작하고 job id를 반환합니다. - 조회 또는 스트리밍 —
GET /v1/transcript/job/{id}로 작업이 성공하거나 실패할 때까지 읽거나,/events스트림을 구독해 서버 전송 진행 상황을 받습니다. 작업 조회는 실패한 작업에도200을 반환하므로status필드로 분기합니다. - 결과 읽기 — 완료된 트랜스크립트에는 판별된 언어, 길이, 타임스탬프 세그먼트와 요청 시 제목, 작성자, 게시일 같은 메타데이터가 담깁니다.
- 안전하게 반복 — 이미 추출한 트랜스크립트는 새 작업을 시작하지 않고 캐시에서 제공되므로 같은 소스를 다시 요청할 수 있습니다.
- 먼저 조사 —
GET /v1/transcript/info가 소스를 판별하고 추출을 결정하기 전에 제공할 수 있는 언어를 나열합니다.
202를 반환하며, 정말로 없는 자산이나 허용되지 않은 대안은 404를 반환합니다. 텍스트가 준비되면 모든 경로가 같은 트랜스크립트 형태를 반환합니다.배치 추출과 내보내기
실제 작업은 비디오 하나에서 멈추는 일이 드물어, API는 배치를 URL 목록, 재생목록, 채널로 받습니다. 각 배치는 자체 합계 — 대기 중인 항목 수, 성공한 수, 실패한 수 — 를 추적하고 항목을 페이지 단위로 반환하므로, 긴 채널이 하나의 거대한 페이로드로 오지 않습니다.
- 세 가지 배치 형태 —
POST /v1/batch는 보내는 본문에 따라 URL 목록, 재생목록, 채널을 받습니다. - 독립적인 상태 — 실패한 링크는 따로 표시되고 나머지 배치를 절대 버리지 않습니다. 실패한 항목은
/retry로 재시도할 수 있습니다. - 페이지 단위 항목 —
GET /v1/batch/{batchId}로 배치를 읽고, 반환된 페이지 토큰을 따라 나머지 항목을 가져옵니다. - 실시간 진행 — 조회할 때마다 갱신된 카운트가 반환되어, 호출자가 긴 실행이 얼마나 끝났는지 보여 줄 수 있습니다.
- 원하는 형식으로 내보내기 — 완료된 배치를
/export에서txt,csv,json,srt,vtt,zip으로 다운로드합니다.
srt와 vtt 내보내기를 편집기나 플레이어에 바로 넣을 수 있습니다. 아카이브라면 csv, json, zip이 녹음 라이브러리 전체를 하나의 코퍼스로 검색 가능하게 유지합니다. 형식이 단일 트랜스크립트 응답과 맞춰져 있어, 결과 하나를 처리하는 소비자는 이미 배치를 읽을 줄 압니다.계정 라이브러리에 저장된 트랜스크립트
추출과 저장은 별개입니다. 트랜스크립트는 저장되는 순간 계정 라이브러리의 일부가 되고, 라이브러리는 나중에 추출을 다시 실행하지 않고 읽고, 검색하고, 다운로드하고, 삭제하는 곳입니다.
- 저장된 콘텐츠 나열 —
GET /v1/library/transcripts가 계정의 트랜스크립트, 배치 기록, 실패 이력 행을 페이지 단위로 넘기며, 검색, 플랫폼·언어 필터, 정렬을 지원합니다. - 항목 하나 읽기 —
GET /v1/library/transcripts/{platform}/{externalId}가 플랫폼과 외부 id로 저장된 트랜스크립트를, 또는 지정한 언어로 반환합니다. - 다운로드 —
/download경로가 저장된 트랜스크립트를txt,srt,vtt,json,md로 내보냅니다. - 관련 콘텐츠 —
/related경로가 같은 채널의 다른 저장 항목을 나열합니다. - 삭제 —
DELETE가 다른 사람의 복사본은 건드리지 않고 라이브러리에서 항목을 제거합니다. - 계정 범위 읽기 — 라이브러리 요청은 계정이 저장한 것만 반환하고 새 추출을 절대 시작하지 않으므로, 저장된 트랜스크립트를 다시 보는 것은 읽기이지 또 다른 작업이 아닙니다.
트랜스크립트 너머의 YouTube 탐색
YouTube는 API가 트랜스크립트 주변의 질문에도 답하는 플랫폼이며, YouTube Data API와 같은 리소스 이름을 사용합니다.
- 검색 —
GET /v1/youtube/search가 쿼리로 동영상, 채널, 재생목록을 찾고 커서 페이지 결과를 반환합니다. - 동영상 —
GET /v1/youtube/videos가 자막 사용 가능 여부를 포함한 동영상 세부 정보를 반환합니다. - 채널 —
GET /v1/youtube/channels가 id나@handle로 채널을 판별합니다. - 채널 업로드 —
GET /v1/youtube/channels/{channelId}/videos가 채널의 업로드를 순회합니다. - 재생목록 항목 —
GET /v1/youtube/playlists/{playlistId}/items가 재생목록을 순회합니다. - 자막 —
GET /v1/youtube/captions가 동영상의 자막 트랙 메타데이터와 자막 텍스트를 반환합니다. 음성 인식 작업은 절대 시작하지 않습니다.requiresAsync를 보고하면POST /v1/transcript를 호출해 전사를 실행하세요.
프로덕션 사용을 위해 설계
표면은 의도적으로 작게 유지했고, 서비스에 중요한 부분은 추측이 아니라 문서로 남겼습니다.
- 하나의 자격 증명 — Bearer 토큰으로 보낸 API 키로, 또는 스크립트나 서버에서
X-API-Key로 인증합니다. - 범위가 지정된 키 — 호출자에게 필요한 범위만 부여하며,
transcripts와batches가 추출과 배치 작업을 담당합니다. - 구조화된 오류 — 추출과 검증 실패는 안정적인
code와 읽을 수 있는message를 가진 오류 객체를 반환합니다. 인증(401)과 속도 제한(429) 응답은 더 단순한 평면 오류 본문을 씁니다. - 실행 가능한 한도 — 속도 제한에 걸린 요청은
Retry-After와 함께429를 반환하고, 성공한 응답에는X-RateLimit-*헤더가 붙어 클라이언트가 올바르게 물러설 수 있습니다. - 공개된 계약 — 전체 OpenAPI 문서가 API를 뒷받침하므로 클라이언트를 생성하거나, 서버를 모의하거나, 실제 응답을 스키마에 맞춰 검증할 수 있습니다.
- 에이전트를 위한 형제 — 호출자가 서비스가 아니라 AI 클라이언트라면 같은 계정과 도구를 transcript.im MCP 서버에서 사용할 수 있습니다.
관련 도구
트랜스크립트 API 자주 묻는 질문
transcript.im API란 무엇인가요?
transcript.im API는 공개된 비디오나 오디오 링크를 타임스탬프 트랜스크립트로 바꾸는 REST 표면으로, 기존 자막을 먼저 쓰고 비디오에 자막이 없으면 AI 전사를 사용합니다.
transcript.im API는 어떤 플랫폼을 지원하나요?
보낸 링크에서 플랫폼을 감지해 YouTube, TikTok, Instagram, LinkedIn, Twitter/X의 트랜스크립트를 추출합니다. YouTube, TikTok, LinkedIn은 자막을 먼저 쓰고 음성 인식을 대안으로 사용하며, Instagram과 X는 자막 트랙이 없어 바로 음성 인식으로 갑니다.
비디오에 자막이 없으면 어떻게 되나요?
비디오에 자막 트랙이 전혀 없으면 API가 ASR 작업을 시작하고 job id를 반환합니다. 트랜스크립트가 준비될 때까지 그 작업을 조회하므로, 요청이 음성 인식 때문에 막히지 않습니다.
로컬 오디오나 비디오 파일을 전사할 수 있나요?
네. POST /v1/transcript는 URL 대신 file 파트가 있는 multipart/form-data 본문을 받습니다. 업로드한 파일은 바로 음성 인식으로 가므로 202 작업을 반환하며, 대기 예산 안에 끝나면 200 결과를 반환합니다.
transcript.im API가 텍스트와 함께 타임스탬프를 반환할 수 있나요?
네. JSON 응답에는 타임스탬프 세그먼트가 담기고, 텍스트 응답은 줄마다 타임스탬프 접두사를 유지할 수 있어 한 줄이 말해진 시점으로 돌아갈 수 있습니다.
특정 언어로 트랜스크립트를 요청하려면 어떻게 하나요?
asr와 asr-<code> 항목을 포함해 쉼표로 구분한 언어 우선순위 목록을 보냅니다. 자막 일치는 바로 반환되고, 자막은 있지만 목록에 맞는 것이 없으면 요청이 AI 전사로 이어져 202 작업을 반환합니다. 사용 가능한 언어와 함께 오는 404는 음성 인식이 허용되지 않을 때만 반환됩니다.
비동기 트랜스크립트가 언제 준비되는지 어떻게 아나요?
같은 자격 증명으로 GET /v1/transcript/job/{id}를 성공 또는 실패를 보고할 때까지 조회하거나, GET /v1/transcript/job/{id}/events를 구독해 서버 전송 업데이트를 받습니다. 작업 조회는 실패한 작업에도 200을 반환하므로 HTTP 코드 대신 status와 error 필드를 읽으세요.
transcript.im API는 배치 추출을 지원하나요?
네. 배치는 URL 목록, 재생목록, 채널을 받고 각 항목의 상태를 추적하며 항목을 페이지 단위로 반환합니다.
어떤 내보내기 형식을 다운로드할 수 있나요?
완료된 배치는 txt, csv, json, srt, vtt, zip으로 내보내고, 저장된 트랜스크립트 하나는 txt, srt, vtt, json, md로 다운로드합니다.
저장된 트랜스크립트는 어디에 있나요?
계정 라이브러리가 저장된 트랜스크립트와 배치 기록이 있는 곳이며 /v1/library 아래에 있습니다. 나열, 읽기, 다운로드, 관련, 삭제 경로를 제공하고, 읽기는 계정 범위로 제한되며 새 추출을 절대 시작하지 않습니다.
YouTube 자막 엔드포인트는 무엇을 반환하나요?
GET /v1/youtube/captions는 동영상의 자막 트랙 메타데이터와 자막 텍스트를 함께 반환합니다. 음성 인식 작업은 절대 시작하지 않으며, requiresAsync를 보고하면 POST /v1/transcript를 호출해 전사를 실행하세요.
transcript.im API는 오류와 속도 제한을 어떻게 알리나요?
추출과 검증 오류는 code와 message가 있는 객체를 씁니다. 인증은 평면 401을, 속도 제한은 Retry-After와 X-RateLimit-* 헤더가 있는 평면 429를 반환해 클라이언트가 올바르게 물러설 수 있습니다.