
REST API
API Transkrip untuk Video dan Audio
transcript.im mendedahkan saluran pengekstrakan yang sama yang menggerakkan produk ini sebagai API transkrip berversi. Hantar URL video atau audio dan dapatkan semula teks bertimestamp, dalam JSON atau teks biasa, dengan platform dikesan untuk anda. Sari kata sedia ada digunakan dahulu; apabila video tiada sari kata, AI mentranskripsi audio dan hasilnya dihantar secara tak segerak.
- Satu
urlmenerima pautan penuh atau pendek dan mengesan YouTube, TikTok, Instagram, LinkedIn dan Twitter/X; untuk YouTube, id video sahaja turut dikenali, danplatformsertaexternalIdmeliputi sumber yang anda sudah tahu. - Sari kata digunakan dahulu; AI mentranskripsi audio yang dituturkan apabila video tiada sari kata, dan muat naik fail setempat sentiasa pergi ke pengecaman pertuturan.
format=jsonmemulangkan segmen bertimestamp, manakalaformat=textmemulangkan teks biasa yang sedia untuk ditampal.- Pengekstrakan kelompok merangkumi senarai URL, senarai main dan saluran.
- Eksport kelompok merangkumi txt, csv, json, srt, vtt dan zip; transkrip yang disimpan dimuat turun sebagai txt, srt, vtt, json atau md.
- Transkrip yang disimpan tersimpan dalam Library akaun, dan penemuan YouTube merangkumi carian, video, saluran, muat naik, senarai main dan sari kata.
- Kontrak lengkap diterbitkan sebagai dokumen OpenAPI.
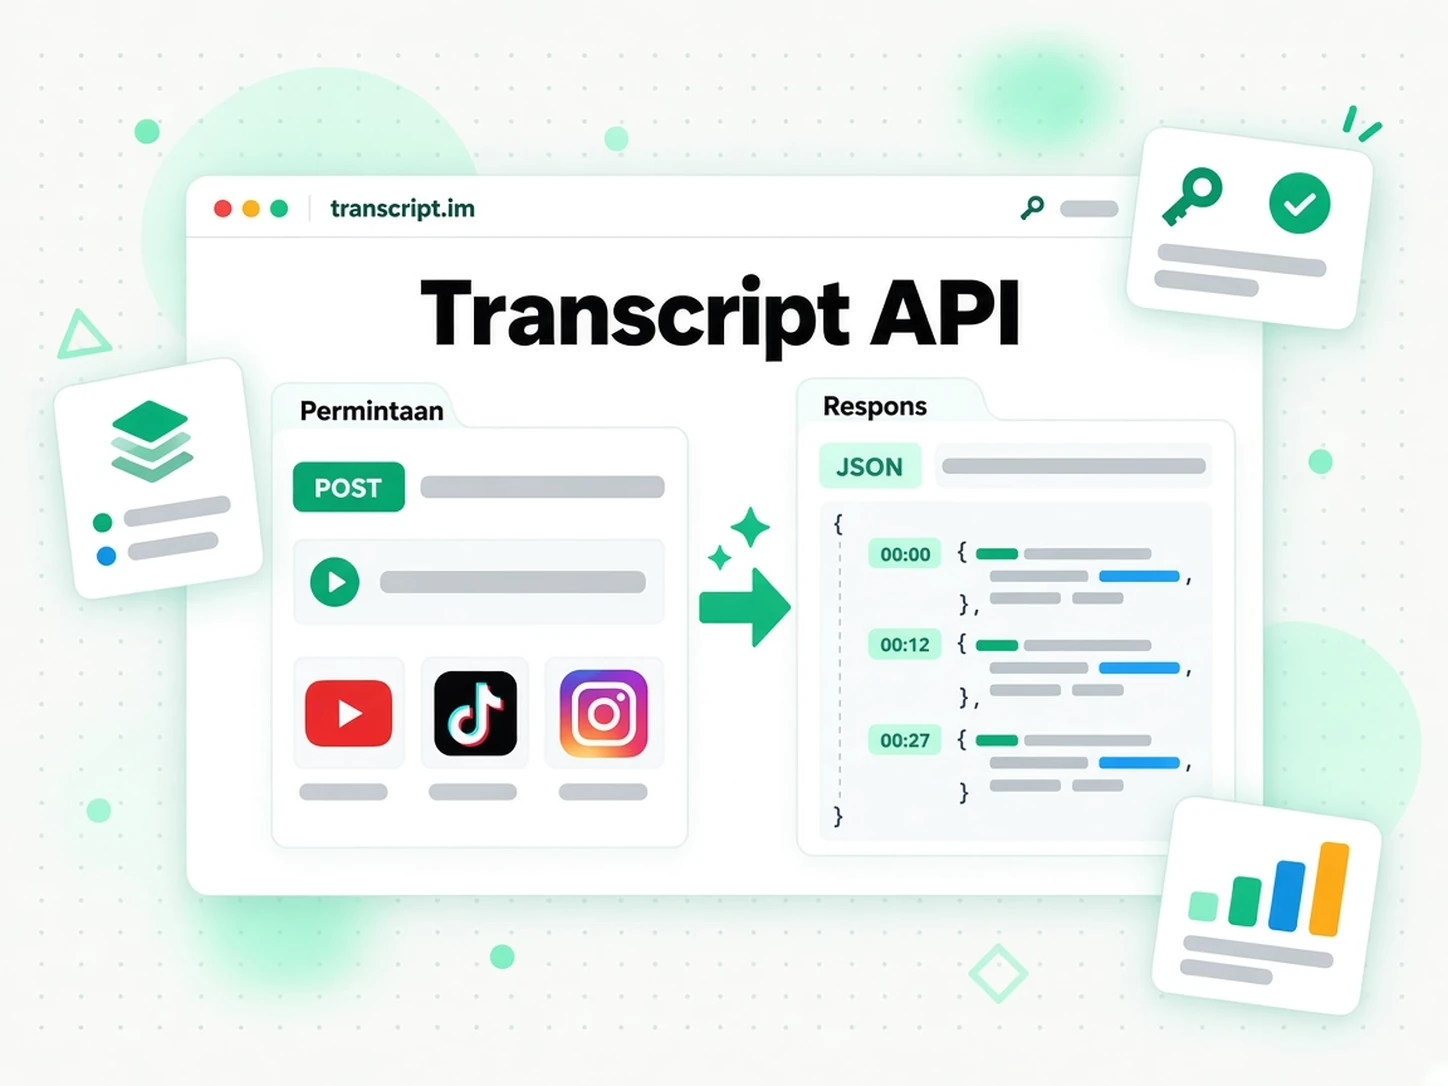
Apa yang Dilakukan oleh API transcript.im
API transcript.im menukar pautan video atau audio awam menjadi transkrip berstempel masa yang boleh dibaca, disimpan, dicari atau disuap ke dalam model oleh produk anda. Anda hantar URL; API menyelesaikan platform, mencari trek kapsyen sedia ada pencipta, dan memulangkan teks bertulis dengan stempel masa pada setiap baris. Apabila video langsung tidak mempunyai kapsyen, API tidak berhenti pada ralat — ia beralih ke transkripsi AI bagi audio yang dituturkan supaya permintaan yang sama tetap menghasilkan teks.
- Satu permintaan, teks sebenar — selesaikan pautan dan pulangkan segmen transkrip berstempel masa atau teks biasa.
- Kapsyen dahulu, AI kemudian — guna trek pencipta apabila wujud, transkripsikan audio apabila tiada.
- Async secara lalai untuk ASR — id kerja membolehkan anda meninjau transkripsi panjang tanpa menyekat.
- Sedar bahasa — minta keutamaan bahasa dan baca semula bahasa yang diselesaikan oleh API.
- Agnostik platform — pemanggil tidak perlu tahu di mana video itu dihoskan.
Satu API transkrip untuk Lima Platform
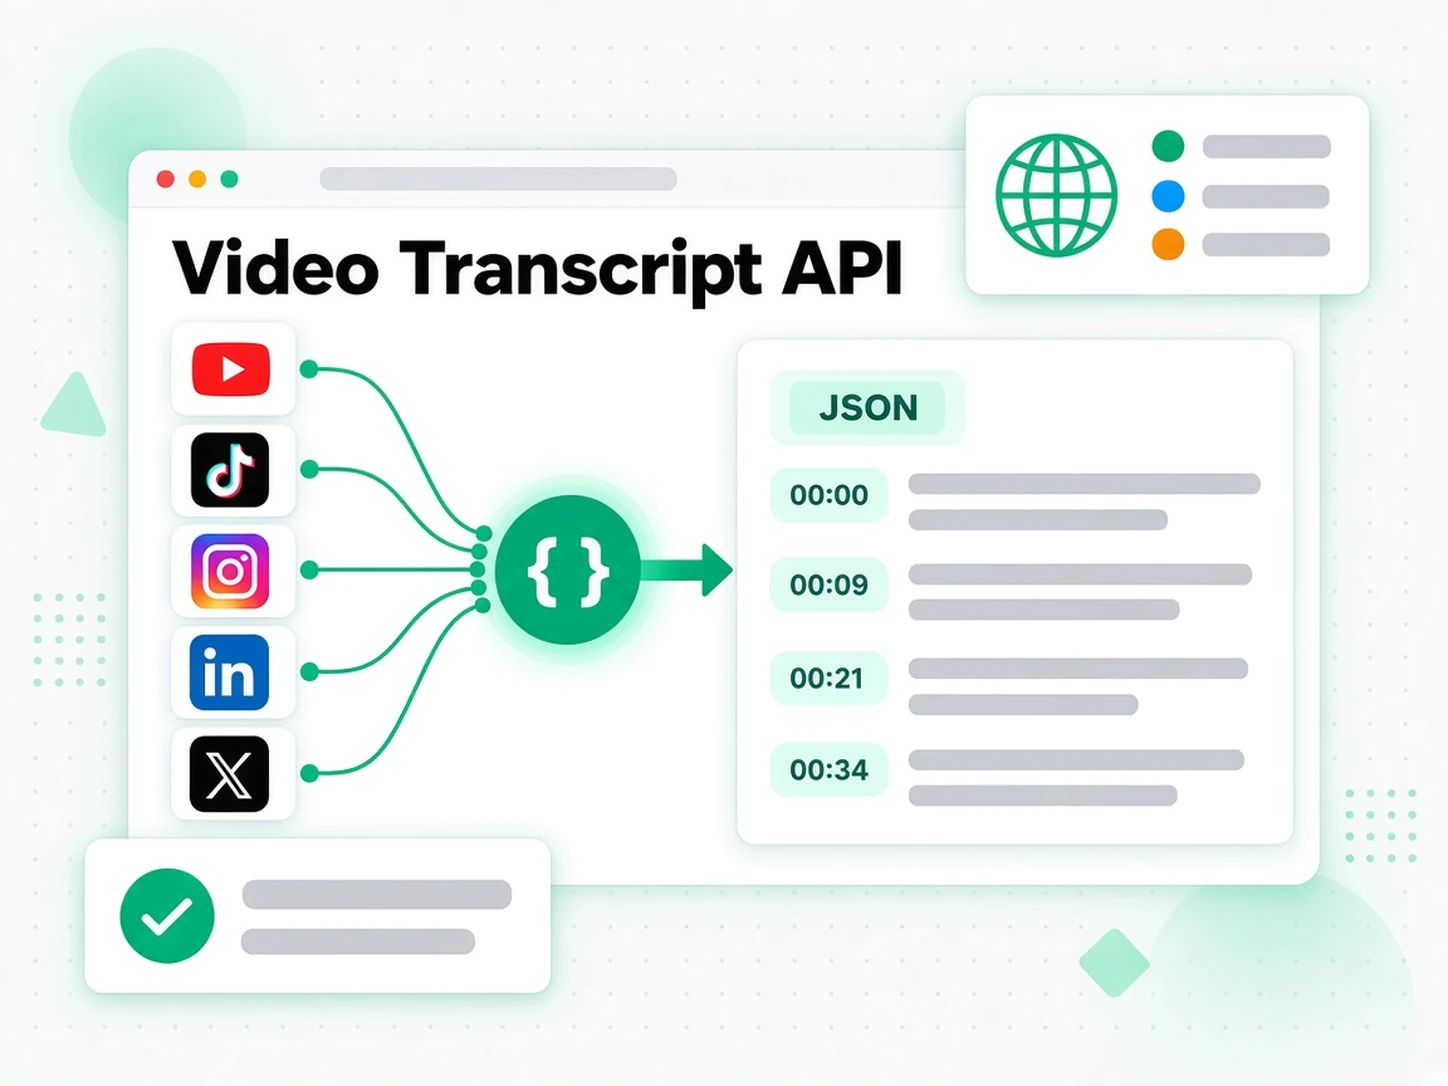
YouTube
Transkrip untuk mana-mana video YouTube awam, Short atau rakaman langsung, menggunakan kapsyen pencipta dahulu dan transkripsi AI apabila kapsyen tiada. YouTube juga merupakan platform dengan permukaan penemuan yang lengkap — carian, video, saluran, muat naik, senarai main dan kapsyen — tersedia bersama transkrip itu sendiri. Himpunan saluran atau senarai main menjadi kelompok transkrip berstempel masa, manakala satu pautan dipulangkan sebagai teks boleh dibaca yang boleh anda cari.
TikTok
Transkrip untuk video TikTok awam dengan kapsyen digunakan dahulu dan pengecaman pertuturan sebagai sandaran. Tampal pautan video dan baca kandungan yang dituturkan sebagai teks bersih berstempel masa yang boleh anda guna semula, terjemah atau petik. Panggilan yang sama merangkumi klip pendek dan muat naik yang lebih panjang, jadi trend, tutorial dan pos bercakap semua dipulangkan sebagai teks.
Transkrip untuk Instagram Reels dan pos video awam. Instagram tiada trek kapsyen untuk dibaca, jadi pengekstrakan ialah pengecaman pertuturan tak segerak: hantar pautan, tinjau kerja, dan kumpul teks apabila sedia. Ini menjadikan Reel boleh dipetik dan dicari walaupun platform itu tidak pernah menerbitkan katanya sebagai teks.
Transkrip untuk pos video LinkedIn awam, dengan kapsyen digunakan dahulu dan pengecaman pertuturan sebagai sandaran. Hasilnya dipulangkan dengan stempel masa, jadi ceramah, klip produk atau mesyuarat yang dirakam menjadi teks boleh dicari yang boleh anda rujuk dan guna semula. Tarik hujah daripada rakaman webinar, atau tukar kemas kini pengasas menjadi draf yang boleh anda sunting.
Twitter/X
Transkrip untuk pos video X awam. X tiada trek kapsyen untuk dibaca, jadi pengekstrakan berjalan melalui pengecaman pertuturan tak segerak: hantar pautan, tinjau kerja, dan kumpul teks berstempel masa yang boleh anda cari. Petik video dengan tepat, atau arkibkan kandungan yang dituturkan sebelum pos itu disunting atau dibuang.
Bagaimana Permintaan Transkrip Mengalir
Satu panggilan membawa pautan atau fail yang dimuat naik daripada input ke transkrip, dan API memberitahu anda laluan yang digunakan.
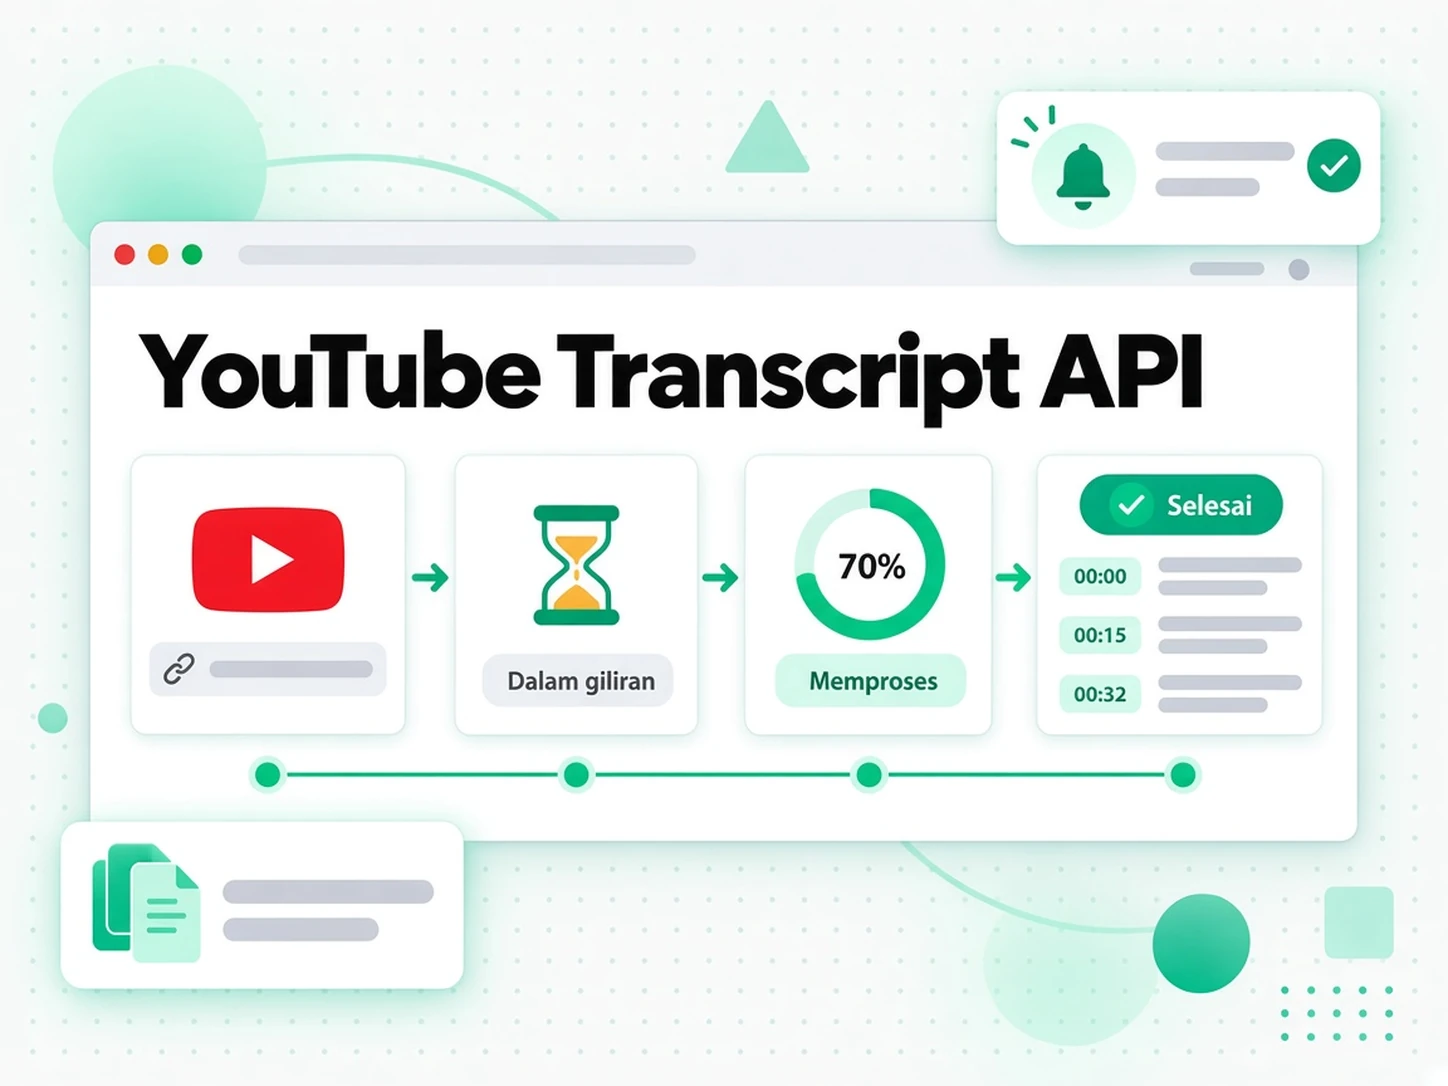
- Hantar sumber — hantar
url, berikanplatformdanexternalIdapabila anda sudah mengetahuinya, atau muat naik fail sebagaimultipart/form-datake titik akhir yang sama. - Dapatkan padanan kapsyen — apabila video membawa kapsyen dalam bahasa pada senarai anda, transkrip dipulangkan dalam respons.
- Tangani bahasa yang tidak sepadan — apabila kapsyen wujud tetapi tiada yang sepadan dengan senarai anda, permintaan diteruskan ke transkripsi AI dan memulangkan
202dengan id kerja;404denganavailableLanguagesdipulangkan hanya apabila pengecaman pertuturan tidak dibenarkan untuk pemanggil. - Paksa atau kembali ke ASR — entri
asryang eksplisit, video tanpa trek kapsyen langsung, atau fail yang dimuat naik memulakan kerja ASR dan memulangkan id kerja. - Tinjau atau strim — baca kerja dengan
GET /v1/transcript/job/{id}sehingga berjaya atau gagal, atau langgan strim/events-nya untuk kemajuan yang dihantar pelayan. Pertanyaan kerja memulangkan200walaupun untuk kerja yang gagal, jadi cabang pada medanstatus. - Baca hasil — transkrip yang siap membawa bahasa yang diselesaikan, panjang, segmen berstempel masa dan, apabila diminta, metadata seperti tajuk, pengarang dan tarikh terbit.
- Ulang dengan selamat — transkrip yang sudah diekstrak disajikan daripada cache dan bukannya memulakan kerja baharu, jadi sumber yang sama boleh diminta semula.
- Periksa dahulu —
GET /v1/transcript/infomenyelesaikan sumber dan menyenaraikan bahasa yang boleh disajikannya sebelum anda komited kepada pengekstrakan.
202 dengan id kerja, manakala aset yang benar-benar hilang atau sandaran yang tidak dibenarkan memulangkan 404. Setiap laluan memulangkan bentuk transkrip yang sama sebaik teks sedia.Pengekstrakan Kelompok dan Eksport
Beban kerja sebenar jarang berhenti pada satu video, jadi API menerima kelompok sebagai senarai URL, senarai main atau saluran. Setiap kelompok menjejak jumlahnya sendiri — berapa banyak item belum selesai, berapa berjaya dan berapa gagal — dan memulangkan item satu halaman pada satu masa, jadi saluran panjang tidak tiba sebagai satu muatan yang sangat besar.
- Tiga bentuk kelompok —
POST /v1/batchmenerima senarai URL, senarai main atau saluran, dipilih oleh badan yang anda hantar. - Status bebas — satu pautan gagal ditandakan sendiri dan tidak pernah membuang seluruh kelompok yang lain; item yang gagal boleh dicuba semula dengan
/retry. - Item berhalaman — baca kelompok dengan
GET /v1/batch/{batchId}, kemudian ikut token halaman yang dipulangkan untuk item yang selebihnya. - Kemajuan langsung — setiap tinjauan memulangkan kiraan terkini, jadi pemanggil boleh menunjukkan berapa banyak daripada jalan panjang yang sudah selesai.
- Eksport dalam format anda — muat turun kelompok yang siap daripada
/exportsebagaitxt,csv,json,srt,vttatauzip.
srt dan vtt terus masuk ke editor atau pemain. Untuk arkib, csv, json dan zip mengekalkan seluruh pustaka rakaman boleh dicari sebagai satu korpus. Format-format itu selaras dengan respons transkrip tunggal, jadi pengguna yang mengendalikan satu hasil sudah tahu cara membaca kelompok.Transkrip Tersimpan dalam Pustaka Akaun
Pengekstrakan dan penyimpanan adalah berasingan: transkrip menjadi sebahagian daripada Pustaka akaun sebaik disimpan, dan Pustaka ialah tempat anda membaca, mencari, memuat turun dan membuangnya kemudian tanpa menjalankan semula pengekstrakan.
- Senaraikan kandungan tersimpan —
GET /v1/library/transcriptsmenghalaman transkrip akaun, rekod kelompok dan baris sejarah gagal, dengan carian, penapis platform dan bahasa, serta pengisihan. - Baca satu item —
GET /v1/library/transcripts/{platform}/{externalId}memulangkan transkrip tersimpan mengikut platform dan id luaran, atau untuk bahasa yang anda namakan. - Muat turun — laluan
/downloadmengeksport transkrip tersimpan sebagaitxt,srt,vtt,jsonataumd. - Kandungan berkaitan — laluan
/relatedmenyenaraikan item tersimpan lain daripada saluran yang sama. - Buang —
DELETEmembuang item daripada Pustaka tanpa menyentuh salinan orang lain. - Bacaan berskop akaun — permintaan Pustaka hanya memulangkan apa yang disimpan oleh akaun dan tidak pernah memulakan pengekstrakan baharu, jadi melawat semula transkrip tersimpan adalah bacaan, bukan kerja lain.
Penemuan YouTube Melebihi Transkrip
YouTube ialah platform di mana API juga menjawab soalan sekitar transkrip, menggunakan nama sumber yang sama seperti YouTube Data API.
- Carian —
GET /v1/youtube/searchmencari video, saluran atau senarai main mengikut pertanyaan dan memulangkan hasil berhalaman kursor. - Video —
GET /v1/youtube/videosmemulangkan butiran untuk video, termasuk sama ada kapsyen tersedia. - Saluran —
GET /v1/youtube/channelsmenyelesaikan saluran mengikut id atau@handle. - Muat naik saluran —
GET /v1/youtube/channels/{channelId}/videosmenelusuri muat naik saluran. - Item senarai main —
GET /v1/youtube/playlists/{playlistId}/itemsmenelusuri senarai main. - Kapsyen —
GET /v1/youtube/captionsmemulangkan metadata trek kapsyen dan teks kapsyen untuk video. Ia tidak pernah memulakan kerja pengecaman pertuturan: apabila ia melaporkanrequiresAsync, panggilPOST /v1/transcriptuntuk menjalankan transkripsi.
Dibina untuk Penggunaan Produksi
Permukaannya sengaja kecil, dan bahagian yang penting kepada sesuatu perkhidmatan didokumenkan, bukan diteka.
- Satu kelayakan — sahkan dengan kunci API yang dihantar sebagai token Bearer, atau dengan
X-API-Keydaripada skrip atau pelayan. - Kunci berskop — berikan hanya skop yang diperlukan pemanggil, dengan
transcriptsdanbatchesmeliputi kerja pengekstrakan dan kelompok. - Ralat berstruktur — kegagalan pengekstrakan dan pengesahan memulangkan objek ralat dengan
codeyang stabil danmessageyang boleh dibaca; respons pengesahan (401) dan had kadar (429) menggunakan badan ralat rata yang lebih ringkas. - Had yang boleh diambil tindakan — permintaan yang terhad kadarnya memulangkan
429denganRetry-After, dan respons berjaya membawa pengepalaX-RateLimit-*supaya klien boleh berundur dengan betul. - Kontrak yang diterbitkan — dokumen OpenAPI penuh menyokong API ini, jadi anda boleh menjana klien, menyediakan pelayan mock, atau mengesahkan respons sebenar terhadap skema.
- Rakan sejawat untuk ejen — akaun dan alat yang sama boleh dicapai daripada pelayan MCP transcript.im jika pemanggil anda ialah klien AI dan bukan perkhidmatan.
Berkaitan
Soalan Lazim API Transkrip
Apakah API transcript.im?
API transcript.im ialah permukaan REST yang menukar pautan video atau audio awam menjadi transkrip bercap masa, menggunakan sari kata sedia ada dahulu dan transkripsi AI apabila video tiada sari kata.
Platform manakah yang disokong oleh API transcript.im?
Ia mengekstrak transkrip daripada YouTube, TikTok, Instagram, LinkedIn, dan Twitter/X dengan mengesan platform daripada pautan yang anda hantar. YouTube, TikTok, dan LinkedIn menggunakan sari kata dahulu dengan pengecaman pertuturan sebagai sandaran; Instagram dan X tiada trek sari kata dan terus menggunakan pengecaman pertuturan.
Apakah yang berlaku apabila video tiada sari kata?
Apabila video langsung tiada trek sari kata, API memulakan tugasan ASR dan memulangkan id tugasan; anda meninjau tugasan itu sehingga transkrip sedia, jadi permintaan tidak pernah tersekat pada pengecaman pertuturan.
Bolehkah saya mentranskripsi fail audio atau video setempat?
Ya. POST /v1/transcript menerima badan multipart/form-data dengan bahagian file dan bukan URL. Fail yang dimuat naik terus ke pengecaman pertuturan, jadi ia memulangkan tugasan 202 — atau hasil 200 jika ia selesai dalam belanjawan masa menunggu.
Bolehkah API transcript.im memulangkan cap masa bersama teks?
Ya. Respons JSON membawa segmen bercap masa dan respons teks boleh menyimpan awalan cap masa bagi setiap baris, jadi anda boleh melompat kembali ke saat sesuatu baris diucapkan.
Bagaimanakah saya meminta transkrip dalam bahasa tertentu?
Hantar senarai keutamaan bahasa yang dipisahkan koma, termasuk entri asr dan asr-<code>. Padanan sari kata dipulangkan terus; apabila sari kata wujud tetapi tiada yang sepadan dengan senarai, permintaan diteruskan ke transkripsi AI dan memulangkan tugasan 202, dan 404 dengan bahasa yang tersedia hanya dipulangkan apabila pengecaman pertuturan tidak dibenarkan.
Bagaimanakah saya tahu apabila transkrip tak segerak sudah sedia?
Tinjau GET /v1/transcript/job/{id} dengan kelayakan yang sama sehingga ia melaporkan berjaya atau gagal, atau langgan GET /v1/transcript/job/{id}/events untuk kemas kini yang dihantar pelayan. Pertanyaan tugasan memulangkan 200 walaupun tugasan gagal, jadi baca medan status dan error dan bukan kod HTTP.
Adakah API transcript.im menyokong pengekstrakan kelompok?
Ya. Kelompok menerima senarai URL, senarai main, atau saluran, menjejak status setiap item, dan memulangkan item satu halaman pada satu masa.
Format eksport manakah yang boleh saya muat turun?
Kelompok yang selesai dieksport sebagai txt, csv, json, srt, vtt, atau zip; satu transkrip yang disimpan dimuat turun sebagai txt, srt, vtt, json, atau md.
Di manakah transkrip yang disimpan berada?
Pustaka akaun ialah tempat transkrip yang disimpan dan rekod kelompok berada, di bawah /v1/library. Ia menyediakan laluan senarai, baca, muat turun, berkaitan, dan padam, dan pembacaannya berskop kepada akaun dan tidak pernah memulakan pengekstrakan baharu.
Apakah yang dipulangkan oleh titik akhir sari kata YouTube?
GET /v1/youtube/captions memulangkan metadata trek sari kata sesebuah video bersama teks sari kata. Ia tidak pernah memulakan tugasan pengecaman pertuturan; apabila ia melaporkan requiresAsync, panggil POST /v1/transcript untuk menjalankan transkripsi.
Bagaimanakah API transcript.im melaporkan ralat dan had kadar?
Ralat pengekstrakan dan pengesahan menggunakan objek dengan code dan message; pengesahan memulangkan 401 rata, dan had kadar memulangkan 429 rata dengan Retry-After serta pengepala X-RateLimit-* supaya klien boleh berundur dengan betul.
Tambah transkrip pada produk anda
Cipta kunci API, hantar pautan video atau fail setempat, dan baca transkrip semula sebagai JSON atau teks biasa.